「東京リージョンを選んだので国内です」は正しいか
主要なサービスでは、データを保存する場所とモデルが動く場所が別々に決まるため、多くの場合それだけでは足りません。
導入の審査では、情報システム部門や法務から「データは国内に置かれますか」と聞かれます。よくある答えは「東京リージョン(東京にあるデータセンター群)を選べます」ですが、「日本に保存」を選んでも処理は国外で行われることがよくあります。
処理の後にデータを何日残すかも別の約束で決まるため、この記事ではこの3つを分けて説明し、主要な5社の日本向けの選択肢を公式文書をもとに整理します。個人情報保護法上の扱いは、別の記事(生成AIに渡すデータはどこの国へ?保存先の確かめ方と個人情報保護法28条)で扱っています。
データの行き先は、3つの軸で決まる
確かめることは保存する地域、処理する地域、保持期間の3つで、それぞれが別の設定や契約で決まります。
軸 | 問い | 対象になるもの |
|---|---|---|
保存する地域 | 処理の後、どこに残るか | 会話の履歴、ファイル、検索用の文書、利用の記録 |
処理する地域 | モデルがどこで動くか | AIへの入力と出力(処理中は一時的に置かれる) |
保持期間 | 入力と出力をいつまで残すか | 不正利用や安全性を確かめるための記録 |
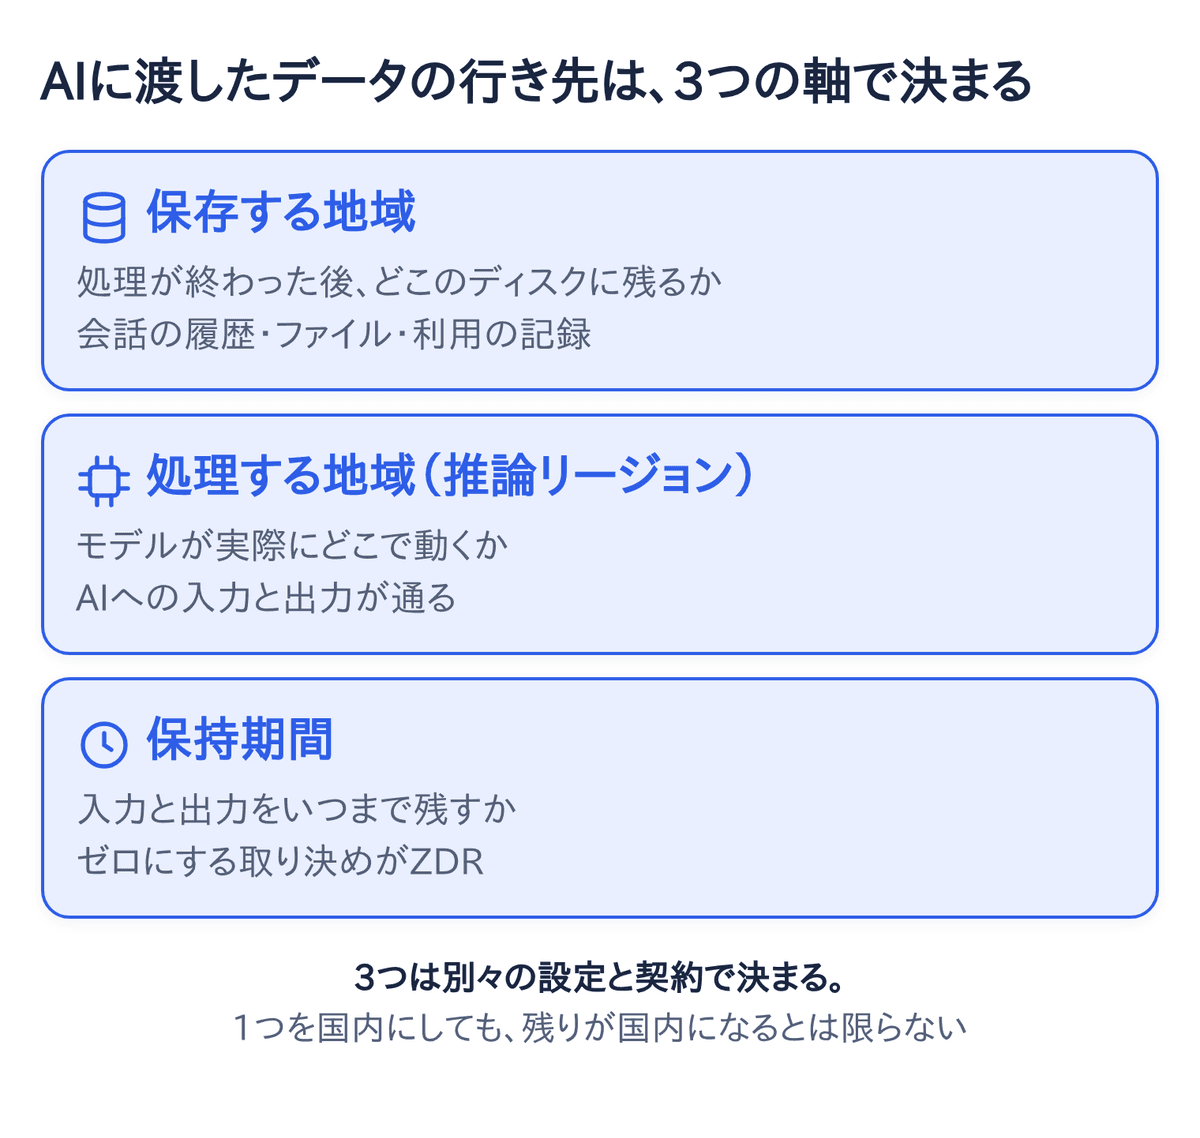
このうち「処理する地域」を、推論リージョンと呼びます。推論とは学習済みのモデルを動かして答えを出す段階(学習の対になる段階)のことで、リージョンはクラウドの提供元がデータセンターを置く地域の単位です。
保持期間をゼロにする取り決めがゼロデータリテンション(ZDR)で、各社の説明では、モデルが答えを返した後に入力と出力を保存しないことを指します。1つを国内にしても、残りの2つが国内になるとは限りません。
5社の日本向けの選択肢(2026年11月時点)
最新のモデルを、処理まで国内で使える経路はまだ限られています。各社の公式文書をもとに、開発者向けのAPI(プログラムから機能を呼び出すための窓口)の条件をまとめると次のとおりです。
提供元 | 日本に保存 | 日本で処理 | 既定の保持 | ZDRの受け方 |
|---|---|---|---|---|
OpenAI(開発者向けAPI) | できる | できない | 監視の記録を最大30日 | 申請して承認 |
Anthropic(Claudeの開発者向けAPI) | できない(米国のみ) | できない | 30日以内に削除 | 申請して承認 |
Google(Google Cloudの生成AI基盤) | できる | 一部のモデルだけ | モデルと契約による | 機能ごとの設定 |
AWS(Amazonのクラウドの生成AI基盤、Amazon Bedrock) | できる | できる(東京と大阪の間) | モデルによる | 設定(モデルによっては申請) |
Microsoft(クラウド Azure の生成AI基盤) | できる | 古いモデルだけ | 人が確かめる記録を残すことがある | 申請して承認 |
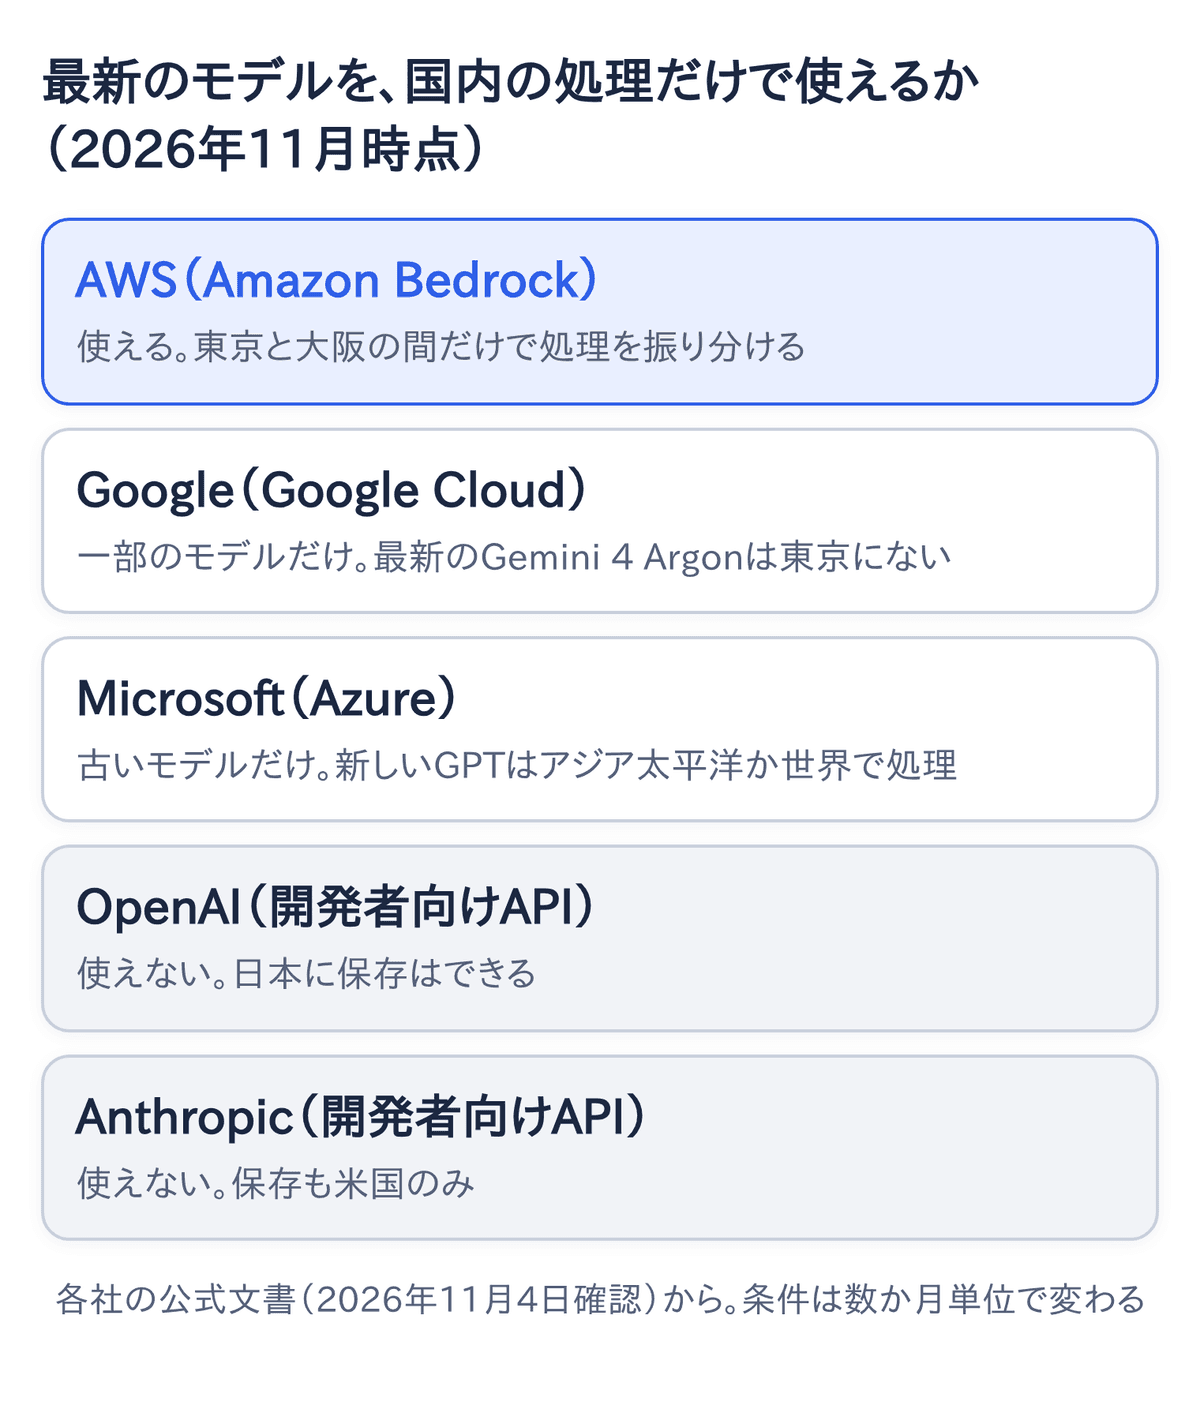
日本で処理できるのはAWSの日本向けの振り分けとGoogleの一部のモデルで、Microsoftも古いモデルなら日本で処理できます。なお、この表は開発者向けの窓口の話で、ChatGPTやClaudeの画面などのチャット製品は別の条件で決まります。
OpenAI:日本に保存できるが、処理は国外
OpenAIの開発者向けAPIは日本に保存できますが、日本では処理できません。日本専用の窓口もあるものの、そこで日本になるのは保存の場所です。米国以外の地域に保存するには承認が要り、その条件はZDRか、それに近い取り決めを受けることです。
既定では、不正利用の監視の記録を最大30日残します。ただし、ZDRを受けても、データを残す前提の機能は対象外です。たとえば、ファイルの保存やまとめて処理する機能(バッチ)、AIエージェント(AIが複数の手順を自動で進める仕組み)の途中経過を残す機能がこれにあたります。
Anthropic:日本の選択肢はなく、最上位モデルはZDRが使えない
Claudeの開発者向けAPIでは、処理する地域を「世界のどこか」か「米国のみ」から選び、米国のみを指定すると料金は1.1倍になります。保存は米国だけで、日本の選択肢はありません。
既定では、受け取りから30日以内に削除します。ZDRは申請して組織ごとに有効にする取り決めで、審査があるため誰でも受けられるわけではありません。最上位のモデルは30日の保持が利用の条件で、Anthropicが特に認めない限り、ZDRの下では使えません。
Google:東京で処理できるのは、一部のモデルだけ
Google Cloudの生成AI基盤ではリージョンを指定してモデルを呼び出すことができ、保存するデータは指定したリージョンに置かれます。ただし、東京で処理まで国内にとどめると約束しているのは一部のモデルだけで、最新のモデルはアジア太平洋ではシンガポールでしか提供されていません。
約束のあるモデルでも、一度に扱える入力の量が少ない版に限られるものがあり、大阪リージョンも提供地域の表に載っていません。世界のどこかで処理する窓口(グローバル)もありますが、Googleは「処理する地域の約束が要るなら使わないこと」と明記しています。
AWS:東京と大阪の間だけで処理できる
Amazon Bedrockでは、処理する地域の選び方が3つあります。
- 呼び出したリージョンだけで処理する
- 決めた地域の中で振り分ける(日本なら東京と大阪の間)
- 世界中のリージョンに振り分ける(日本向けなどより料金が約10%安い)
日本向けの振り分けなら最新のClaudeなどを処理まで国内で使えるので、5社の中で最も分かりやすい経路です。ただし、日本向けの振り分けに対応しているかは、モデルごとに確かめます。
保持は設定で選び、「保存しない」を選べば入力と出力を保存しません。この設定はリージョンごとなので、東京と大阪の両方で行います。例外として、最上位のClaudeの一部はAWSの担当者が入力と出力を確かめる設定にしないと使えず、その場合は最大30日保持されます。
Microsoft:最新モデルは、アジア太平洋か世界のどこかで処理
Azureの生成AI基盤では、モデルを使えるようにするときに配置の種類を選び、この種類で処理する地域が決まります。
- グローバル:世界のどこかで処理する
- データゾーン:決めた地域群の中で処理する(米国、欧州、アジア太平洋)
- リージョン:指定した国や地域の中で処理する
2026年10月時点で、東日本リージョンで国内処理できるのは古いモデルだけで、新しいGPTのモデルはグローバルかアジア太平洋のデータゾーンで使います。アジア太平洋のデータゾーンは日本とは限らず、アジア太平洋のいずれかの国で処理する、という意味です。一方で、保存するデータはどの種類を選んでも顧客が指定した地域に置かれますが、この点は次の節で見ます。
「処理は国外、保存は国内」でも、記録の置き場所は違う
処理は国外で保存は国内、という組み合わせは珍しくありませんが、保持される記録がどこに置かれるかは提供元ごとに違います。
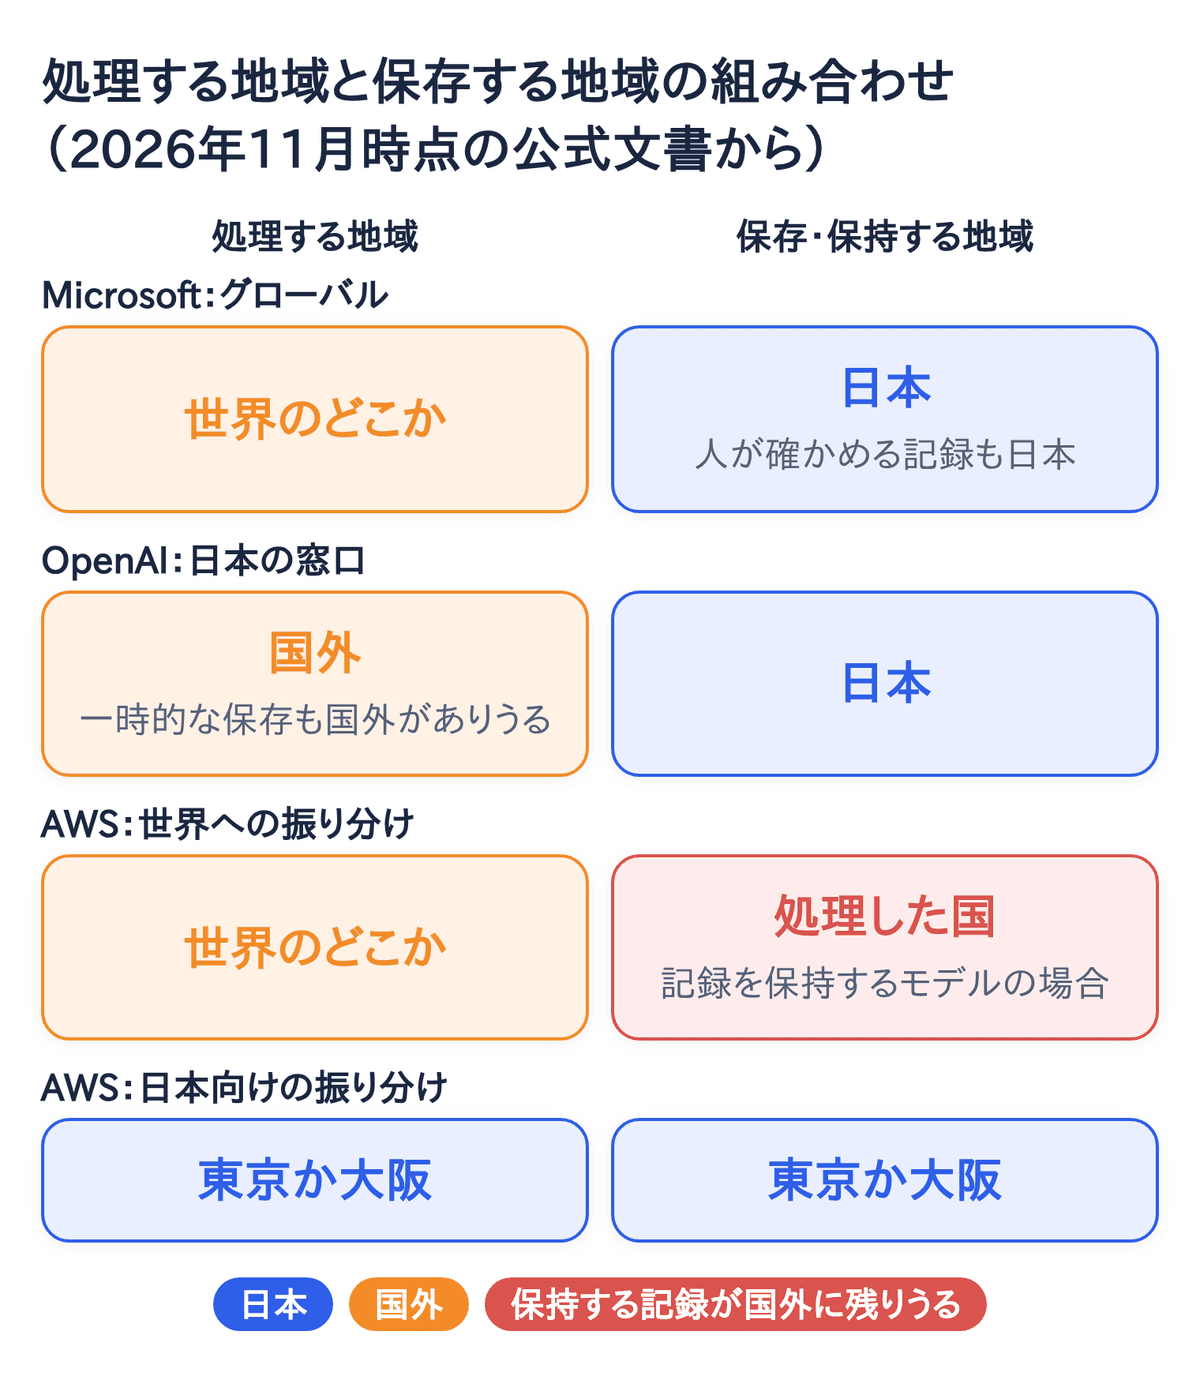
Microsoftは、どの配置の種類でも保存するデータは顧客が指定した地域に置くとし、人が確かめるための記録も同じ地域だと書いています。OpenAIの日本の窓口も保存は日本ですが、処理は国外で、その間の一時的な保存も国外でありうるとしています。
AWSは逆の例で、不正利用の検知のために保持する入力と出力は「処理を行ったリージョンに保存する」と書いています。そのため、記録を保持するモデルを世界中に振り分けると記録が国外に残ることがあり、日本向けの振り分けなら東京か大阪に置かれます。「保存は国内だから安心」とは一律には言えず、保持される記録の置き場所まで提供元ごとに確かめます。
ZDRには「申請する」ものと「設定する」ものがある
ZDRは、申請して承認を受ける型と設定で選ぶ型に分かれ、どちらにも対象外になる機能があります。
- 申請型:OpenAI、Anthropic、Microsoft(審査がある)
- 設定型:AWS(モデルによっては申請)、Google(記録を残す機能を1つずつオフ)
対象外になるのは、ファイルの保存やまとめて処理する機能、会話やAIエージェントの途中経過を残す機能などです。Googleでは検索結果を使った回答も対象外で、Google検索を使った回答のデータは最大3日保持し、止められないとしています。Anthropicは、ZDRの組織でも対象外の機能を使えばその部分はZDRの外になると書いており、システムが止めてくれるわけではありません。
ZDRが使えないモデルも出ており、AWSは最上位のClaudeの一部のZDRを、条件を満たす顧客に2026年12月31日までの期限付きで提供するとしています。さらにAnthropicは、利用規約の違反が疑われた会話を、ZDRでも最大2年保持しうるとしています。
源内基準は「処理の後に国外に残らないこと」を求めた
源内基準は、国外で処理するなら処理の後に国外に残らないことを契約で押さえる、という考え方を示しており、民間で最新のモデルを使うときの手本になります。
源内はデジタル庁が政府職員向けに用意したAI基盤で、源内基準はその運用基準として2026年10月に公表されました。原則は、推論とデータの保存を国内で行うことです。国内リージョンにない高度なモデルを使う場合に限って海外での推論を例外として認め、その条件を次の一文で定めています。
「推論処理の終了後に入力データ及び出力データが海外で保存されないことを調達契約で確保する」
これは、処理が国外になるなら保持期間と保存する地域を契約で押さえる、という意味です。あわせて、入力と出力を学習に使わないことも契約で確保するとしています。
民間でも、処理が国外になるのを受け入れるなら同じ考え方が使えます。処理の後に国外に残らないことを、契約と設定の両方で確かめます。
提供元に確かめること
- 保存:会話の履歴やファイルなどは、それぞれどの国に保存されるか
- 処理:使うモデルは、版まで含めてどの国で処理されるか
- 処理:混雑時などに指定外の地域へ流れないか。設定で禁止できるか
- 保持:既定で何日残すか。監視のための記録はどの国に置かれるか
- 保持:人が入力と出力を見ることはあるか。誰が、どの国から見るか
- ZDR:対象外の機能は何か。使いたいモデルが対象から外れていないか
- 契約:学習に使わないこと、処理の後に国外に残らないことを書けるか
推進担当が押さえる要点
- 保存・処理・保持は別々に決まる。1つを国内にしても、残りは国内にならない
- 最新モデルを国内の処理だけで使える経路は、2026年11月時点で限られる
- 「保存は国内」でも、保持される記録の置き場所は提供元ごとに違う
- ZDRには申請型と設定型があり、どちらにも対象外の機能やモデルがある
- 処理が国外なら、処理の後に国外に残らないことを契約で確かめる
まとめ
AIに渡したデータの行き先は保存する地域、処理する地域、保持期間の3つで決まり、提供元はそれぞれを別の設定や契約で扱っています。日本に保存できるサービスは多い一方、最新モデルを国内の処理だけで使える経路はまだ限られます。
そのため、最新モデルを使うなら、処理が国外になる前提で保持期間と記録の置き場所を押さえます。源内基準は、その押さえ方を「処理の後に国外に残らないことを契約で確保する」という形で示しています。各社の条件は変わるため、審査の記録には確認した日付と出典を残します。
関連記事
- 生成AIに渡すデータはどこの国へ?保存先の確かめ方と個人情報保護法28条:保存と処理の場所を、個人情報保護法の観点からどう判断するか
- デジタル庁「源内基準」が定めたAIエージェントの統制7項目を、民間の設計に読み替える:源内基準のほかの統制措置の読み方
- AIエージェントの導入審査をスムーズに通すには?推進担当の準備と選び方:審査で聞かれることの全体像
参考資料
- OpenAI「Data controls in the OpenAI platform」(https://developers.openai.com/api/docs/guides/your-data (2026年11月4日確認))
- Anthropic「Data residency」(https://platform.claude.com/docs/en/manage-claude/data-residency (2026年11月4日確認))
- Anthropic「API and data retention」(https://platform.claude.com/docs/en/manage-claude/api-and-data-retention (2026年11月4日確認))
- Anthropic「How long do you store my organization's data?」(2026年7月1日更新、https://privacy.claude.com/en/articles/7996866-how-long-do-you-store-my-organization-s-data (2026年11月4日確認))
- Google Cloud「Deployment and endpoint locations」(https://docs.cloud.google.com/vertex-ai/generative-ai/docs/learn/locations (2026年11月4日確認))
- Google Cloud「Data residency」(https://docs.cloud.google.com/vertex-ai/generative-ai/docs/learn/data-residency (2026年11月4日確認))
- Google Cloud「Data governance」(https://docs.cloud.google.com/vertex-ai/generative-ai/docs/data-governance (2026年11月4日確認))
- AWS「Increase throughput with cross-Region inference」(https://docs.aws.amazon.com/bedrock/latest/userguide/cross-region-inference.html (2026年11月4日確認))
- AWS「Data retention」(https://docs.aws.amazon.com/bedrock/latest/userguide/data-retention.html (2026年11月4日確認))
- AWS「Abuse detection」(https://docs.aws.amazon.com/bedrock/latest/userguide/abuse-detection.html (2026年11月4日確認))
- Microsoft Learn「Deployment types for Microsoft Foundry Models」(2026年8月6日、https://learn.microsoft.com/en-us/azure/foundry/foundry-models/concepts/deployment-types (2026年11月4日確認))
- Microsoft Learn「Region availability for Foundry Models sold by Azure」(2026年10月19日更新、https://learn.microsoft.com/en-us/azure/foundry/foundry-models/concepts/models-sold-directly-by-azure-region-availability (2026年11月4日確認))
- Microsoft Learn「Data, privacy, and security for Foundry Models sold by Azure」(2026年5月18日、https://learn.microsoft.com/en-us/azure/foundry/responsible-ai/openai/data-privacy (2026年11月4日確認))
- デジタル庁「ガバメントAI源内 ガバナンス・セキュリティ・セーフティに関する基準(源内基準)第1版」(2026年10月、https://www.digital.go.jp/assets/contents/node/basic_page/field_ref_resources/b033337d-dad1-4493-9316-d929597e4667/9bbaf559/20261020_policies_genai_guideline_02.pdf (2026年11月4日確認))
Askhubについて
Askhubは、日本の中堅・大企業がAIに業務を任せるための基盤です。業務の型(オントロジー)でAIに許す操作を定め、承認と判断ログで任せる範囲を広げながら、国産の基幹システムまで書き込めるようにします。導入はコンサルタントが伴走します。
この記事の言葉で言えば、Askhubは、国内リージョンに限った構成を含め、処理する地域と保存する地域を業務やデータの重さに応じて選べる基盤にあたります。
※Askhubのサービスに関する記載は、2026年11月時点の情報です。
自社の業務にAIエージェントをどう導入するか相談したい方は、お問い合わせからご連絡ください。
この記事を書いた人
この記事の内容について相談する
自社の業務でどう進めるか、相談したい方はこちらのフォームからご連絡ください。1〜2営業日以内に担当者よりご連絡します。