RAGの精度は、取り込む・探す・渡すの3段階で決まる
RAG(Retrieval-Augmented Generation、検索拡張生成)とは、質問に関係する文書を探して、AIへの入力に添えてから答えさせる仕組みです。AIが一度に読める量は増えましたが、会社全体の文書を扱うなら探す仕組みは今も要ります。
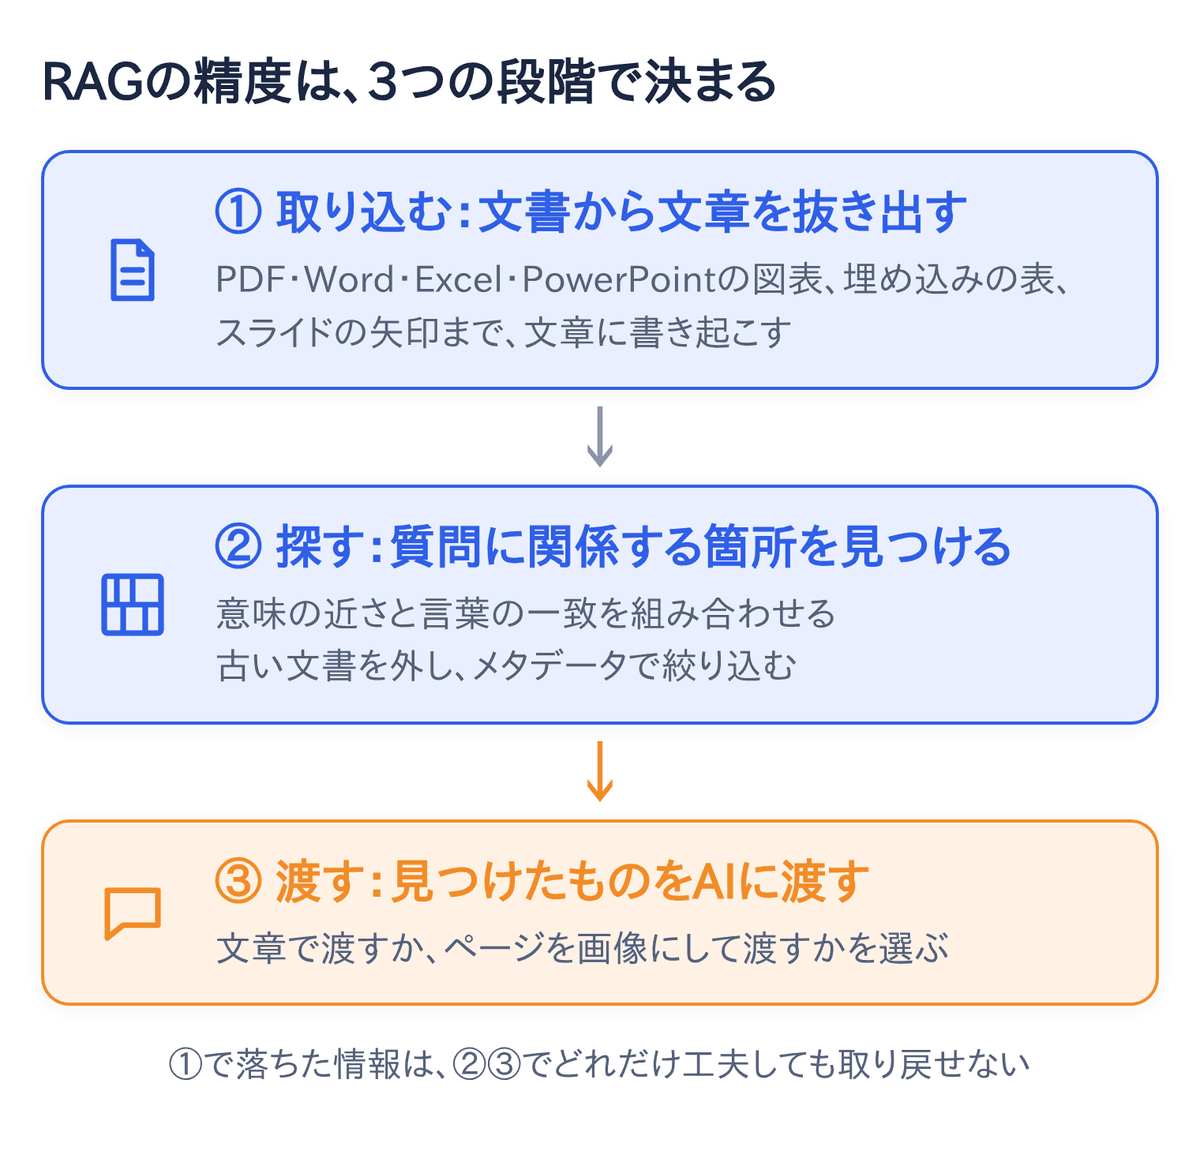
精度は、取り込む・探す・渡すの3段階で決まります。
社内でAIを使い始めると、「出張の日当はいくらか、経費規程をAIに答えさせたい」という相談が来ます。ChatGPTのような生成AIは、一般的な知識は持っていても、自社の規程は知りません。
そこで使われるRAG(ラグ)は、仕組みとしては単純です。それでも実際に入れてみると、「規程に書いてあるのに答えない」「古い規程で答える」といったことが起きます。
推進担当が押さえる要点
- RAGは、質問のたびに関係する文書を探してAIに渡す仕組み。整った規程のように数万トークン(トークンはAIが文章を数える単位)に収まる資料なら全部渡せば済むが、会社全体の文書のように入りきらない量を扱うなら、探す仕組みが要る
- 精度は、取り込む・探す・渡すの3段階で決まる。取り込む段階では、図表や埋め込みの表、スライドの矢印まで文章に書き起こす。丁寧にやるほど精度が上がる
- 探す段階では、意味の近さと言葉の一致を組み合わせ、古い版の文書を外す。渡す段階では、見た目で意味を表すものはページの画像で渡すことも選び、渡す量は今も絞る
- 閲覧権限は精度とは別の問題として、公開前に、見られないはずの人のアカウントで必ず確かめる
- 評価用の質問集を作り、人が直した答えを集めて育て続ける。私たちが支援してきた現場では、社内問い合わせなら最初は20〜30問を勧めることが多い
- AIエージェント(AIが自分で手順を選びながら仕事を進める仕組み)の時代でも、探すことは無くならない。RAGは、必要な情報を速く安く見つけるための手段の1つ
RAGとは:質問に関係する文書を探して、AIへの入力に添える仕組み
いま広く使われているのは、GPTやClaudeのようなモデル(大規模言語モデル)に、探した文書を入力として渡す形です。経費規程の例では、次の流れになります。
- 社員が「出張の日当はいくらですか」と質問する
- 仕組みが、社内の文書から質問に関係する箇所(経費規程の「出張旅費」の節など)を探す
- 見つけた箇所を質問と一緒にモデルに渡し、「この資料をもとに答えて」と頼む
- モデルが、渡された資料をもとに答え、どの文書を根拠にしたかを示す
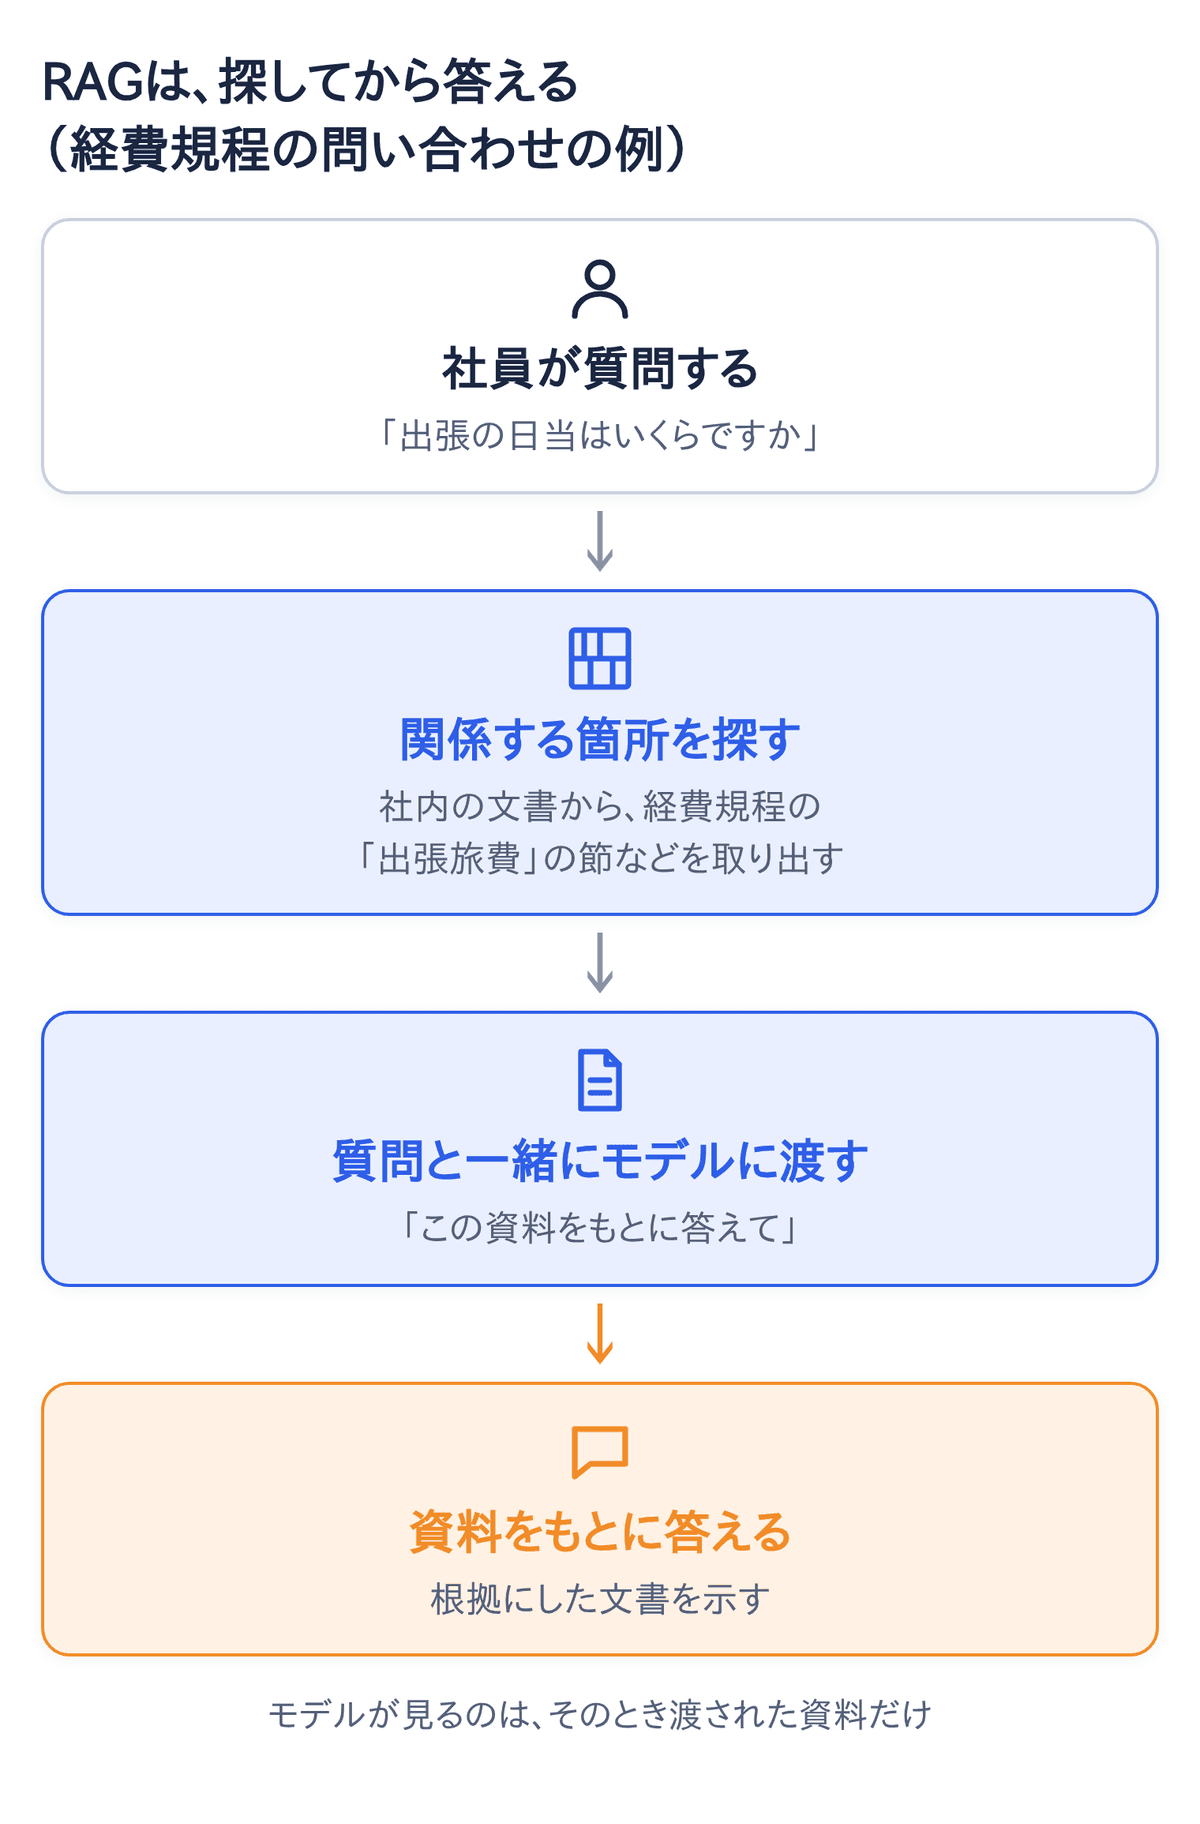
モデルは、そのとき渡された資料しか見ません。規程を改定したら、探す先の文書を新しい版に差し替えれば、モデルを学習し直さなくても答えが変わります。
補足:RAGは、Retrieval-Augmented Generation(検索拡張生成)の略です。2020年に、Facebook(現Meta)などの研究者が論文で名付けました。
AIが読める量は増えたが、入りきらない量の文書には探す仕組みが要る
AIが一度に読める量が大きく増えたいま、資料が少なければ、探さずに全部渡すほうが簡単で確実です。それでも、AIが一度に読める量を超える量の文書から答えさせるなら、探す仕組みが要ります。
RAGが広まった2023年の初めは、AIが一度に読める量(コンテキストウィンドウ)が小さい時代でした。2023年3月に出たGPT-4は8,192トークンです。トークンは、AIが文章を数える単位です。
料金も、入力100万トークンあたり30ドルと高価でした。たくさん渡すと、AIの注意が散って答えの質が落ちることも知られていました。
全部を渡せないので必要な箇所だけを探して渡す、というのがRAGの出発点です。
その前提は、大きく変わりました。
- 読める量:2026年11月時点で、主要なAIの会社の最新モデルは、どれも100万トークン前後を一度に読める
- 料金:2026年9月に出たOpenAIの軽量モデルGPT-6 Lunaは、入力100万トークンあたり0.10ドル
- 費用の下がり方:調査機関のEpoch AIは、同じ性能を出す費用が、2023年以降1年におよそ13分の1のペースで下がっていると推計している。ただし、推計には大きな留保が付くとも断っている
Anthropicは2024年9月の記事で、資料が20万トークン(英語で約500ページ)より少なければ、探さずに全部をモデルに渡してよいとしています。
ただし、読める量の上限まで渡せばよいわけではありません。Anthropicの資料も、入力が増えるほど正確さと思い出す力が落ちる、としています。新しいモデルほど落ち方は小さくなっていますが、無くなってはいません。
そこで私たちが支援してきた現場では、全部渡すのは、整った社内規程のように数万トークンに収まる資料までにしています。その範囲なら、AIはほぼ見落としなく答えます。
冒頭の経費規程の例も、規程だけを答えさせるなら、実はRAGは要りません。
RAGが要るのは、規程に加えて、手順書や過去の問い合わせ、議事録まで答えの根拠にしたくなったときです。
会社全体の文書となると、文書の数は数十万に及ぶことがあります。1文書が平均1万トークンでも、10万文書で10億トークンです。100万トークンの1,000倍で、とても一度には入りません。
方法 | 何をするか | 向く場面 |
|---|---|---|
全部渡す | 資料をまるごとモデルに渡す | 資料が数万トークン程度に収まり、全員が同じ資料を見てよい |
RAG | 質問のたびに関係する箇所を探して渡す | 文書が多く、一度に渡せる量や、渡して正確さを保てる量を超える |
ファインチューニング | 例を使ってモデルを追加で学習させる | 知識を足すのではなく、答え方や文体を変えたい |
精度は、取り込む・探す・渡すの3段階で決まる
RAGというと「探す」部分が注目されがちですが、精度は、その前後も含めた3つの段階で決まります。どの段階にも、工夫の余地があります。
- 取り込む:探す先のデータをどう作るか
- 探す:どう見つけるか
- 渡す:見つけたものをどんな形でAIに渡すか
取り込む:文書から、情報を落とさずに文章を抜き出す
文書から文章を抜き出す段階で情報が落ちると、後の段階でどれだけ工夫しても取り戻せません。検索は、元の文章があって初めて成り立ちます。ところが、探す先にしたい文書は、PDF、Word、Excel、PowerPointとさまざまです。
落ちやすいのは、見た目で意味を表している部分です。
文書 | 抜き出すと落ちるもの |
|---|---|
図表の入ったPDF | 表の行と列の関係や、グラフの中の数字が、ただの文字の並びになる |
PowerPointの「文字→矢印→文字」 | 文字だけを抜き出すと、矢印が表していた関係(原因と結果、手順の順番など)が消える |
Wordに埋め込まれたExcelの表 | 機械的な抜き出しでは、表ごと落ちることがある |
各社もこの問題を認めています。
提供元 | 示していること |
|---|---|
Google Cloud | 通常の文字の読み取り(OCR)は文書を平らにしてしまい、見出し・表・箇条書きのような意味を持つ構造を壊す |
AWS | 図・グラフ・表・画像を含む文書では、文字だけを出す既定の抜き出しではなく、AIを使った抜き出しを勧める |
Microsoftの検索サービス | 図や流れ図は文章に書き起こし、写真や画面の画像はそのまま扱う、という使い分け |
私たちが支援してきた現場では、この段階を機械任せにしません。たとえばPowerPointなら、画像も読めるAIにページごとに読ませます。図や矢印が表す内容まで分かりやすい文章に書き起こしてから、保存します。
Wordに埋め込まれた表は、一度PDFにして読み取らせるか、画面を撮ってAIに書き起こさせます。この下ごしらえは、丁寧にやるほど精度が上がります。
RAGでは、抜き出した文章を数百字から千字ほどの断片(チャンク)に切って保存します。私たちが大事にしているのは、見出しや段落といった文書の構造に沿って切ることです。
切り方の工夫はいろいろ提案されています。ただ、私たちの経験では、500字か1,000字かといった大きさの調整や凝った手法は、決め手になりません。
NVIDIAの2025年の比較でも、切り方による答えの正確さの差は、複数のデータで平均すると数ポイントでした。極端に大きく切るのは論外です。
探す:意味の近さと、言葉の一致を組み合わせる
探すときは、2つの探し方を組み合わせる「ハイブリッド検索」か、質問に応じて使い分ける仕組みが要ります。意味の近さで探す方法(ベクトル検索)と、言葉の一致で探す方法(キーワード検索)には、どちらにも得意と不得意があるからです。
たとえば「田中さん」と「佐藤さん」は、意味の近さで見れば、どちらも日本人の名字なのでかなり近くなります。田中さんの情報が欲しいときに佐藤さんの情報が混ざっては困るなら、言葉の一致で探すしかありません。
Microsoftの資料も、製品の型番、専門用語、日付、人の名前は、言葉の一致で探すほうがうまくいくとしています。反対に、「有給休暇」と聞かれて規程の「年次休暇」を見つけるのは、意味の近さで探すほうが得意です。
Microsoftが顧客企業のデータで比べた結果では、検索の質を表す指標は次のとおりでした。
探し方 | 検索の質を表す指標 |
|---|---|
言葉の一致だけ | 40.6 |
意味の近さだけ | 43.8 |
両方を組み合わせる | 48.4 |
組み合わせに、結果の並べ替えを加える | 60.1 |
言葉の一致で探すなら、社内の略語や旧称を言い換えの一覧に登録しておくと、見落としが減ります。
探す先に古い文書が混ざらないことも重要です。
改定前の経費規程と改定後の規程が両方残っていれば、仕組みはどちらも探し出します。そしてモデルは、どちらが新しいかを知りません。更新のある文書を扱うなら、古い版を探す先から外す手順を決めておきます。
文書が大量にあるなら、部署や更新日といった付帯情報(メタデータ)で先に絞り込み、その中で探す工夫も効きます。
渡す:図やスライドは、ページの画像で渡すことも選ぶ
図やスライドのように、見た目で意味を表しているものは、ページの画像で渡すほうがよい場合があります。取り込む段階で文章に書き起こしていても、書き起こしで落ちる情報は残るからです。
その場合は、見つけた後に元のページを画像にして、画像を読めるAIに渡します。
ClaudeのAPI(プログラムから機能を呼び出す窓口)は、PDFを受け取ると、ページごとの画像と文章の両方をモデルに渡します。
OpenAIも、PDFは文章とページの画像の両方を渡す一方、WordやPowerPointは文章しか抜き出さないとしています。図の中身を保ちたいなら、先にPDFに変換するよう勧めています。
渡す量も、今も絞るに越したことはありません。関係の薄い資料まで渡すと、必要な情報が埋もれます。モデルが賢くなるほどこの問題は小さくなっていますが、無くなってはいません。
閲覧権限は、精度とは別に必ず確かめる
閲覧権限は、精度の問題ではありませんが、RAGを社内に公開する前に必ず確かめることです。閲覧権限を反映しない作りのRAGでは、本来見られない人に、見えてはいけない内容が答えとして出るおそれがあります。
権限を反映する仕組みでも、共有の設定が緩い文書(全社に公開されたフォルダなど)があれば、それも答えに出てきます。
設定の緩さは、そのまま答えの緩さになります。
たとえば、インターセクトが提供するAskhubでは、Google DriveやOneDriveと同期した文書は、元のフォルダの閲覧権限を引き継ぎます。そのため、フォルダの共有設定がそのまま答えの範囲になります。
ほかのRAGの製品や、ファイル共有の製品が用意する検索でも、権限を引き継ぐかどうかは製品ごとに違います。どの方法でも、公開前に、見られないはずの人のアカウントで試します。
導入前に推進担当が整えること
1. 対象の文書を決める
最初から全社の文書を対象にせず、問い合わせが多く、正解がはっきりしている文書から始めます。規程のように全部渡せる量の文書だけで始めるなら、まずは全部渡す方法で十分です。RAGの設計が効いてくるのは、対象を広げてからです。
文書の棚卸しがどれだけ大変かは、対象次第です。
- 社内規程のように整備された文書:ほとんど手間はかからない
- 過去の図面のように量が多くても、整理されている文書:それほど時間はかからない
- 版が乱立していたり、置き場所がばらばらだったりする文書:手間がかかる
2. 抜き出しの確認
代表的な文書を何点か選び、元の文書と、抜き出された文章を見比べます。表、図、埋め込みの中身まで、全部が文章になっているかを確かめます。落ちていれば、その種類の文書は抜き出し方を変えます。
3. 評価用の質問集と、評価を続ける仕組み
実際の問い合わせから、質問と、正しい答え、根拠になる文書の組を用意します。私たちが支援してきた現場では、社内問い合わせなら最初は20〜30問を勧めることが多いです。これで全部の質問を網羅できるわけではありません。
ただ、多すぎると評価のたびにAIの利用料がかさみます。過去の問い合わせの記録が無い会社では、作る手間もかかります。Anthropicも2026年の記事で、20〜50件の課題で始めるのが良い出発点だとしています。
質問集には、次のような質問を混ぜます。
- 社員がふだん使う言い回しのままの質問
- 改定があった項目の質問
- 資料に答えが無い質問
デジタル庁の手引きにならい、適切な文書を取り出せたかと、答えがその文書に沿っているかを分けて採点します。分けておくと、うまくいかないときに、探す段階と答える段階のどちらに原因があるかが分かります。
評価は1回で終わらせず、続けられる仕組みにします。たとえば、AIの答えを人が確認してから返す運用なら、人が書き直した答えを集めておきます。それを、次からの正解として使います。
OpenAIも、運用の記録から評価の材料を集め、評価の質問集を育て続けるよう勧めています。Anthropicも、実際の失敗から課題を集めるよう勧めています。
4. 出典の表示と「分からない」の扱い
答えにどの文書を使ったかを表示させ、資料に書いていないことは「分からない」と答えさせます。社員が根拠を確かめられ、誤りに気付きやすくなります。
5. 製品を比べるときに確かめること
製品を比べるときは、3で作った質問集で同じように試すほかに、次を確かめます。
- 図表や埋め込みの表、スライドの図を、文章に書き起こして取り込めるか
- 意味の近さと言葉の一致を組み合わせて探せるか
- 閲覧権限は、探す前に利用者が見られる範囲へ絞るか
- 元の文書を改定してから、答えに反映されるまでどのくらいかかるか
- 出典を文書名だけでなく、ページや節まで示すか
「RAGはもう古い」か:エージェントになっても、探すことは無くならない
エージェントになっても、探すことそのものは無くなりません。
最近、「RAGはもう古い、AIエージェントが自分で探せばいい」という声を聞きます。私たちは、何をRAGと呼ぶかで答えが変わると考えています。
「1回だけ探して、すぐ答える」仕組みだけをRAGと呼ぶなら、この声には一理あります。AIエージェントは、探した結果を見て、足りなければ言葉を変えて探し直せるからです。
ただ、探して、足りなければ探し直すことを繰り返すやり方も、エージェント型のRAG(エージェンティックRAG)と呼ばれます。私たちは、これもRAGだと考えています。ウェブを調べて報告をまとめるAIの機能も、検索を何度も繰り返しています。
探す必要が無くなるのは、世界のすべての情報がAIに一度に渡せるようになったときで、それはまだ先です。
変わるのは、エージェントが探すときに使う「探し方」の選び方です。よく例に挙がるのが、Anthropicのプログラミング支援エージェントClaude Codeです。
初期はベクトル検索を使っていましたが、今はファイルの場所や中の文字列を、エージェントが自分で繰り返し探す方法に切り替えています。開発者は、こちらの方がはるかに良かった一方、そのぶん時間とトークンがかかるとも話しています。
ただし、これはプログラムのコードを探す場面の話です。置き場所も書き方もばらばらな社内の文書に、そのまま当てはまるわけではありません。
コードは、フォルダの構造がきちんと整理されたリポジトリ(コードの保管場所)の中にあり、中身も厳密な文法で書かれています。だから、ファイルの場所や決まった文字列から直接たどる方が効率が良かったのです。
私たちは、探し方の違いは、必要な情報をどれだけ速く、どれだけ安く見つけられるかの違いだと考えています。
- フォルダや文書の名前がきれいに整理されている:それを手がかりに探せばよい
- 整理されていない:意味の近さや言葉の一致で探すほうが早く見つかる
RAGの検索は、そのための有力な手段の1つです。Anthropicも、エージェントの作り方の記事で、2つの組み合わせが最も効果的になりうる、としています。事前に探せるようにしておく方法と、必要なときにファイルを探す方法です。
だからこそ、本当に大量の文書を扱うときは、RAGの設計は今も大事です。メタデータで絞り込めるようにし、その中で探すといった工夫は、エージェントの時代でも意味を持ち続けます。
まとめ:RAGの精度は、探す前と後でも決まる
RAGは、質問に関係する文書を探してAIに渡し、それをもとに答えさせる仕組みです。AIが一度に読める量は増えましたが、会社全体の文書を扱うなら、探す仕組みは今も要ります。
精度は、文書から情報を落とさずに取り込むこと、適切な方法で探すこと、見つけたものを適切な形で渡すことの3段階で決まります。
最初は問い合わせが多く正解がはっきりした文書から始め、抜き出しを確かめ、評価を続けながら育てていきます。
関連記事
- コンテキストエンジニアリングとは?AIに何を渡すかで答えの質が決まる 〜AIハーネス入門 第2回〜:AIに渡す情報の全体と、渡せる量の上限、増えるほど見落とす理由
- AIエージェントの権限管理:誰の権限で動くか、ID・代理実行・社内検索の落とし穴:社内検索でAIが見てよい範囲を、誰の権限で決めるか
- Copilot Studioとは?料金・ライセンスの仕組みと見積もり方、できること:社内文書を参照するエージェントを作るときのナレッジと費用
参考資料
- Patrick Lewis ほか「Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks」(2020年5月、https://arxiv.org/abs/2005.11401 (2026年11月11日確認))
- OpenAI「GPT-4」モデルの説明(https://developers.openai.com/api/docs/models/gpt-4 (2026年11月11日確認))
- OpenAI「GPT-6 Luna」モデルの説明(https://developers.openai.com/api/docs/models/gpt-6-luna (2026年11月11日確認))
- Anthropic「Context windows」(https://platform.claude.com/docs/en/build-with-claude/context-windows (2026年11月11日確認))
- Epoch AI「The plunging price of thought」(2026年9月、https://epoch.ai/publications/the-plunging-price-of-thought (2026年11月11日確認))
- Anthropic「Introducing Contextual Retrieval」(2024年9月、https://www.anthropic.com/news/contextual-retrieval (2026年11月11日確認))
- Google Cloud「Process documents with Gemini layout parser」(https://cloud.google.com/document-ai/docs/layout-parse-chunk (2026年11月11日確認))
- AWS「Parsing options for your data source」(Amazon Bedrock Knowledge Bases、https://docs.aws.amazon.com/bedrock/latest/userguide/kb-advanced-parsing.html (2026年11月11日確認))
- Microsoft Learn「Hybrid search using vectors and full text in Azure AI Search」(https://learn.microsoft.com/en-us/azure/search/hybrid-search-overview (2026年11月11日確認))
- Microsoft「Azure AI Search: Outperforming vector search with hybrid retrieval and reranking」(2023年9月、https://techcommunity.microsoft.com/t5/azure-ai-foundry-blog/azure-ai-search-outperforming-vector-search-with-hybrid/ba-p/3929167 (2026年11月11日確認))
- Anthropic「PDF support」(https://platform.claude.com/docs/en/build-with-claude/pdf-support (2026年11月11日確認))
- OpenAI「File inputs」(https://developers.openai.com/api/docs/guides/pdf-files (2026年11月11日確認))
- Microsoft Learn「Multimodal search in Azure AI Search」(https://learn.microsoft.com/en-us/azure/search/multimodal-search-overview (2026年11月11日確認))
- NVIDIA「Finding the Best Chunking Strategy for Accurate AI Responses」(2025年6月、https://developer.nvidia.com/blog/finding-the-best-chunking-strategy-for-accurate-ai-responses/ (2026年11月11日確認))
- Anthropic「Demystifying evals for AI agents」(2026年1月、https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents (2026年11月11日確認))
- OpenAI「Evaluation best practices」(https://developers.openai.com/api/docs/guides/evaluation-best-practices (2026年11月11日確認))
- デジタル庁「テキスト生成AI利活用におけるリスクへの対策ガイドブック(α版)」(2024年6月、https://www.digital.go.jp/resources/generalitve-ai-guidebook (2026年11月11日確認))
- Latent Space「Claude Code: Anthropic's Agent in Your Terminal」(2025年5月、https://www.latent.space/p/claude-code (2026年11月11日確認))
- Anthropic「Effective context engineering for AI agents」(2025年9月、https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents (2026年11月11日確認))
Askhubについて
Askhubは、日本の中堅・大企業がAIに業務を任せるための基盤です。業務の型(オントロジー)でAIに許す操作を定め、承認を挟みながら任せる範囲を広げ、国産の基幹システムまで書き込めるようにします。導入はコンサルタントが伴走します。
この記事の言葉で言えば、Askhubは、取り込む段階と探す段階を受け持つ仕組みを持っています。図面や帳票も文字と表の構造を保ったまま読み取り、言葉の一致と意味の近さを組み合わせて探します。Google DriveやOneDriveと同期した文書は、元のフォルダの閲覧権限を引き継ぎます。
※Askhubのサービスに関する記載は、2026年11月時点の情報です。
この記事の内容について相談する
自社の業務にAIエージェントをどう導入するか相談したい方は、こちらのフォームからご連絡ください。1〜2営業日以内に担当者よりご連絡します。
この記事を書いた人