渡す量と答えの質は、比例しない
社内の資料をまとめてAIに渡したら、答えがかえって雑になった。AIエージェントを試し始めた方から、ときどき聞く話です。
渡す量と答えの質は比例しません。ある点を超えると、渡すほど悪くなります。なぜそうなるのかは、AIが何を見て答えているかを知ると、はっきりします。
前回、モデルは毎回「そのとき渡された文字列」だけを見て答える、と書きました。渡された文字列のまとまりを「コンテキスト」と呼び、AIに渡された書類にたとえました。
この記事では、その書類を解剖します。何が入っているのか。誰が入れているのか。どんな限界があるのか。
この記事は、AIハーネス入門シリーズ(全4回)の第2回です。シリーズの一覧はこちら。
まずは、書類の3つの区分から見ていきます。
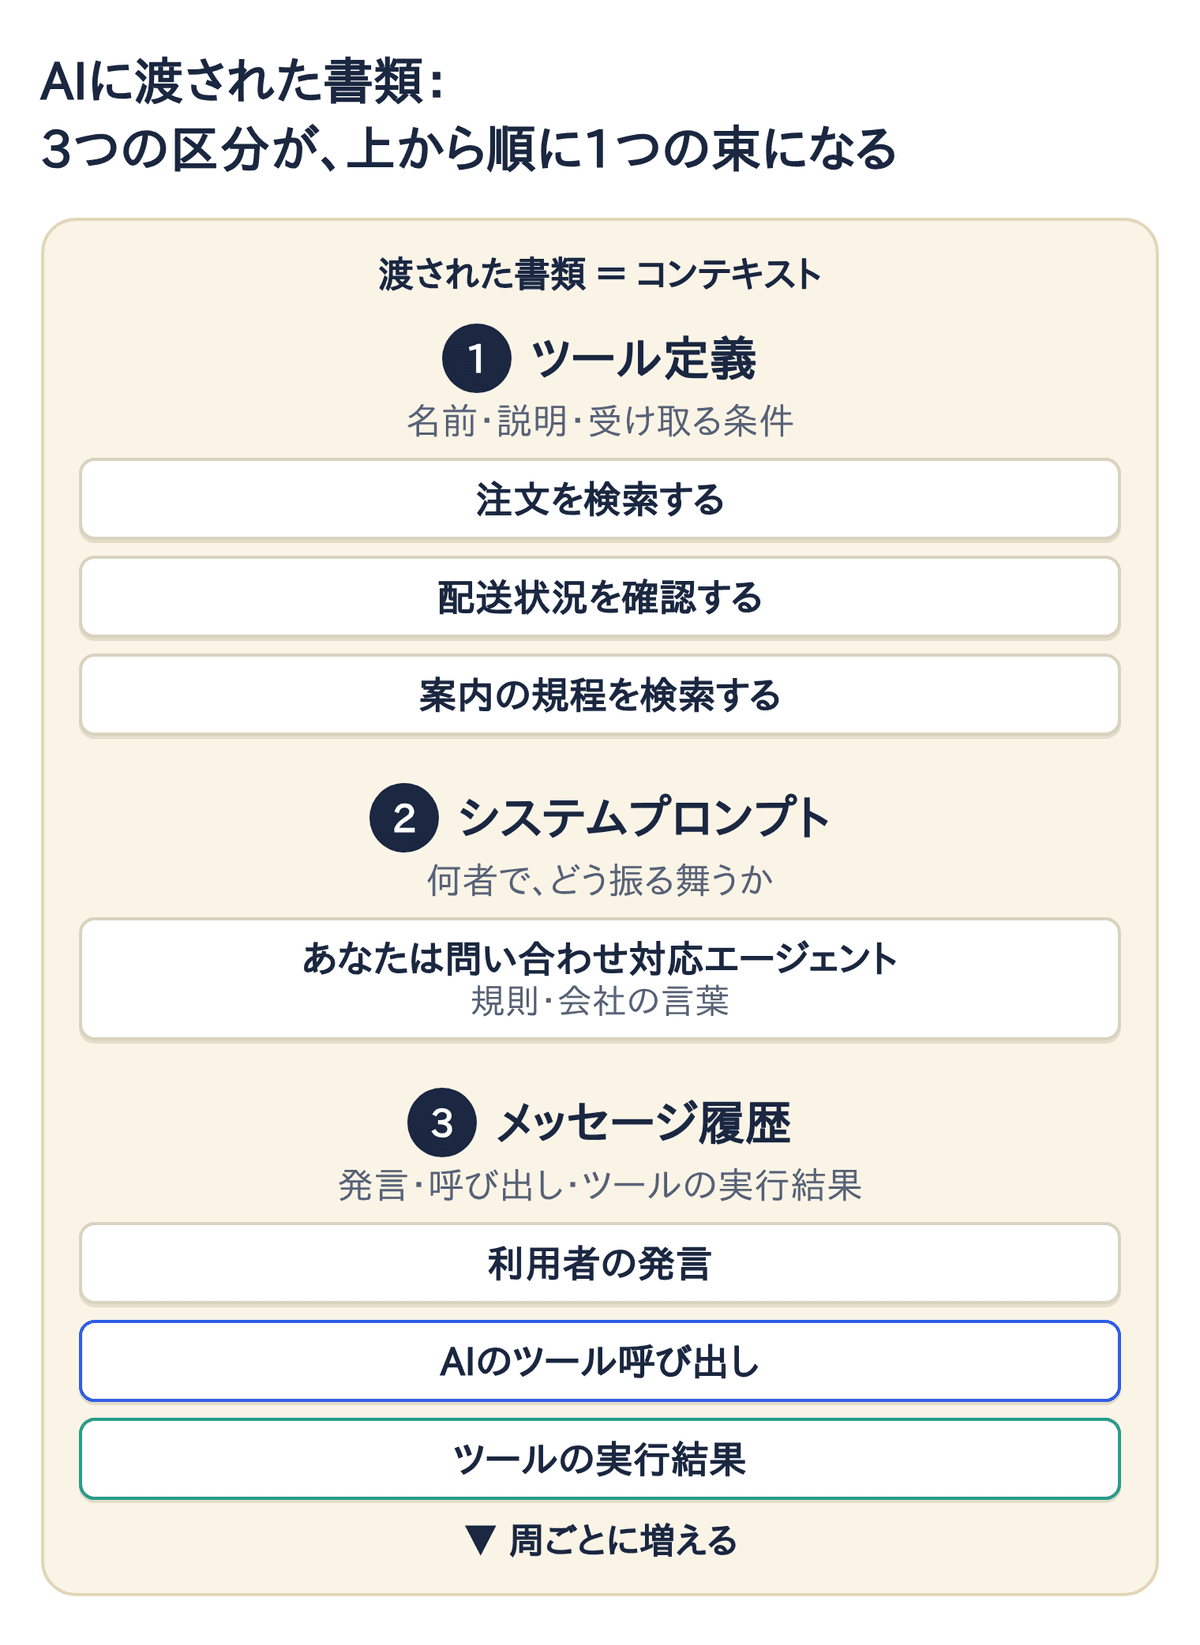
渡された書類は、3つの区分に分かれている
ハーネスがモデルに文字列を渡すとき、1本の長い文字列をただ渡しているわけではありません。モデルのAPI(プログラムからモデルを呼び出す接続口)には、入力の区分が3つあります。コンテキストとは、この3つを合わせた入力の全体のことです。
区分 | 何を入れるか | 書類の束にたとえると |
|---|---|---|
ツール定義 | 使えるツールの名前、説明、受け取る条件(呼び出すときに渡す項目。検索条件など) | 束の一番上にあるツール一覧表 |
システムプロンプト | 「あなたは何者で、どう振る舞うか」という指示 | その次に綴じられた業務マニュアル |
メッセージ履歴(会話履歴) | 利用者の発言、AIの返答、ツール呼び出しとその結果 | その下に積まれていく書類の山 |
前回、渡された書類は1つにつながった文字列で、並び順に意味がある、と書きました。ここではその文字列を、上から順に積まれた1つの束として見ます。束の上から、ツール定義、システムプロンプト、メッセージ履歴、の順に積まれます(モデルのAPIの仕様でも、tools・system・messagesという名前でこの順に並びます)。この順番の意味は、あとの節で説明します。
3つの区分に何を入れるかを決めているのが、ハーネスです。
このうち、システムプロンプトには見落としやすい構造があります。
システムプロンプトには、2つの層がある
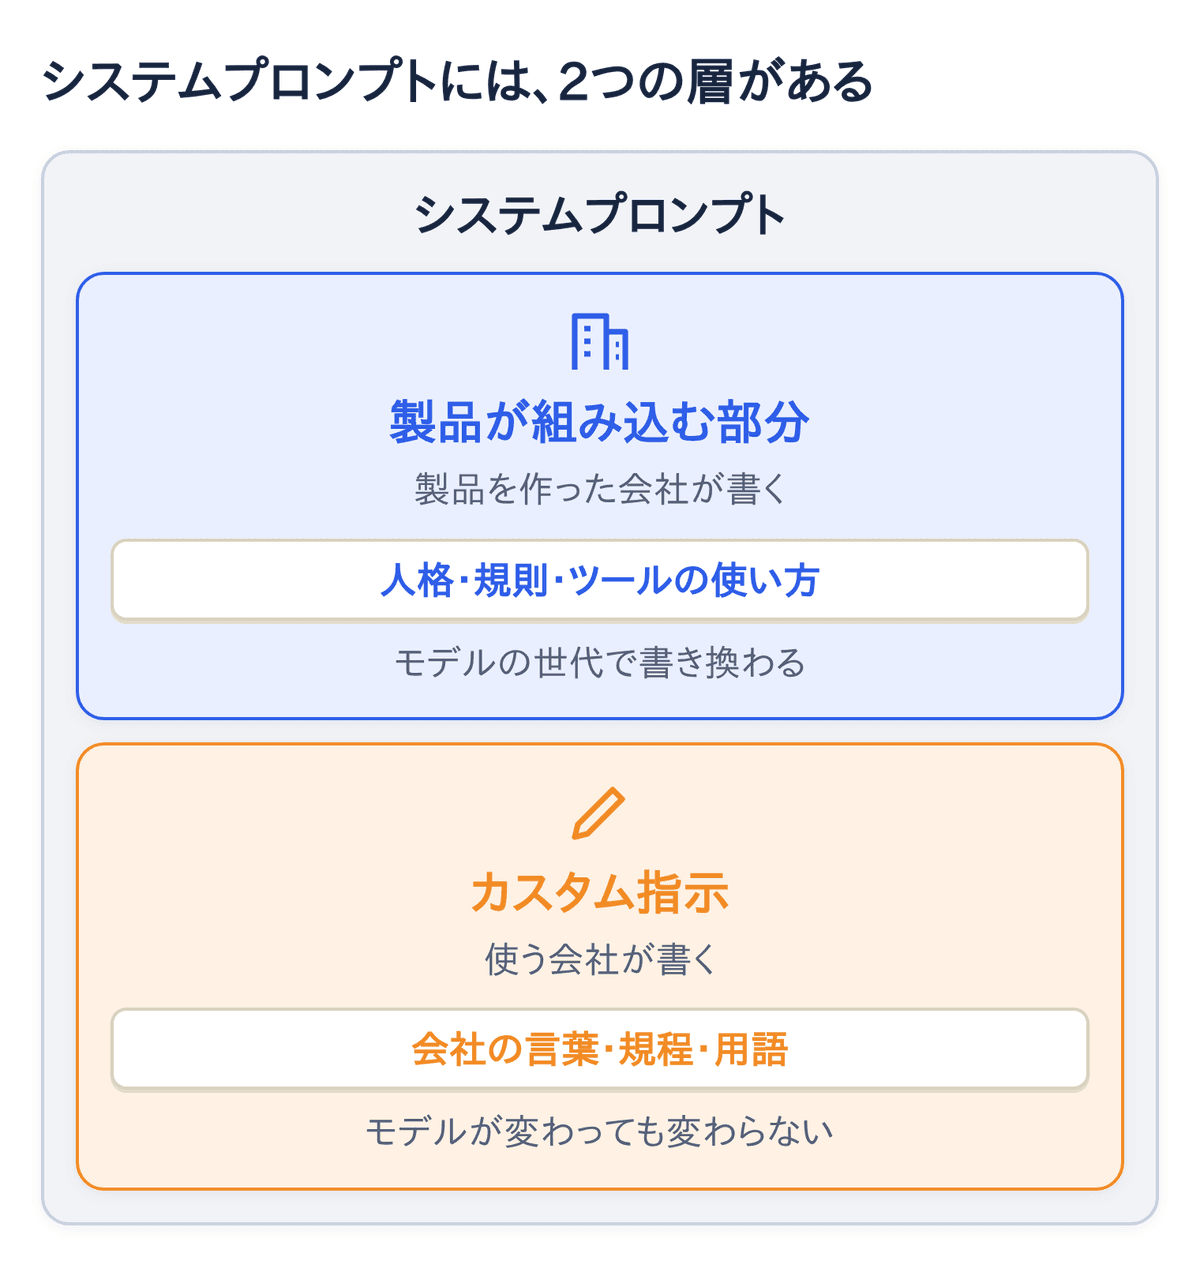
システムプロンプトは、1人の書き手が書いた1枚の紙ではありません。2つの層が重なっています。
1つは、製品を作った会社が組み込む部分です。「あなたは何々のエージェントです」という役割、守るべき規則、ツールの使い方のコツ、口調。利用者からは見えませんが、どのエージェント製品にも入っています。
もう1つは、利用者が書く部分です。「お届け予定日は、配送会社の最新の見込みで答える」「返金の案内は、担当者が確認してから」。使う側が自分の言葉で足す部分です。このシリーズでは、この部分を「カスタム指示」と呼びます(製品によって CLAUDE.md、AGENTS.md、カスタムインストラクションなど、名前は違います)。
Claude Code(Anthropicのプログラミング支援エージェント)を例に見ます。カスタム指示はCLAUDE.mdという名前で、会社全体・使う人ごと・案件ごとの3つの階層に置けます。ハーネスが起動時にこれらを集め、システムプロンプトの後半に差し込みます。製品が組み込む部分は、製品を作ったAnthropicが書いて管理しています。
指示どうしが食い違ったときにどれを優先するかを、明文化している製品もあります。共通しているのは1点です。検索結果や取り込んだ文書など「外部から来たデータ」の中に書かれた指示は、製品の指示よりもカスタム指示よりも低い優先度に置く、というものです。取り込んだ文書の中に紛れ込んだ文章を、AIが従うべき命令として読まないようにするためです。
2つの部分には、性質の違いがあります。
製品が組み込む部分は、モデルの世代が変わると書き換わります。たとえばCodex(OpenAIのプログラミング支援エージェント)は、モデルの世代ごとに別のシステムプロンプトを用意し、製品本体には組み込まず、サーバーから受け取る形にしています。モデルが新しくなったとき、製品本体を更新せずにシステムプロンプトだけを差し替えられるようにするためです。
カスタム指示は、使う会社の業務のルールとして書かれます。モデルが変わっても、「返金の案内は担当者が確認してから」というルールは変わりません。
この違いは、第4回で「誰が何を担うか」を考えるときの出発点になります。
次に、束の下に積まれていく書類の山を見ます。
メッセージ履歴には、ツールの実行結果も入る
前回、モデル自身は記憶を持たない、と書きました。記憶を持たないモデルに、ハーネスが代わりに記憶を持たせます。持たせる記憶には短期と長期の2種類があり、短期記憶にあたるのがメッセージ履歴(会話履歴)です。
ここには、利用者の発言とAIの返答だけでなく、ツール呼び出しと、その結果も入ります。
前回の問い合わせ対応エージェントを思い出してください。モデルが「注文を検索する」というツール呼び出しを出力し、ハーネスが検索して結果を返す。この「モデルが出力した呼び出し」と「返ってきた結果」の両方が、メッセージ履歴に追加されます。次にモデルを呼ぶとき、モデルが見るのは、それらを含めたメッセージ履歴の全体です。
つまり、ループが1周するたびに、渡す書類は増えます。
これが、短期記憶にあたります。今のやり取りの中で起きたことは、全部ここにあります。ハーネスが何もしなければ、どこまでも積み上がります。
一方で、書類に入れきれない記憶もあります。
長期記憶は書類の外に置き、必要な分だけ渡す
配送が遅れたときの案内の規程、A社との過去のやり取り、商品ごとの納期の目安。こうした情報は、毎回書類に全部入れるには多すぎます。
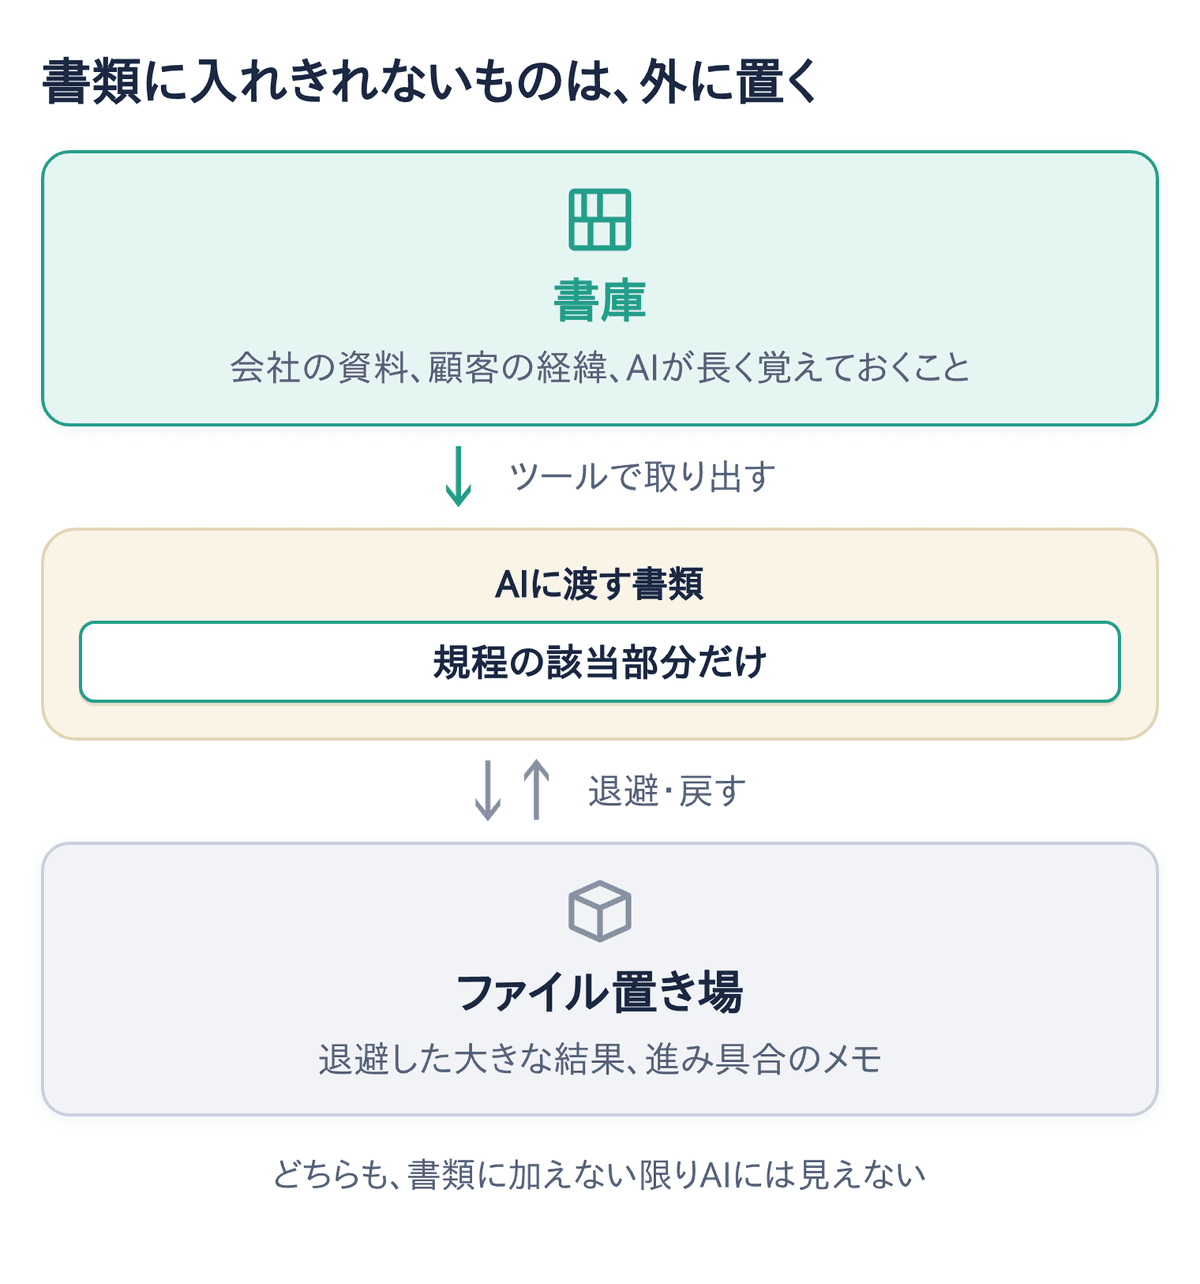
そこで、書類の外に置きます。これが長期記憶です。外には、役割の違う場所が2つあります。1つは「書庫」で、会社の資料と、AIが仕事の中で学んで次回も使うことを置きます。実体は、ナレッジベースやデータベース、文書の検索システムです。もう1つは「ファイル置き場」で、今の作業で出た大きな結果や進み具合のメモを、作業の間だけ置きます。実体は、作業用のファイルの保存先です。どちらも渡された書類ではないので、取り出して書類に加えない限りAIには見えません。
書庫から取り出すには、前回の記事で説明したツール呼び出しを使います。モデルが「案内の規程を検索する」というツールを呼び、ハーネスが書庫から該当部分を探し、結果をメッセージ履歴に追加する。「社内文書を検索してAIに答えさせる」仕組み(RAG、検索拡張生成と呼ばれます)も、構造はこれです。
書庫は、「ベクトルデータベース」(文章を数値の並びに変えて保存し、意味の近いものを探せるようにした専用のデータベース)である必要はありません。普通のデータベースでも、文書の検索システムでも、ツールで該当部分を探して書類に加えるという仕組みは同じです。プログラミング支援の主要な製品を見ても、プログラムを探すのに専用の仕組みを使っているものはなく、通常の文字列検索で済ませています。どの仕組みで書庫を作るかは、AIに何を探させたいかが決まってから、それに合わせて選ぶものです。
書庫の準備は、2つのことから始める
推進担当の目線で、書庫に手を付けるなら、最初にやることは2つです。
1つ目。規程やマニュアルを、検索で引ける単位に切っておく。1件1トピック、が目安です。
2つ目。それぞれに、部署・改定日・対象製品のような「引く手がかり」を付けておく。この手がかりが、次の節で見る「ツールを呼ぶときに指定できる検索条件」になります。
書庫に置くものには、会社の資料のほかに、もう1つ種類があります。AIが仕事の中で学んだことを、次回のために書き残す記憶です。「A社への返信は、担当のBさんにも写しを送る」「この商品は月末に注文が集中する」。
今、製品ごとの作りの違いが一番大きいのが、この「書き残す記憶」です。主要な製品を見渡すと、4つの方式が並んでいます。
方式 | 誰が書き、誰が確かめるか |
|---|---|
AIが自分で整理する | 別のAIが過去のやり取りから学びを抜き出し、記憶を自動で更新する |
人が確かめてから残す | AIが学びの候補を人が確認する一覧に入れ、人が中身を見て採用するものだけ残す |
文字数に上限を置く | AIが直接書くが、決まった短さに収める |
使う直前に思い出す | 返答の直前に、別のAIが関係する記憶を探して書類に加える |
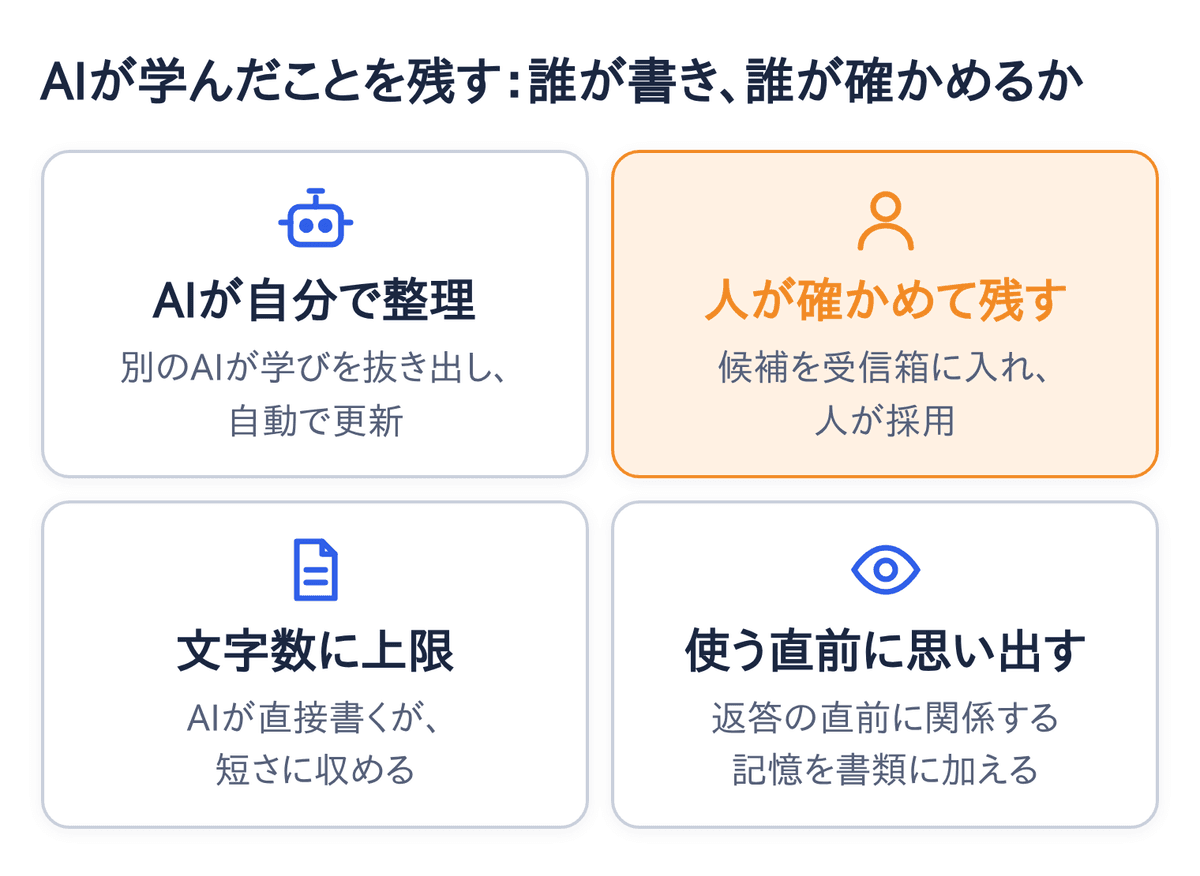
どれが正しいという話ではありません。ここで見てほしいのは、「AIの記憶に何を残し、誰が確かめるか」が、ハーネスの設計で決まり、会社が選ぶ事柄になっている、という点です。
そして、書庫の中身は、会社固有の情報です。規程も、A社との経緯も、モデルを作った会社は知りようがありません。
書庫から取り出すのはツールだ、と書きました。ここでツールの設計に少し踏み込みます。
ツールの設計も、渡す書類の設計である
「注文を検索する」というツールを例にします。
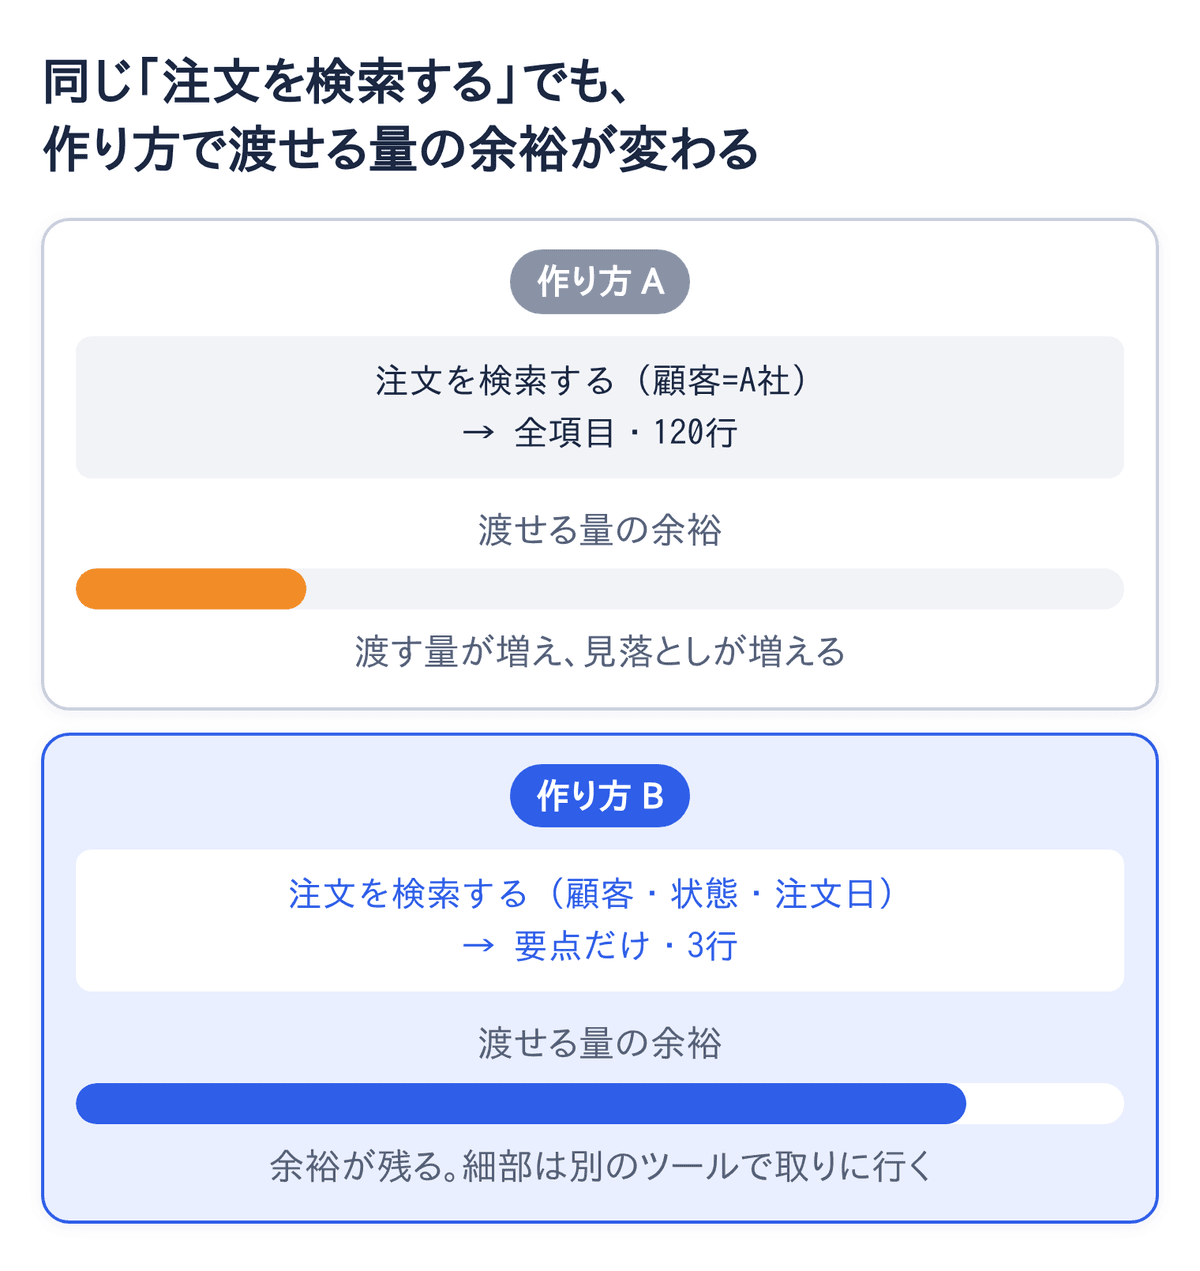
このツールは、検索条件として顧客名しか受け取れないのか、それとも注文の「状態」や「注文日」も指定できるのか。検索結果として、該当する注文の全項目を返すのか、注文番号と状態とお届け予定日だけを返すのか。
どちらも、ツールを作る側が決めることです。そして、どちらも、ループの次の1周でモデルに渡す書類の中身を決めます。
全項目を返すツールは、1回の検索結果だけで、渡せる量の上限にぐっと近づきます。要点だけを返すツールは、量を抑えられますが、必要な細部が抜けるかもしれません。条件を細かく指定できるツールは、モデルが「何を探すか」を考えるときの手がかりになり、返ってくる量も絞れます。先ほどの書庫で言えば、部署や改定日の手がかりが、「案内の規程を検索する」ツールに指定できる検索条件になります。
つまり、ツールが何を受け取り、何を返すかの設計は、コンテキストの設計そのものです。Anthropicは、ツールの説明文と、ツールに渡す項目の設計に、人が使う画面の設計と同じだけの手間をかけるよう勧めています。
業務オントロジー入門の第5回で、「業務の型があると、AIはデータベースの表(テーブル)の意味を推測しなくてよくなる」と書きました。あれは、ツールが「注文」「状態」のように名前と意味のはっきりした形でデータを返せば、AIがデータベースの項目名から意味を推測しなくて済む、という話です。ツールの設計は、ハーネスの中で、会社の業務の中身が一番直接に反映される場所です。
書類の中身が見えてきたところで、3つの区分の順番の意味を説明します。
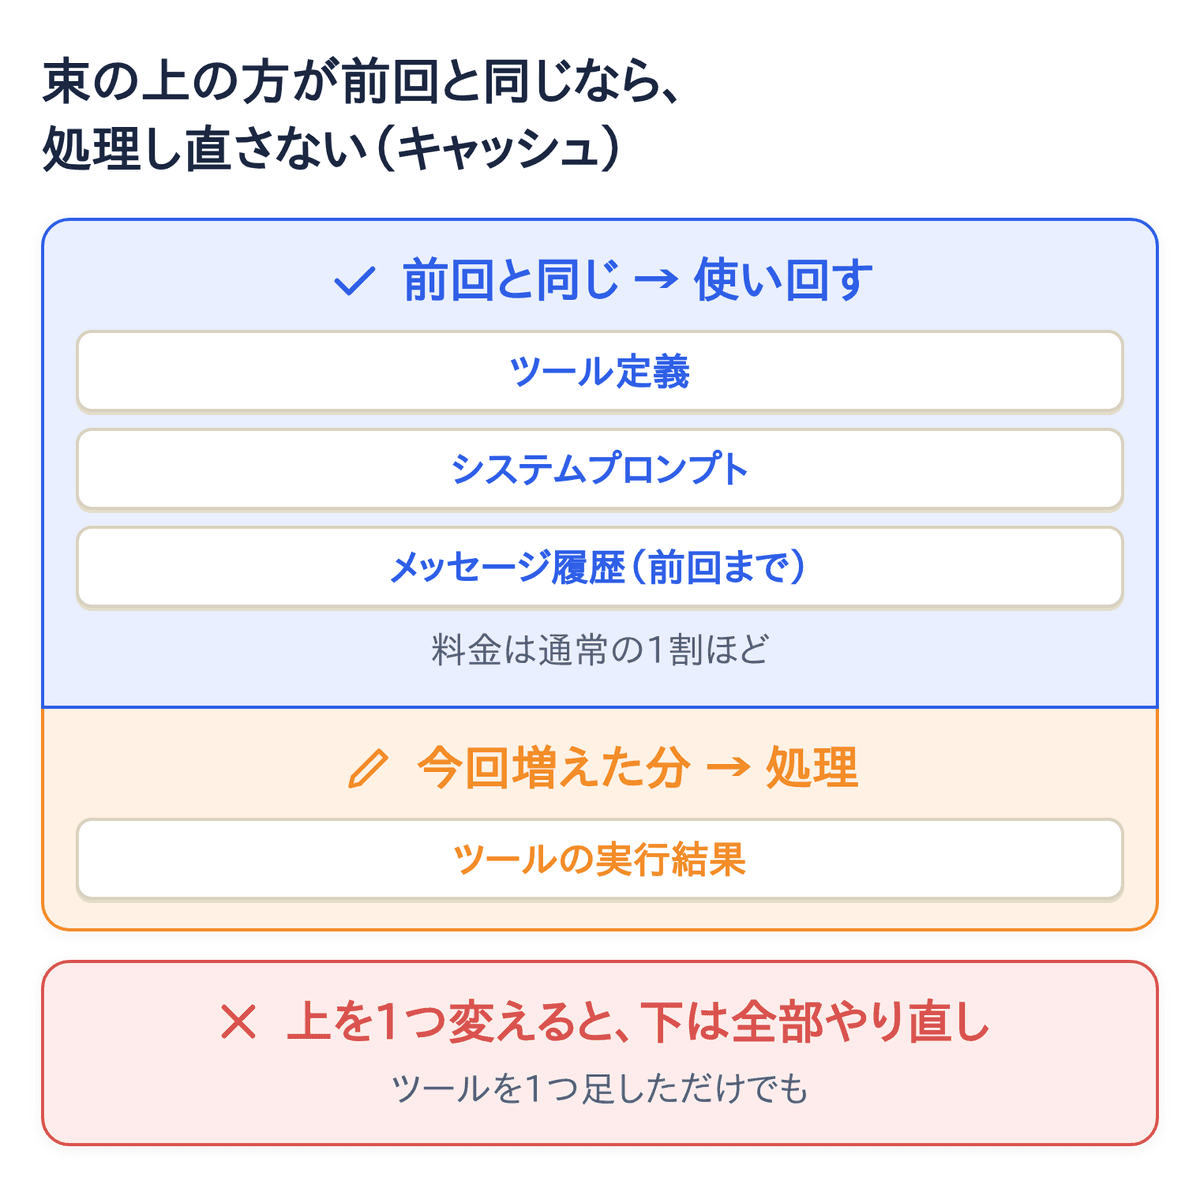
束の上の方が前回と同じなら、読み直さなくていい
モデルは、渡された書類の束を毎回処理し直します。やり取りが長くなるほど、処理する量が増え、時間と費用がかかります。
ところが、束の大部分は、前回モデルを呼んだときと同じです。ツール定義は変わりません。システムプロンプトも変わりません。メッセージ履歴も、末尾に少し足されただけです。
そこで、モデルのAPIには「束の上の方が前回と同じなら、前回の処理結果を使い回す」という仕組みがあります。プロンプトキャッシュと呼ばれ、使い回せた部分の料金は通常の1割ほどになります。
使い回しが効くのは「上から順に一致している部分」だけです。だから、3つの区分の順番が大事になります。変わりにくいものから順に並んでいるのは、そのためです。たとえば、一番上のツール定義を1つ変えただけで、その下のシステムプロンプトもメッセージ履歴も全部処理し直しになります。Claude Codeがシステムプロンプトを「変わらない前半」と「毎回変わる後半」(カスタム指示や作業環境の情報)に分けているのも、前半を使い回すためです。
費用の話に見えますが、実は「束の並び順には意味がある」という話です。変わらないものを上に、変わるものを下に置くと、使い回しが最も効きます。
ここまでが、渡された書類の構造です。ここからは、書類の限界を2つ見ます。
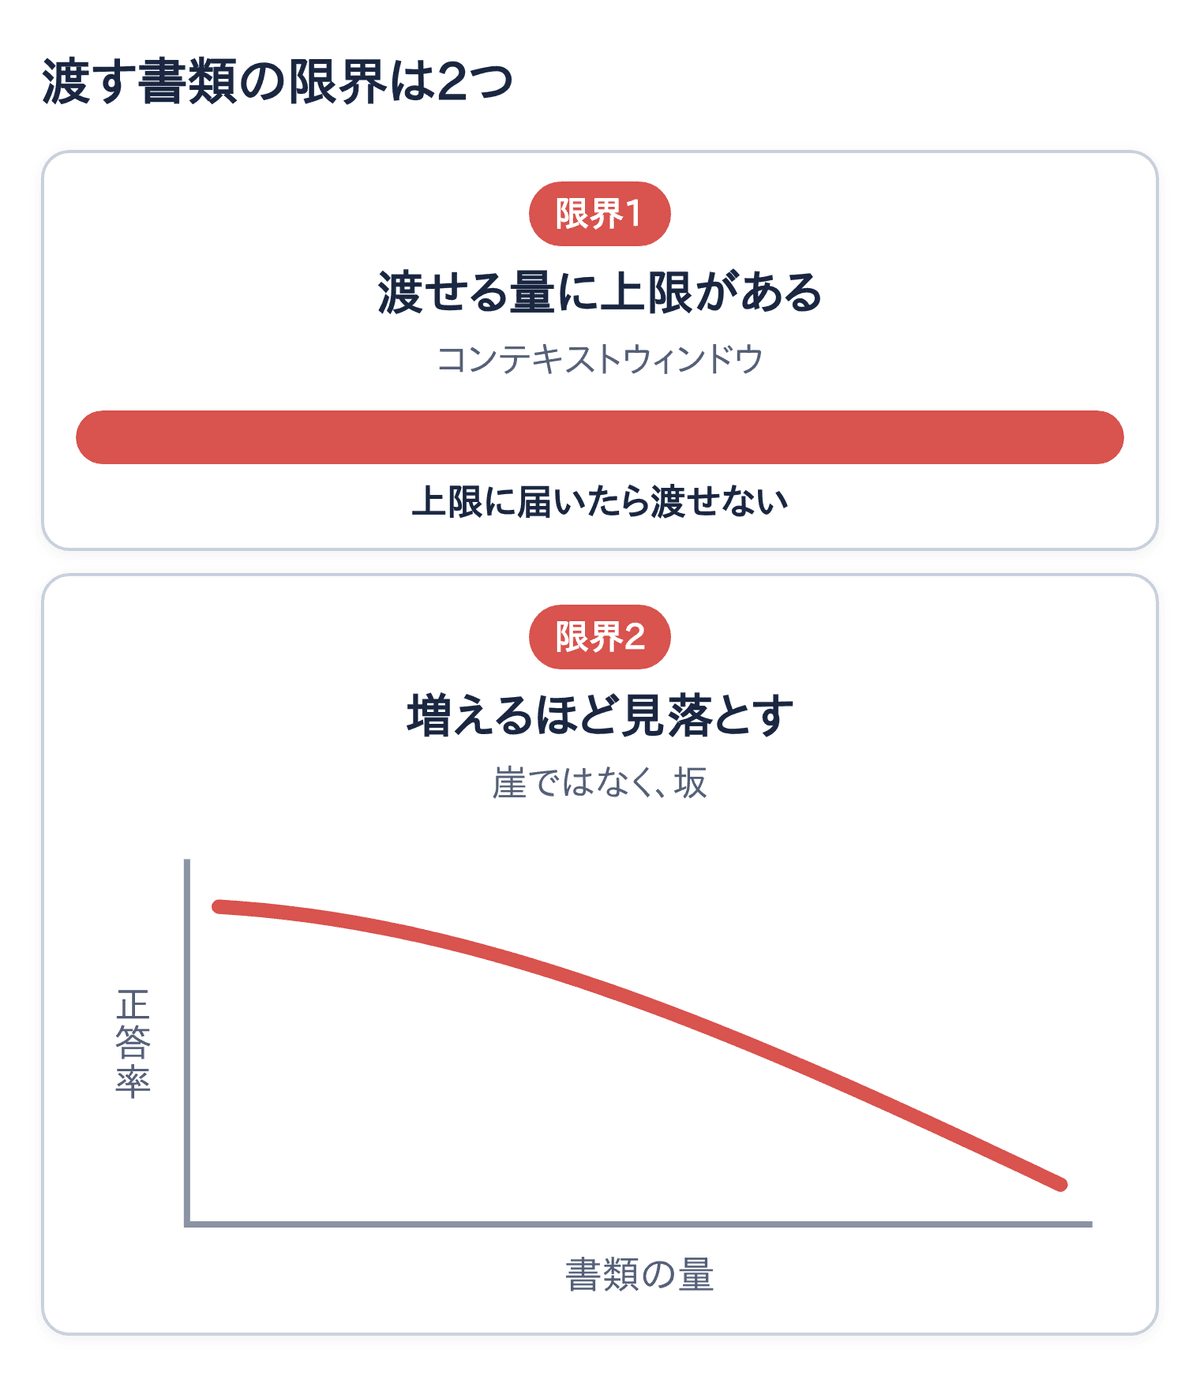
限界1:一度に渡せる量には、上限がある
モデルが1回に受け取れる文章の量(トークンという単位で数えます)には、上限があります。コンテキストウィンドウと呼ばれる、一度に渡せる書類の量の上限です。
上限はモデルによって違います。今の主なモデルで数十万トークン、日本語の文章にして十数万字から数十万字です。年々広がってはいますが、無限ではありません。メッセージ履歴が積み上がり、大きなツールの実行結果が入り、書庫から取り出した文書も加わる。そうしているうちに、いつか上限に届きます。届いたら、それ以上は何も渡せません。
分かりやすい限界ですが、実はもう1つ、こちらの方が厄介な限界があります。
限界2:上限に余裕があっても、増えるほど見落とす
上限に余裕があっても、書類が増えるほど、AIは細部を見落とすようになります。
2025年7月に公開された調査では、18種類のモデルで「入力が長くなるほど、同じ単純な問いの正答率が下がる」ことが確かめられました。たとえば、同じ語を繰り返した文章をそのまま書き写す、という簡単な課題でも、文章が長いほど間違えます。
なぜそうなるのか。Anthropicは、モデルが一度に向けられる注意には限りがある、という意味で「注意の予算」と呼んでいます。モデルは、渡された書類のすべてのトークンを、他のすべてのトークンと見比べながら処理しています。トークンが2倍になると、見比べる組み合わせは4倍になります。限られた注意を増えた組み合わせに薄く分けて配ることになり、1つ1つに向く注意が減ります。
大事なのは、これが崖ではなく坂だということです。「ここまでは大丈夫、ここから急に駄目」ではなく、増えるにつれてじわじわと精度が落ちます。だから気づきにくいのです。
上限が広がっても、渡す量が増えれば仕事の質が落ちる。これが2つ目の限界です。
2つの限界があるなら、ハーネスは何をすればよいのでしょうか。
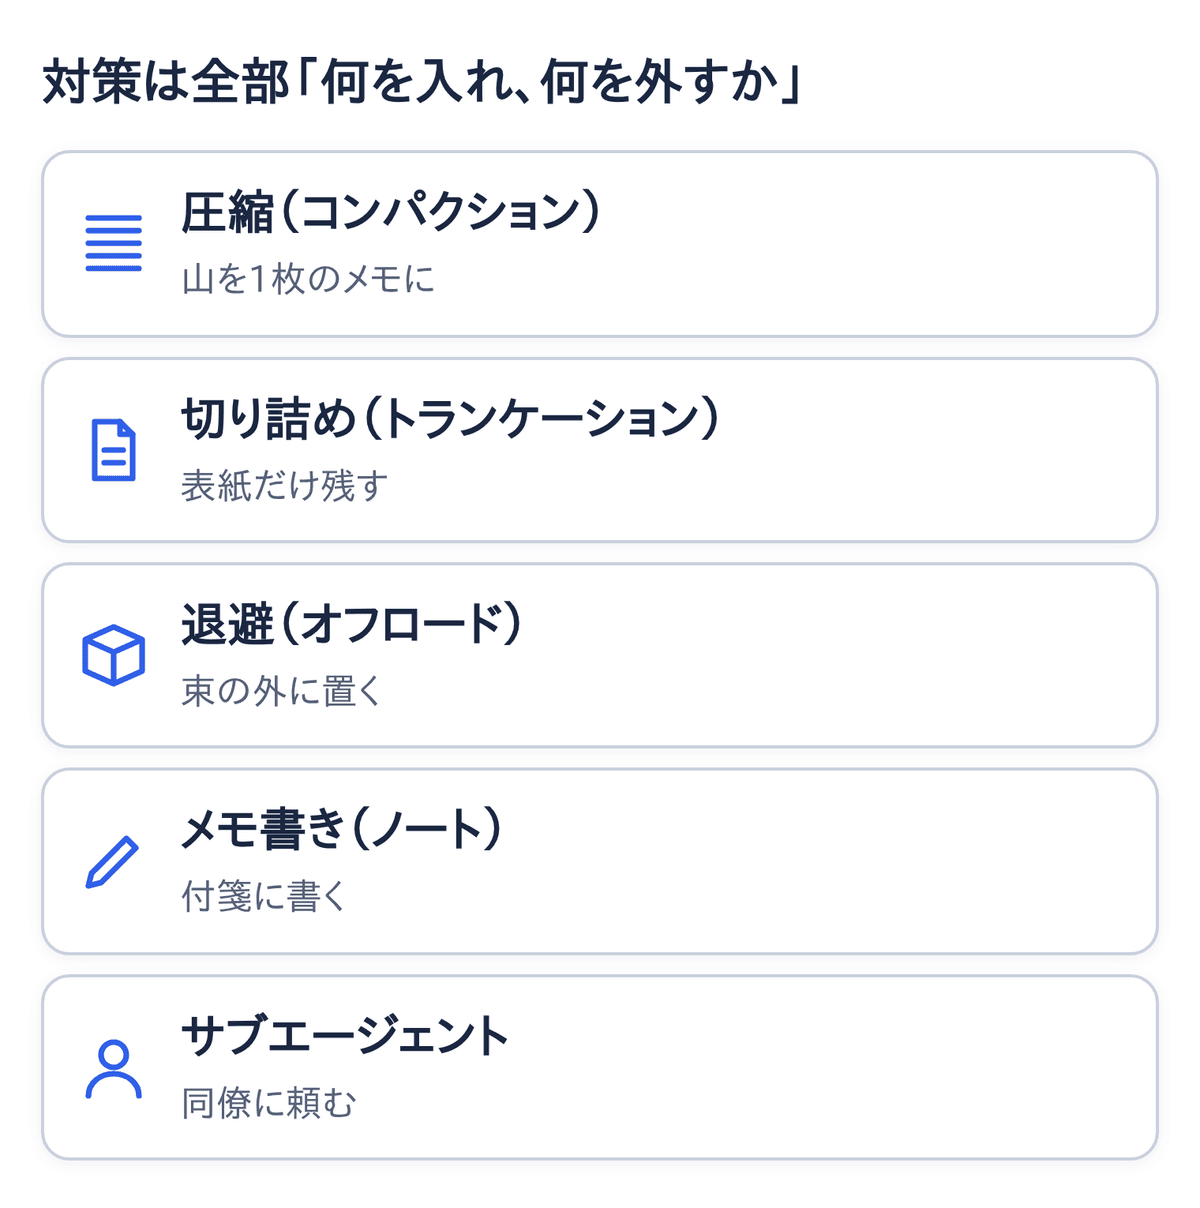
対策は全部「何を入れ、何を外すか」
ハーネスが使う対策を、表にまとめます。
対策 | 何をするか | 書類の束にたとえると |
|---|---|---|
圧縮(コンパクション) | メッセージ履歴が上限に近づいたら、ここまでの要約を作って置き換える | 書類の山を1枚のメモにまとめる |
切り詰め(トランケーション) | 大きなツールの実行結果のうち、直近の数回のやり取りより古いものを短くする | 古い書類の本文を捨てて表紙だけ残す |
退避(オフロード) | ツールの実行結果の本文はファイル置き場に保存し、必要ならツールで取り直す | 束の外に置き、要るときだけ出す |
メモ書き(ノート) | 進み具合や決めたことを、ファイル置き場のメモに書いておく | 付箋に書いて貼る |
サブエージェント | 調べ物を別のAIに任せ、要点だけを受け取る | 同僚に調べてもらい、報告だけ聞く |
圧縮については、主要な製品の大半が同じ方式に落ち着いています。上限の少し手前で自動的に要約を作って置き換え、直近のやり取りは原文のまま残す。つまり圧縮は、もう製品ごとの差がつく場所ではなくなっています。
「サブエージェント」には注意があります。Anthropicの調べでは、エージェントは通常のチャットでの対話に比べて4倍ほど、複数のエージェントを使う構成は15倍ほどのトークン、つまり費用を使います。私たちも、まず1つのエージェントで始め、複数の調べ物を同時に進める必要がはっきりしたときだけ、サブエージェントに分けることを勧めます。
どの対策も、やっていることは1つです。何を書類に入れ、何を外すか。
だから、「何を渡すか」が答えの質を決める
ここまでをまとめます。
モデルは、渡された書類だけを見て答える。何を渡すかは、ハーネスが決める。渡せる量には上限があり、余裕があっても増えるほど見落とす。
ということは、同じモデルを使っていても、渡す書類の整え方で答えの質が変わります。これが、同じモデルを使う製品同士で答えの質が違う理由です。
コンテキストは、ツール定義・システムプロンプト・メッセージ履歴・取り出した文書など、モデルに入力される情報の総称でした。その全体を設計する「渡す書類を整える仕事」を、コンテキストエンジニアリングと呼びます。Anthropicは2025年9月の記事で、「モデルが答えを出すときに渡す情報を、最適な組み合わせに選び、保ち続けるための戦略の集まり」と定義しています。
よく聞く「プロンプトエンジニアリング」との違いは、対象の広さです。プロンプトエンジニアリングは、指示の言い回しを工夫すること。コンテキストエンジニアリングは、ツール定義、システムプロンプト、メッセージ履歴、書庫からの取り出し方、ツールが返すもの、圧縮や退避まで含めた、渡す書類の全体を設計することです。
第1回のハーネスの7部品で言えば、「モデル連携」と「コンテキスト管理」の2つが担っている仕事です。ハーネスは書類を整える以外の仕事もしますが、同じモデルを使う製品の間で答えの質に差が出るのは、この書類を整える仕事の部分だと私たちは考えています。
推進担当が押さえる要点
- 渡された書類は、ツール定義・システムプロンプト・メッセージ履歴の3つの区分に分かれ、この順に束になっている
- システムプロンプトには、製品を作った会社が埋め込む層と、利用者が書く「カスタム指示」の層がある。前者はモデルの世代が変わると書き換わり、後者は使う会社の業務のルールとして書かれ、モデルが変わっても変わらない
- ツールの実行結果はメッセージ履歴に入り、ループのたびに書類は増える(短期記憶)。長期記憶は書類の外(書庫)に置き、ツールで取り出す。書庫の中身は会社固有の情報で、検索で引ける単位に切り、手がかりを付けるところから始める
- ツールが何を受け取り、何を返すかが、次にモデルに渡す書類の中身を決める。ツールの設計はコンテキストの設計そのもの
- 束の上の方が前回と同じなら、その部分は処理し直さない仕組みがある。だから、変わらないものを上に、変わるものを下に置く
- 渡せる量には上限がある。余裕があっても、増えるほど見落とす。対策は全部「何を入れ、何を外すか」で、これがコンテキストエンジニアリング
AIの賢さは、渡す書類の整え方で決まる
AIエージェントの答えの質を決めるのは、モデルの賢さだけではありません。モデルに渡された書類に、何が、どんな順で、どれだけ入っているか。それを決めるハーネスの仕事も、答えの質を左右します。
次回は、書類を離れて、ハーネスの「能力」の側を見ます。人が見ていないときにも動けるか、どの社内システムに触れるか、どこで動かすか、途中で止められるか、何をしたかの記録が残るか。AIに何を任せられるかは、そこで決まります。
シリーズの目次
- AIエージェントは「ツールを呼ぶループ」でできている 〜AIハーネス入門 第1回〜
- AIが見ているのは「渡された書類」だけ 〜AIハーネス入門 第2回〜(この記事)
- 何を任せられるかは「能力」と「安全」で決まる 〜AIハーネス入門 第3回〜
- ハーネスのどこに、会社は投資するか 〜AIハーネス入門 第4回〜
関連記事
- プロンプトインジェクションとは?防げない前提の対策と確認8項目:外部から取り込んだ文書の中の指示が、渡された書類の中で命令として読まれる危険
- AIエージェントは型の上でどう動くか 〜業務オントロジー入門 第5回〜:型があると、AIはテーブルを推測しなくてよくなる
参考資料
- Anthropic「Effective context engineering for AI agents」(2025年9月、https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents (2026年11月2日確認))
- Anthropic「Prompt caching」(Claude Platform ドキュメント、https://platform.claude.com/docs/en/build-with-claude/prompt-caching (2026年11月2日確認))
- Kelly Hong, Anton Troynikov, Jeff Huber, "Context Rot: How Increasing Input Tokens Impacts LLM Performance," Chroma(2025年7月、https://www.trychroma.com/research/context-rot (2026年11月2日確認))
- Paul Barbaste ほか, "Harness Engineering: Anatomy, Architecture, and Evolution of Coding Agents," arXiv:2609.00006(2026年7月、https://arxiv.org/abs/2609.00006 (2026年11月2日確認))
- Anthropic「How we built our multi-agent research system」(2025年6月、エージェントのトークン消費について、https://www.anthropic.com/engineering/multi-agent-research-system (2026年11月2日確認))
- Anthropic「Building effective agents」(2024年12月、ツールの設計について、https://www.anthropic.com/engineering/building-effective-agents (2026年11月2日確認))
- Anthropic「Claude Code memory(CLAUDE.md)」(Claude Code ドキュメント、https://code.claude.com/docs/en/memory (2026年11月2日確認))
Askhubについて
Askhubは、日本の中堅・大企業がAIに業務を任せるための基盤です。業務の型(オントロジー)でAIに許す操作を定め、承認と判断ログで任せる範囲を広げながら、国産の基幹システムまで書き込めるようにします。導入はコンサルタントが伴走します。
この記事の言葉で言えば、AskhubがAIに渡す書類に入れるのは、業務の型から作られたツール定義と、名前と意味の付いた業務のデータです。AIがテーブルの意味を推測する余地を減らし、渡す書類を会社の言葉で整えます。
※Askhubのサービスに関する記載は、2026年11月時点の情報です。
自社の業務にAIエージェントをどう導入するか相談したい方は、お問い合わせからご連絡ください。
この記事を書いた人
この記事の内容について相談する
自社の業務でどう進めるか、相談したい方はこちらのフォームからご連絡ください。1〜2営業日以内に担当者よりご連絡します。