AIに数字を答えさせる前に、指標の定義を1か所にそろえる
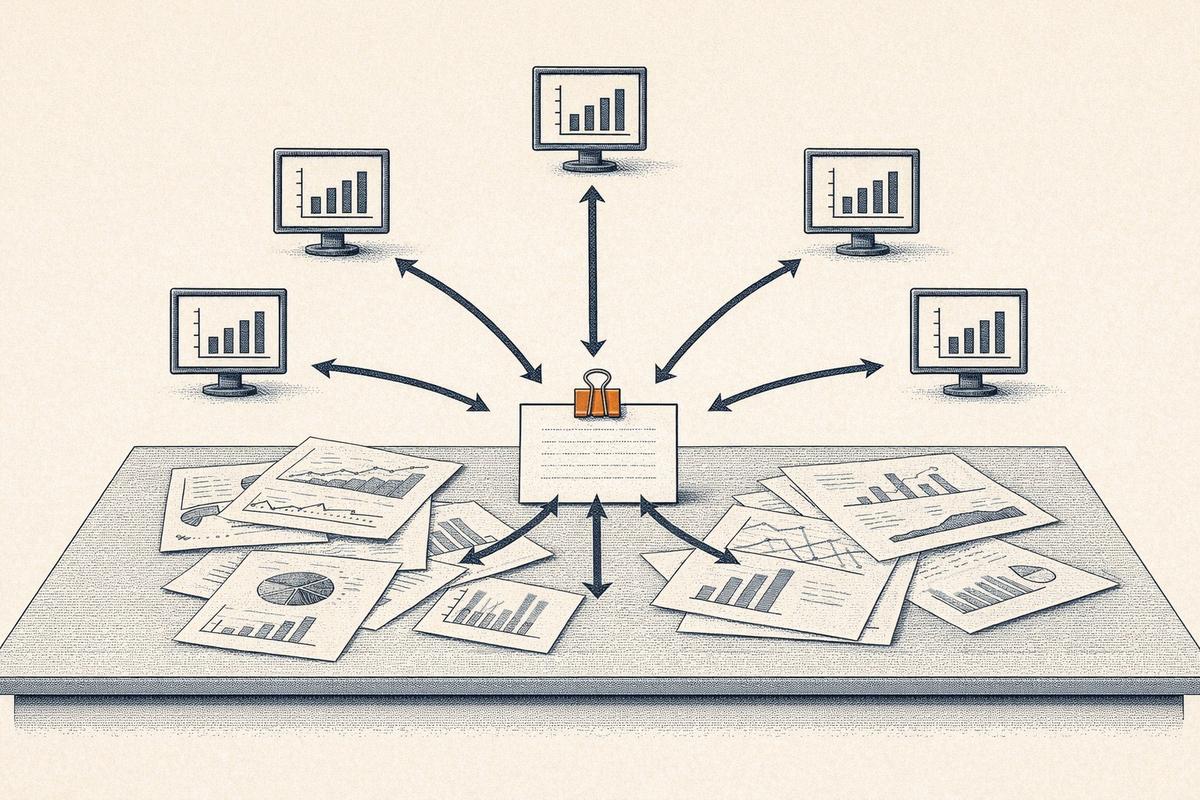
セマンティックレイヤーとは、売上などの指標の計算方法とデータの意味を1か所で定め、BIツールやAIが同じ定義を使えるようにする層です。BIツールは、売上の推移などをグラフや表にして見せる分析の道具です。
導入の成否は、作る技術よりも、定義を誰が決めて守るかで分かれると私たちは考えています。
経営会議で、営業部の資料と経理部の資料の売上が合わないことがあります。営業部は受注した時点で、経理部は出荷した時点で売上を数えているためです。どちらも間違いではありませんが、定義が違うので数字がずれます。
同じことは、AIに社内のデータを聞くときにも起きます。「先月の売上は?」と聞いたとき、AIがどの定義で計算したかによって、答えが変わります。
推進担当が押さえる要点
- セマンティックレイヤーは、データベースの表と、それを使うBIツールやAIの間に置き、「売上」のような指標の計算方法とデータの意味を1か所で定める層
- AIにデータを問い合わせさせると、定義が無ければ、AIは「売上」がどの列のどんな合計かを推測して計算する。各社の検証では、セマンティックレイヤーを通すと答えの正しさが上がる(いずれも各社自身の検証)
- AIに直接データベースを問い合わせさせる方法との大きな違いは、定義に無い質問に「答えられない」と返せること。もっともらしい誤りを減らせる。ただし、AIが質問に合う指標を選び間違えることは残る
- オントロジー(業務に出てくるものと、その関係の定義)とは中心が違う。セマンティックレイヤーの中心は数字(指標)の意味。どちらかを選ぶのではなく、AIに業務まで任せるなら両方の役割が要る
- セマンティックレイヤーは集計して答えるための層。AIエージェント(AIが自分で手順を選びながら仕事を進める仕組み)に受注の確定のような操作をさせるなら、操作の定義が別に要る
- 導入の成否は、技術より、指標の持ち主と定義を変える手続きで決まると私たちは考えている。始めるなら、経営会議で使う一部の指標から
セマンティックレイヤーとは:指標の計算と、データの意味を1か所で定める層
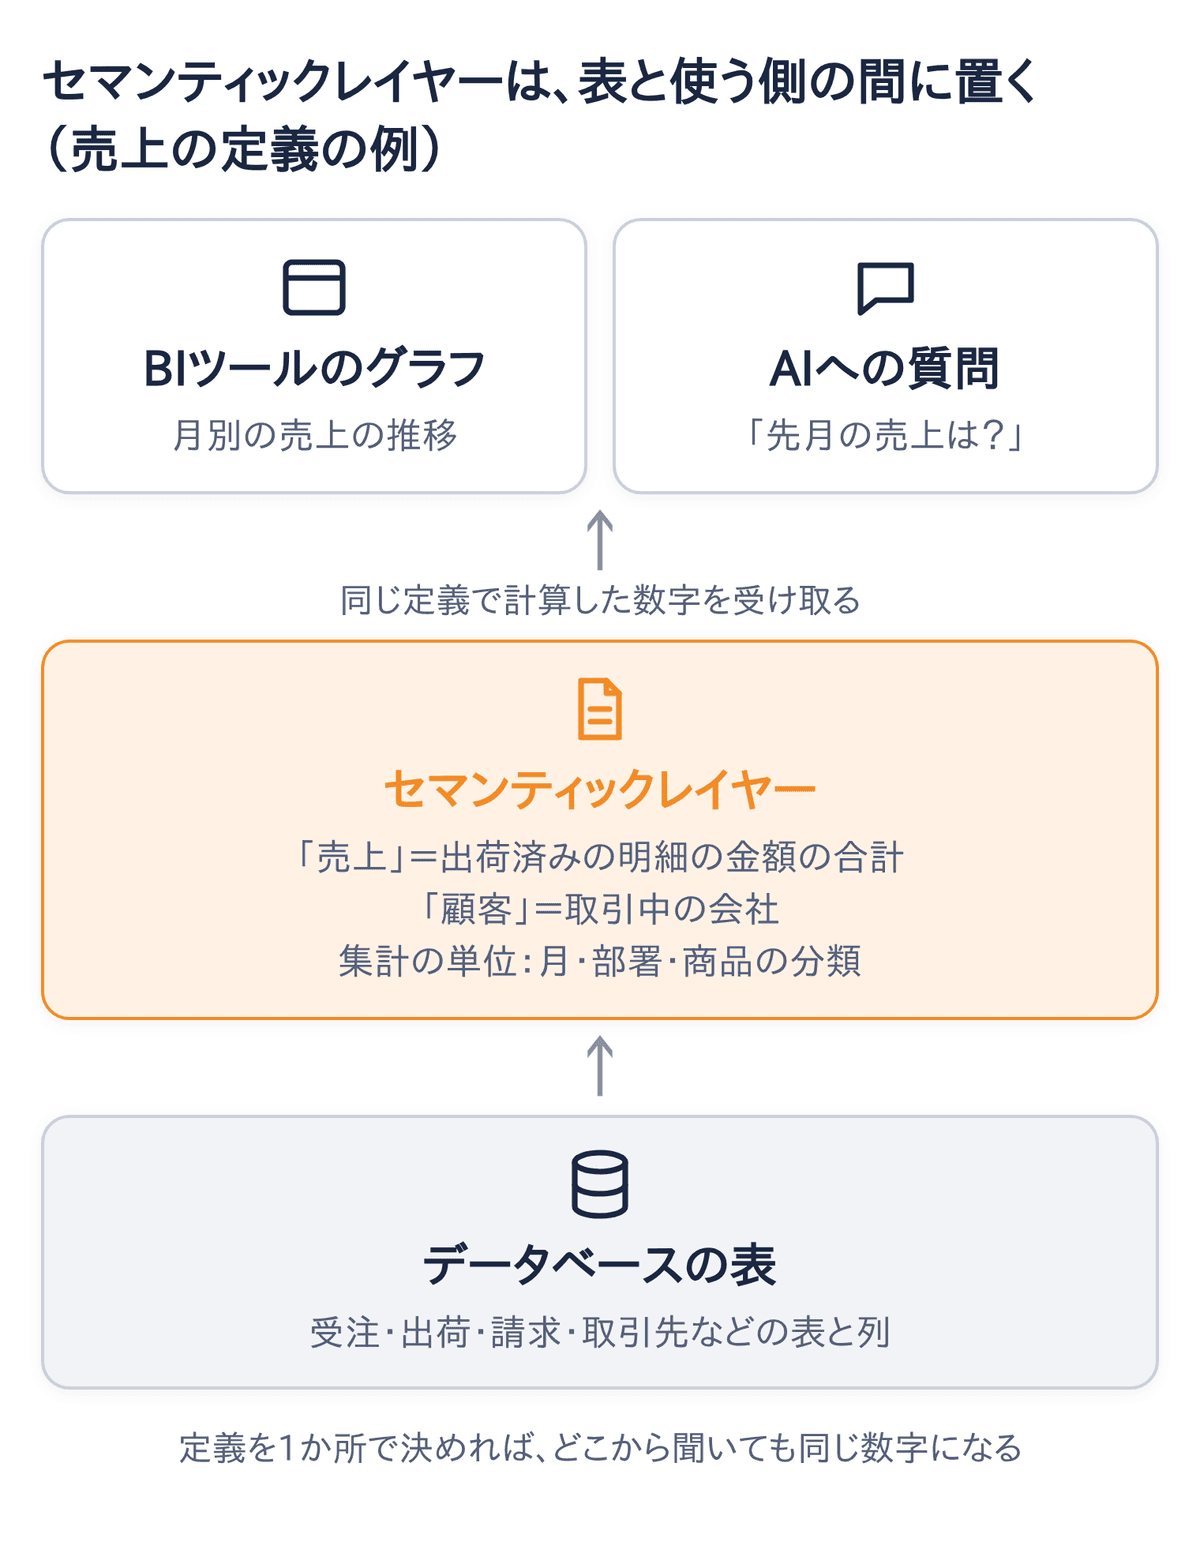
セマンティックレイヤーは、データベースの表(テーブル)と、それを使うBIツールやAIの間に置き、データの意味と指標の計算方法を定める層を指します。セマンティック(semantic)は「意味の」、レイヤー(layer)は「層」です。
たとえば、次のことを1か所で決めます。
- 「売上」は、出荷済みの明細の金額を合計したもの
- 「顧客」は、取引先の表のうち、取引中の会社
- 売上は、月、部署、商品の分類ごとに集計できる
一度決めておけば、BIツールで作るグラフも、AIへの質問の答えも、同じ定義で計算されます。
各社は、この層を次のような名前で呼んでいます。dbt はデータを分析用の表に整えるツールです。Looker と Power BI は BIツールです。Snowflake と Databricks は、データを集めて置くデータ基盤です。
呼び名 | 公式の説明(要旨) |
|---|---|
dbt Semantic Layer | 整備済みの表の上に指標を定義し、表の結合を自動で処理する |
Looker の LookML | Lookerで、意味を持ったデータのモデルを作るための言語 |
Power BI のセマンティック モデル | レポートやグラフにすぐ使える形に整えたデータ。2023年に「データセット」から改名 |
Snowflake のセマンティック ビュー | 指標・切り口・表どうしの関係といった業務の概念を、データベースの中に直接保存する |
Databricks のメトリック ビュー | 業務の指標(KPI)を定義し、管理するための、使い回せる部品 |
呼び名は違っても、指標と意味を1か所で定め、使う側がそれを共有する、という役割は共通です。
置き場所は大きく2つに分かれます。1つは、Power BI や Looker のように BIツールの中に定義を持つ形です。もう1つは、dbt や Snowflake のようにデータ基盤の側に持ち、複数のBIツールやAIから使う形です。
BIツールの中に定義を持つ形を選ぶなら、そのBIツールの外のAIからも同じ定義を使えるかを確かめます。
私たちの支援先で、指標の定義をデータ基盤の側(dbtやSnowflakeなど)で1か所に持っている会社は、10社に1社ほどの印象です。残りの会社では、定義はBIツールの中にあるか、1か所にそろっていません。
その状態でAIに問い合わせさせると、答えが割れます。
なぜ今注目されるか:AIにデータを問い合わせさせると、定義が無いと答えが割れる
AIにデータを問い合わせさせるとき、表や列の名前しか渡されていないと、AIは「売上」がどの列のどんな合計かを推測するしかありません。
AIに「先月の売上は?」と聞くと、多くの場合、AIは質問をSQLに書き換えて実行し、答えを出します。SQLは、データベースに問い合わせるための言葉です。文章からSQLへのこの変換を、text-to-SQL と呼びます。
各社は、セマンティックレイヤーを使うとAIの答えの正しさが上がると報告しています。いずれもセマンティックレイヤーを提供する会社自身の検証で、第三者が同じ結果を確かめたものではありません。
発表元 | 条件 | 結果 |
|---|---|---|
dbt Labs(2026年4月) | 保険のデータの11問を各20回、2つのAIモデルで | 表の構造を全部渡してAIにSQLを書かせる方法は64.5%、セマンティックレイヤー経由は72.7%。後者は、定義の範囲内の質問では100%、範囲外では0%(答えを返さないため)。質問に合わせて中間の表を3つ足した後は、前者が84〜90%、後者が98〜100% |
Snowflake(2025年3月) | 公開の評価用の問題集から4分野(計392問) | 同じAIモデルに表の構造と問題集付属の補足知識を渡すと平均57%。セマンティックレイヤーを使う同社の機能(Cortex Analyst)では78%。定義は問題集の正解のSQLも使って整えたもの |
Google(Looker、2025年5月) | 社内の検証(条件は非公開) | 自然な文章での問い合わせで、データの誤りを最大で3分の2減らした |
なお、dbt Labsは、表の構造を全部AIに渡す方法は大きなデータでは現実的でない、と断っています。
数字の差に加えて、dbt Labsは答え方の違いを強調しています。セマンティックレイヤーは、定義に無い質問には「答えられない」と返します。AIが直接SQLを書く方法は、もっともらしい間違った数字を返すことがあります。
経営の判断に使う数字では、誤った数字が黙って出るより、答えられないと分かるほうが安全です。ただし、AIが質問に合う指標を選び間違えることは残ります。
2025年9月には、Snowflake、Salesforce、dbt Labsなどが「Open Semantic Interchange」を発表しました。製品をまたいで同じ定義を使えるよう、定義の書き方をそろえる取り組みです。
製品ごとに意味の定義がばらばらだと、人の分析にもAIの分析にも妨げになる、というのが理由です。
オントロジーとの違い:指標のための意味か、業務そのものの意味か
セマンティックレイヤーとオントロジーは、どちらも「データの意味」を定めるので混同されがちですが、中心が違います。AIに業務まで任せることを考えるなら、押さえておきたい違いです。
セマンティックレイヤーの中心は、売上や粗利のような数字(指標)の意味と計算方法です。「顧客」のようなデータの意味も定めますが、それは指標を正しく集計するためです。オントロジーの中心は、受注や顧客のような業務に出てくるものと、その関係です。
Snowflakeのセマンティック ビューのように表どうしの関係まで持つ製品もあり、境目は製品によって重なります。周りの言葉も含めて、何を中心に定めるかで見分けます。
言葉 | 何を定めるか | 例 |
|---|---|---|
データモデル | データをどんな表に分けて保存し、表どうしをどうつなぐか | 受注の表の列と、表どうしのつながり |
セマンティックレイヤー | 指標をどう計算し、データが何を意味するか | 売上 = 出荷済みの明細の金額の合計 |
オントロジー | 業務に何があり、どう関係するか | 「受注」は「顧客」から受けるもので、「明細」を持つ |
業務の型(業務オントロジー) | 上に加えて、誰が何をしてよいか | 受注を「確定」にできるのは誰で、どんな条件か |
ナレッジグラフ | 具体的に、何と何がつながっているか | 受注#1042 → 顧客「A社」(説明のための例です) |
製品によっては、セマンティックレイヤーがデータモデルを含みます(Power BIなど)。Microsoftは、自社のデータ基盤の説明で、分担を次のように整理しています。
要素 | Microsoftの整理での役割 |
|---|---|
セマンティックモデル | 信頼できる指標を届ける |
オントロジー(プレビュー版) | その指標のための共通の業務の言葉を定める |
グラフ(ものどうしのつながりを保存して辿るデータベース) | つながりと影響の分析を支える |
注意したいのは、セマンティックレイヤーは集計して答えるための層で、データを書き換える操作は定義しない点です。
AIエージェントは、AIが自分で手順を選びながら仕事を進める仕組みです。AIエージェントに受注の確定や請求の発行をさせるなら、別の定義が要ります。どの操作を、誰が、どんな条件でしてよいかです。
2つは、どちらかを選ぶものではありません。
数字を正しく答えさせるにはセマンティックレイヤーの役割が、業務を任せるにはオントロジーの役割が要ります。AIに業務まで任せるなら、両方の役割が要ります。
別々の製品で持つことも、1つの製品で両方を持つこともあります。オントロジーの側で、「受注」のようなものに紐づけて指標の定義を持つ製品もあります。
導入の前に、指標の持ち主と定義を変える手続きを決める
私たちは、セマンティックレイヤーは作る技術よりも、定義を誰が決めて守るかで成否が分かれると考えています。
導入や製品選びの前に、まず次の2つを決めます。
- 指標の持ち主:「売上」「粗利」などの定義を、どの部署の誰が決めるか。部署で定義が違うなら、どれを会社の定義にするか
- 定義の変更の手続き:定義を変えるとき、誰が承認し、いつから切り替えるか。変更の履歴が残るか
そのうえで、AIからの使われ方を確かめます。
- AIからの使われ方:AIはセマンティックレイヤーを通して問い合わせるのか、表を直接見るのか
- 答えられない質問の扱い:定義に無い質問に、「答えられない」と返すか
- BIとAIで同じ定義か:BIツールのグラフとAIの答えが、同じ定義から計算されるか
- AIに操作までさせるか:集計して答えさせるだけか、受注の確定のような操作もさせるか。操作もさせるなら、セマンティックレイヤーとは別に、操作とその条件の定義が要る
最初から全社の指標をそろえようとせず、経営会議で使う一部の指標から始めることを勧めます。冒頭の売上のずれのように、指標の定義をそろえることは、AIを使うかどうかに関わらず効きます。
まとめ:AIに正しい数字を答えさせるには、先に定義をそろえる
セマンティックレイヤーは、データの意味と指標の計算方法を1か所で定める層です。注目されるのは、AIに社内のデータを問い合わせさせる場面が増え、定義がそろっていないと答えが割れるからです。
各社の検証では、答えの正しさが上がり、答えられない質問を「答えられない」と返せるようになります。ただし、集計して答えるための層なので、操作まで任せるなら別の定義が要ります。
導入の前に、指標の持ち主と、定義を変える手続きを決めておきます。
関連記事
- オントロジーとは?業務に「型」が要る理由と、AIエージェントで注目される背景 〜業務オントロジー入門 第1回〜:用語集・データモデル・セマンティックレイヤー・業務の型の違い
- Palantirのオントロジーとは?Fabric IQ・SAPとの違いと選び方 〜業務オントロジー入門 第6回〜:読む専用のセマンティックレイヤーと、操作まで持つ業務の型の違い
- RAGとは?社内文書をAIに答えさせる仕組みと、精度を決める3つの段階:文書をAIに答えさせるときの仕組みと、精度が落ちる理由
参考資料
- dbt Labs「dbt Semantic Layer」(https://docs.getdbt.com/docs/use-dbt-semantic-layer/dbt-sl (2026年11月11日確認))
- dbt Labs「Semantic Layer vs. Text-to-SQL: 2026 Benchmark」(2026年4月、https://docs.getdbt.com/blog/semantic-layer-vs-text-to-sql-2026 (2026年11月11日確認))
- Google Cloud「What is LookML?」(https://docs.cloud.google.com/looker/docs/what-is-lookml (2026年11月11日確認))
- Google Cloud「How Looker's semantic layer enhances gen AI trustworthiness」(2025年5月、https://cloud.google.com/blog/products/business-intelligence/how-lookers-semantic-layer-enhances-gen-ai-trustworthiness (2026年11月11日確認))
- Microsoft Learn「New name for Power BI datasets」(2023年11月、https://learn.microsoft.com/power-bi/connect-data/service-datasets-rename (2026年11月11日確認))
- Microsoft Learn「Semantic models in the Power BI service」(https://learn.microsoft.com/en-us/power-bi/connect-data/service-datasets-understand (2026年11月11日確認))
- Microsoft Learn「What is Fabric IQ?」(https://learn.microsoft.com/en-us/fabric/iq/overview (2026年11月11日確認))
- Snowflake「Overview of semantic views」(https://docs.snowflake.com/en/user-guide/views-semantic/overview (2026年11月11日確認))
- Snowflake「Agentic semantic model improvements for text-to-SQL」(2025年3月、https://www.snowflake.com/en/engineering-blog/agentic-semantic-model-text-to-sql (2026年11月11日確認))
- Snowflake ほか「Open Semantic Interchange」の発表(2025年9月、https://www.snowflake.com/en/news/press-releases/snowflake-salesforce-dbt-labs-and-more-revolutionize-data-readiness-for-ai-with-open-semantic-interchange-initiative/ (2026年11月11日確認))
- Databricks「Unity Catalog semantics」(https://docs.databricks.com/aws/en/uc-semantics/ (2026年11月11日確認))
Askhubについて
Askhubは、日本の中堅・大企業がAIに業務を任せるための基盤です。業務の型(オントロジー)でAIに許す操作を定め、承認を挟みながら任せる範囲を広げ、国産の基幹システムまで書き込めるようにします。導入はコンサルタントが伴走します。
この記事の言葉で言えば、Askhubは、業務の型として、業務に出てくるもの、関係、操作とその条件を定める仕組みにあたります。業務の型は、ものに紐づけて指標の計算の定義も持つので、それ自体がセマンティックレイヤーの役割も果たします。すでにセマンティックレイヤーを持っている会社は、それと併用することもできます。
※Askhubのサービスに関する記載は、2026年11月時点の情報です。
この記事の内容について相談する
自社の業務にAIエージェントをどう導入するか相談したい方は、こちらのフォームからご連絡ください。1〜2営業日以内に担当者よりご連絡します。
この記事を書いた人