「AIが間違えたら、誰が責任を取るのか」
経費精算の申請をAIに先にチェックさせ、人は「要確認」とされた申請だけを見る、という案を推進担当(社内でDX・AXを進める担当者)が出したとします。会議では「AIが間違えたら、誰が責任を取るのか」と問われ、話がそこで止まりがちです。
この記事は、AX推進入門シリーズ(全10回)の第6回です。シリーズの一覧はこちら。
まず押さえたいのは、人間もミスをするという事実です。今その申請を見ている担当者も、ときには不備を見落とします。人のミスなら、担当者と上長が経緯を確かめて直す、という流れが職場にすでにあります。それでもAIのミスが怖いのは、AIが間違えたときの責任の所在が見えないからです。
AX(AIトランスフォーメーション。AIを前提に業務や組織を変えること)を進めるなら、この怖さを避けずに、組織として判断できる材料をそろえる必要があります。この記事では、次の5つの手順で整理します。
- 精度を「人の確認が要るか」の○×で数え、見落としを確かめる
- 何を「確認が要る」とするかの基準を、観点ごとの○×で決める
- 見落としの影響を、時間と金額に直す
- ガードレールで、損害の上限を決める
- リスクとメリットを並べ、組織として許容を決める
AIの精度は、「人の確認が要るか」の○×で数える
AIの精度を測るときに確かめたいのは、その出力に人の確認が要るかどうかです。そのため多くの場合、評価は「人が確認する」か「人が確認しない」かの2択にできます。AIが文章を書く業務でも、文章の出来を採点するのではなく「人の確認が要るか」で見れば、同じ2択になります。
経費精算の例では、AIが申請を1件ずつ見て「要確認」か「OK」を付けます。これを実データ(使えなければ、本物に似せて作ったダミーデータ)で試し、1件ずつAIの判定と正解を照らし合わせます。正解は、その業務に慣れた人が付けたものを使います。照らし合わせた結果は、次の4つに分かれます。
- 正しく拾った:問題のある申請を、AIが要確認にした
- 見落とし:問題のある申請を、AIがOKにした
- 空振り:問題のない申請を、AIが要確認にした
- 正しくOK:問題のない申請を、AIがOKにした
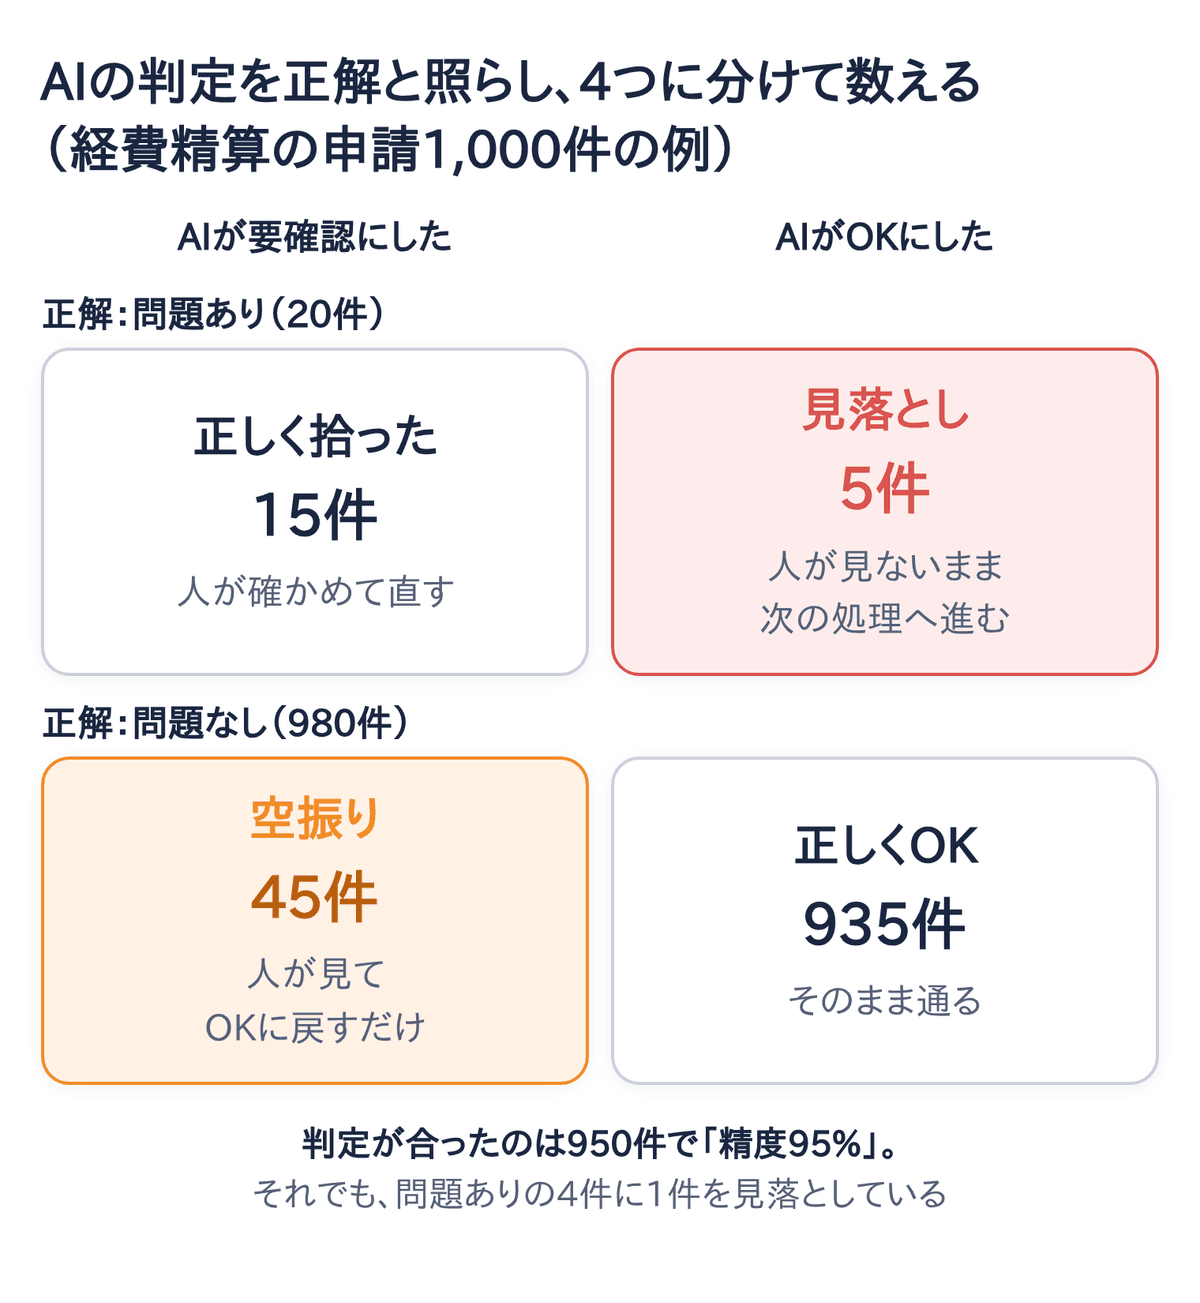
重いのは見落としです。人は要確認の申請だけを見るため、AIがOKにした申請は人が見ないまま、支払いなどの次の処理へ進みます。誤りは、後で見つかってから直すことになります。空振りは、人が見てOKに戻すだけで済みます。確認の手間は少し増えますが、誤りが次の処理へ進むことはありません。
ここでは、精度の評価とリスクの評価を分けて考えます。精度の評価で確かめるのは、AIの判定が正解と合っているかどうかだけです。誤りがどれくらい大きいか、どの誤りを重く見るかは、後の節で扱うリスクの評価の話です。
図の例では、1,000件のうち950件で判定が正解と合っているので、精度は95%です。それでも、問題のある20件のうち5件、つまり4件に1件を見落としています。AIの評価方法を発信している実務家も、問題のある申請が全体に比べて少ないと、全体の一致率だけでは見誤ると注意しています。そのうえで、問題のある申請を拾えた割合と、問題のない申請を正しくOKにできた割合を、分けて出すよう勧めています。
ベンダー(開発・導入を請け負う外部の会社)に頼む場合は、この4つの数を出してもらいます。「精度95%」のような1つの数字だけでは、見落としがどれだけあるかが分からないからです。推進担当が自分でAIを使って作る場合も、同じ4つの数を数えます。
「確認が要る」の基準は、観点ごとの○×で決める
数える前に一番難しいのは、何を「問題あり」とするかの基準づくりです。たとえば、AIが下書きした問い合わせへの回答文が5文あり、そのうち1文だけが不正確だったとします。これを問題ありとするかは、AIにとっても、正解を付ける人にとっても判断が揺れます。
事実の誤りがあるかどうかは、必ず○×で判定します。○×で判定すれば、前の節で説明した見落としと空振りの数え方をそのまま使えます。
事実の誤りは、内容が照合先の資料と合っているかどうかで○×を付けます。照合先とは、価格表や社内規程のように、何を正しいとするかを決めた資料のことです。これは研究でも標準的なやり方です。AIに判定させるときは照合先を渡し、文書全体にまとめて付けるのではなく、記述を1つずつ判定させるのが前提になります。回答文なら「送料は無料です」「3営業日で届きます」といった記述を1つずつ、価格表や規程と照らします。
たとえば、規程では届くまで5営業日なのに、回答文に「3営業日で届きます」とあれば、その記述は×です。残りの4文が正しくても、事実の誤りが1つあるので、この回答文は要確認です。「5文のうち1文だけ不正確」という迷う例も、事実の誤りという観点で見れば×と決められます。
事実のほかにも、観点を分けてそれぞれを○×で判定できます。分け方の一例は次の3つです。
- 事実の誤りがないか
- 必要な項目が抜けていないか
- 言い回しが不適切でないか
合否を決める用途では、点数ではなく○×で判定させる
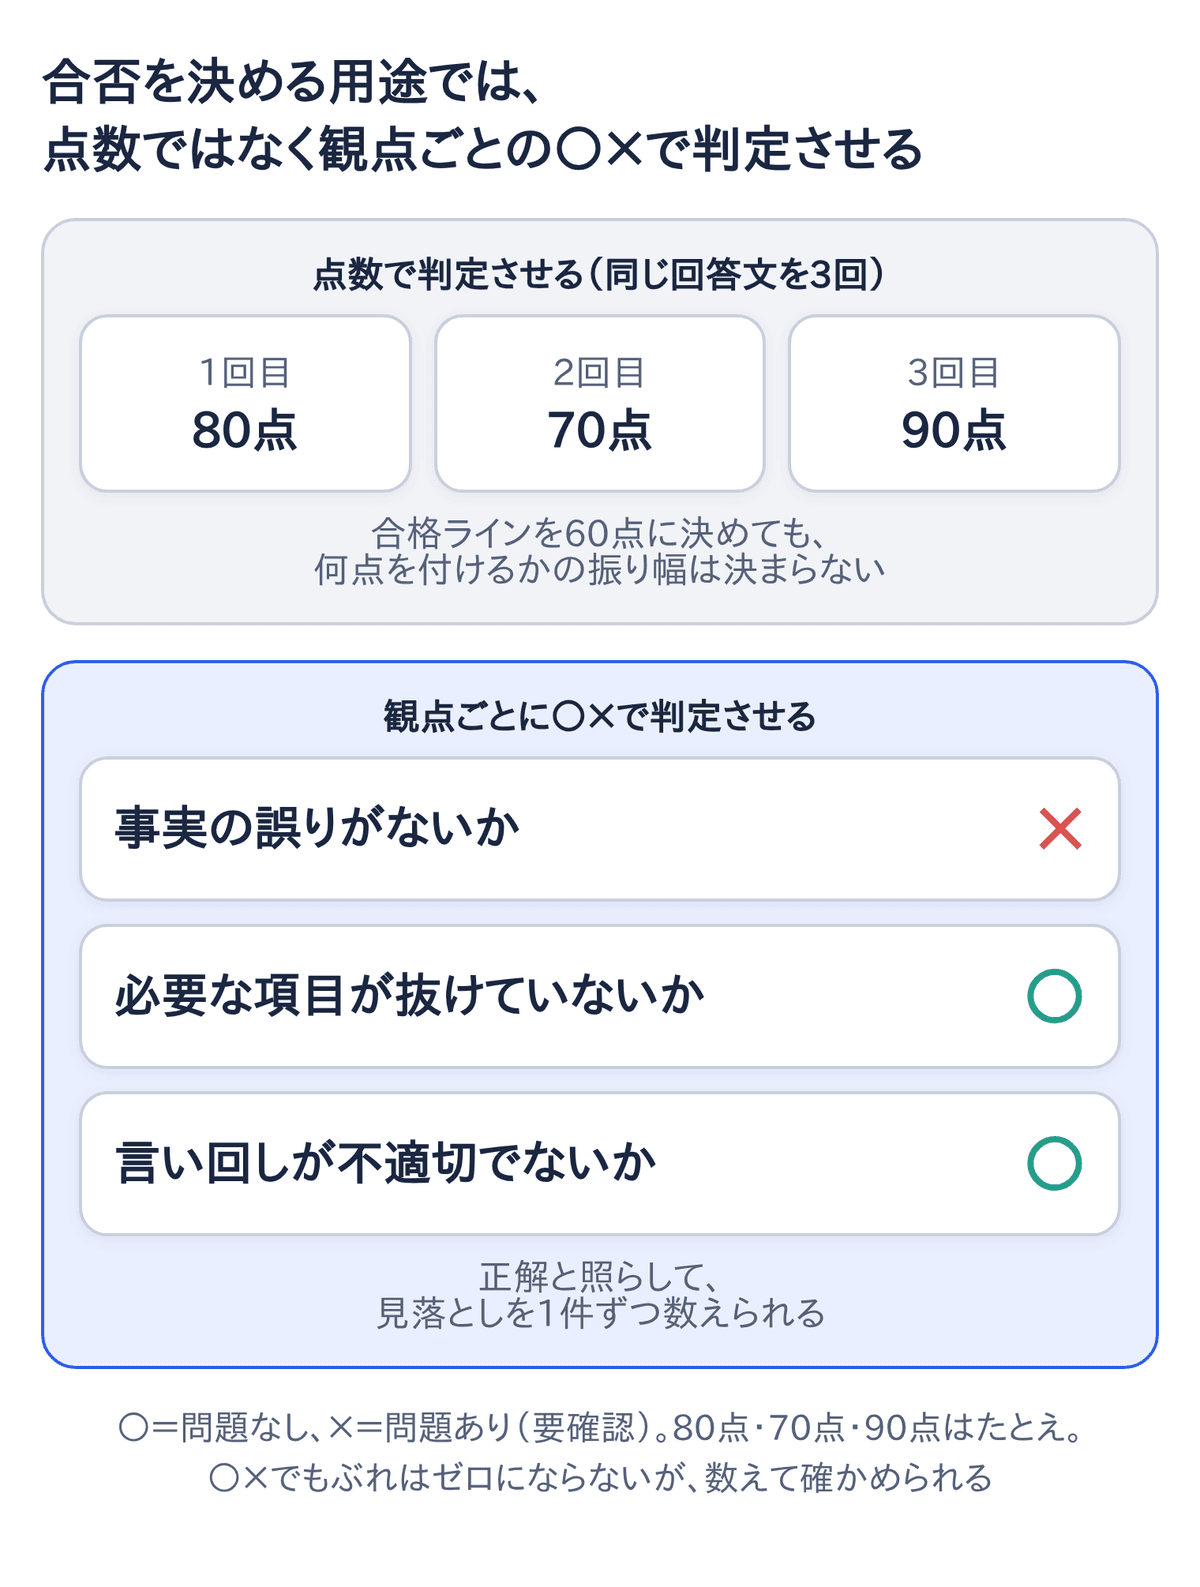
AIに判定させるとき、「100点満点で採点させ、60点以上を合格にする」というやり方を考えるかもしれません。しかし、合否を決めて見落としを数える用途では、AIに点数を付けさせるのはやめたほうがよいです。理由は2つあります。
1つ目は、点数がぶれることです。同じ回答文を同じ問いで採点させても、AIはそのたびに、たとえば80点、70点、90点と違う点数を付けます。基準が曖昧なまま点数を付けさせると、その曖昧さが点数のぶれとして残り続けるのです。
点数がぶれることは、複数の研究で示されています。同じ設定で3回採点させても判定が揃わないこと、温度(AIの答えのばらつきを決める設定)を0にしても点数がぶれることが報告されています。ぶれとは別に、AIが付ける点数がいくつかの決まった値に偏りやすい、という報告もあります。
2つ目は、合格ラインを決めても、点数の付け方までは決まらないことです。合格ラインを60点にしても、それは「どこで切るか」を決めるだけです。AIが同じ回答文に付ける点数を上下にどれくらい動かすかまでは決められません。
○×なら、少なくとも「本当は間違っているのにOKと言う見落とし」があるかを、正解と照らして1件ずつ数えられます。ミスの損害を見積もるときは、この見落としの件数が進め方の出発点になります。
AIの評価方法に詳しい実務家や、ChatGPTを提供するOpenAI社の公式の手引きも、点数ではなく合否で判定させるよう勧めています。そのうえで、人が付けた正解と照らして判定の一致を確かめてから、使う範囲を広げるよう書いています。
ただし、○×ならぶれない、とは言えません。○×で判定させても、判定がぶれる例は報告されています。○×の利点は、ぶれをなくせることではなく、ぶれや見落としを1件ずつ数えて確かめられることです。一方で、文章の細かな出来の良し悪しを比べる用途では、5段階の評価のほうが人の評価とよく合ったという研究もあります。○×を勧めるのは、合否を決めて見落としを数える用途に限っての話です。
必須ではありませんが、次の2つも勧めます。
- 観点ごとに、どこまで許すかを決める
- 人どうしの判定が一致するかで、基準が明確かを確かめる
どこまで許すかは、誰がどう使う出力かで決まります。社外に出す回答文と社内のメモでは、許す範囲が違います。これは業務として決めることで、要件定義の中の業務要件に含まれます。要件定義は、業務とシステムが何を満たすべきかを確定させる段階です。そのうち業務として決めるものが業務要件で、第4回(要求定義と要件定義の違い:AI導入で何を作るかの決め方)で扱いました。
基準が明確かは、たとえば同じ30件の回答文に2人が○×を付けて確かめます。判定が割れたら、曖昧なのは基準のほうです。割れた件を見ながら、基準の文を書き直します。人どうしで割れる基準のままでは、AIの判定が正しいかも確かめられません。
見落としの影響を、時間と金額に直す
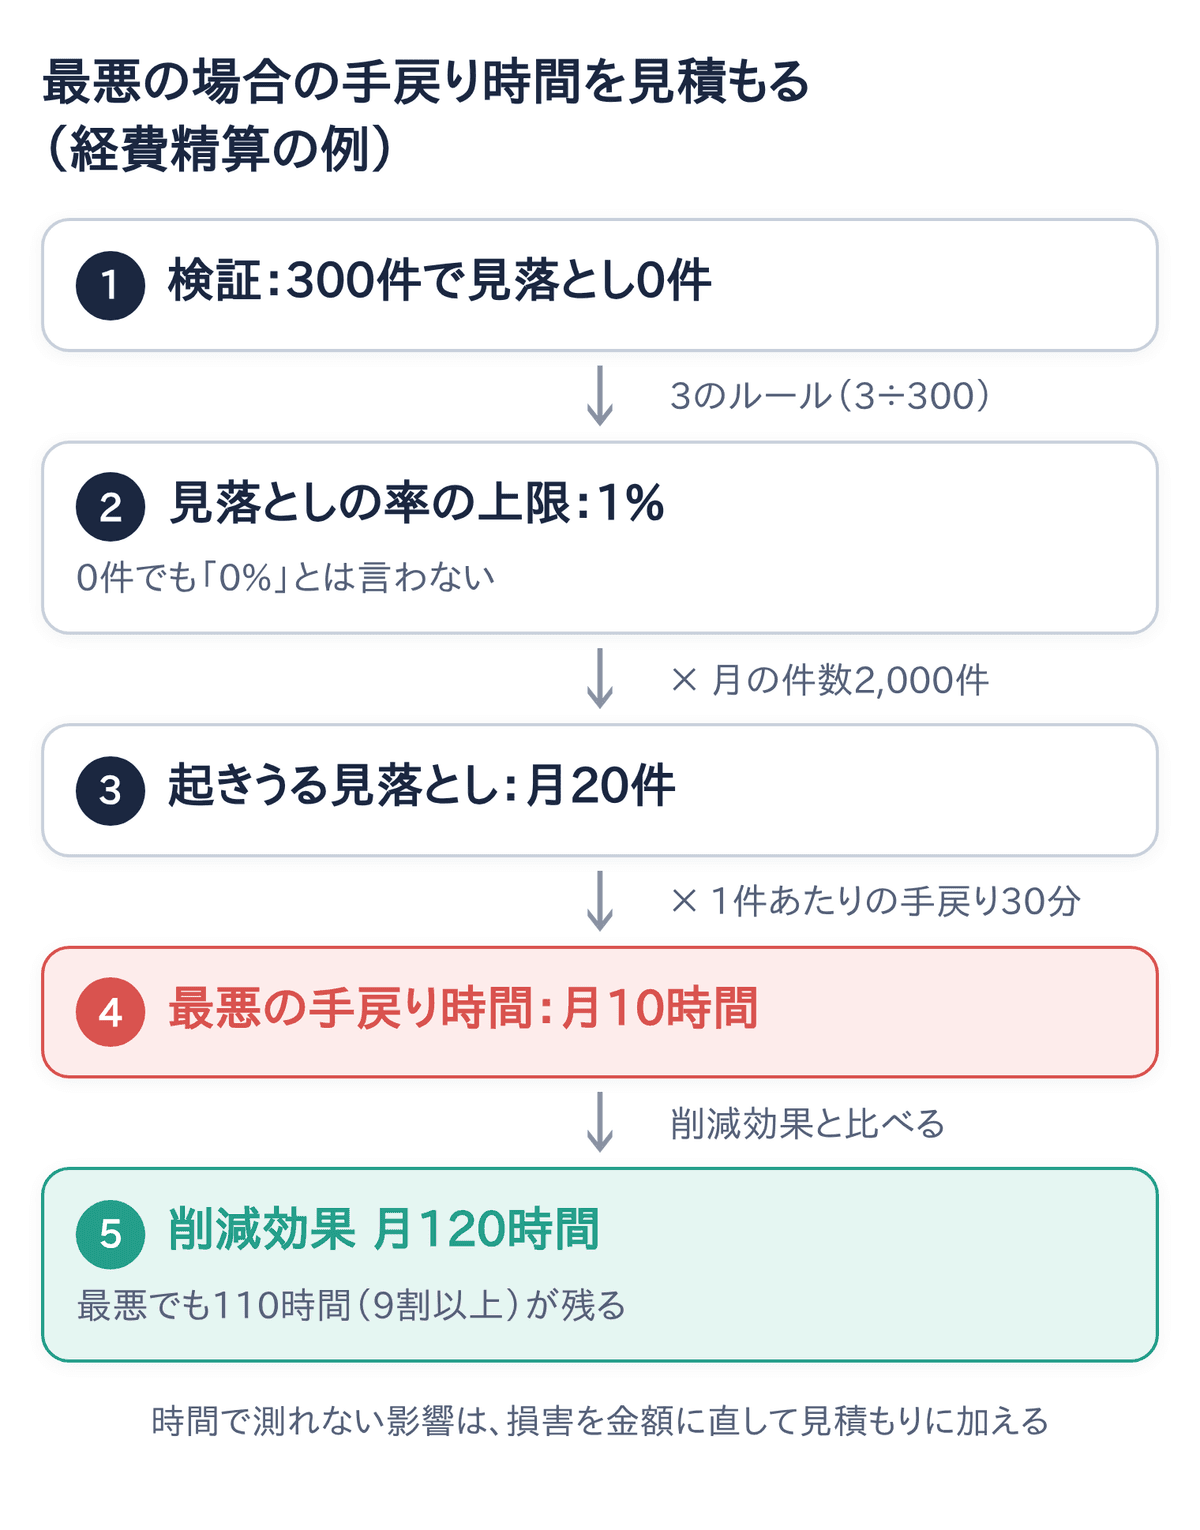
検証で見落としが1件も出なかったときも、「見落としは0%」とは言いません。たとえば300件を確かめて0件でも、本番で何千件と処理するうちに、起きる可能性は残るからです。そこで、統計的に言える上限を使って多めに見積もります。
上限の出し方には、統計で使われる「3のルール」という目安があります。1件も起きなかったとき、3を確かめた件数で割った値を、本当の発生率の上限とみなすものです。この上限は、95%の確からしさで成り立つとされます。300件で0件なら上限は1%(3÷300)で、確かめた件数が多いほど上限は小さくなります。
この上限の率に、月の件数と1件あたりの手戻り時間を掛けると、最悪の場合の手戻り時間が出ます。経費精算の申請が月2,000件なら、起きうる見落としは月20件です。1件の手戻りに30分かかるなら、最悪の手戻り時間は月10時間になります。
これを、AIで減る作業の時間(削減効果)と比べます。削減効果が月120時間なら、最悪の場合でも110時間、効果の9割以上が残る、と示せます。
1件あたりの手戻り時間は、AIがOKとした後に誤りが見つかったときの手順を決めてから測ります。誰が何を確認し直し、どう直すのかを明らかにします。経費精算なら、経理が支払いの後で誤りに気付き、申請者に事情を聞いて、差額を精算し直すといった流れです。この流れにかかる時間を現場に聞き、1件あたりの手戻り時間にします。
あわせて、AIの判定の後にも人が確認する工程があるかを示します。経費精算なら、支払いの前に上長の承認や経理の確認があるかどうかです。
時間では測れない影響もあります。取引先に誤った金額を出してしまう、取引先や社員からの信頼を損なう、といったものです。これらは、起きたときの損害を金額に直し、最悪の場合の見積もりに加えます。
たとえば、取引先への請求書を誤った金額で出してしまったとします。訂正して出し直す作業は1時間で済んでも、それだけでは損害を測りきれません。「起きたら1件あたり最大50万円の損害」のように金額を置けば、手戻り時間の見積もりと並べて比べられます。
ここで一番大事なのは、漠然とした理由で評価から逃げないことです。「信頼に関わるから」「重要な業務だから」で検討を止めず、時間か金額に直します。直せば、削減効果と同じ単位で比べられます。
誤らせにくい作りと、運用での見直し
見落としの見込みは、AIの作り方でも変わります。推進担当が自分で作るなら次の点を作り込み、ベンダーに頼むなら作りに入っているかを確かめます。
- 金額の計算や数値の突き合わせは通常のプログラムで行い、計算が合っているかの確認もAIにはさせない。AIに任せるのは、書類から文字を読み取る、表記の違う名前が同じ相手かを見分けるなど、決まった手順にできない作業だけ
- 判定できないもの(書類がそろわない、判定に要る値が無い)は無理にOKにせず、理由を添えて人に回す
- 判定ごとに、どの書類のどの値と比べたかという根拠を残す
- 人がAIの判定を直したら、その修正が後の自動処理で上書きされないようにする
検証で出した数字は、あくまで見込みです。本番で使い始めたら、要確認になった割合と見落としの件数の実績を取り、見込みを更新します。要確認の割合が想定より高いと人が確かめる件数が増え、削減効果が下がります。
ガードレールで、損害の上限を決める
AIが社外に影響する操作を自分で実行する業務では、損害がどこまで膨らむかを見積もりにくくなります。広告の入稿(出す広告や予算を、配信サービスに登録すること)が、その例です。そこで使うのがガードレールです。ガードレールとは、AIが実行できる操作に、あらかじめ条件を付けておくことです。
広告の入稿で考えます。AIが入稿できる予算の上限を1日10万円とし、選べる広告戦略(クリック数を増やす、認知を広げる、といった配信の方針)も決めた2つに限ります。条件を外れる操作は実行されません。
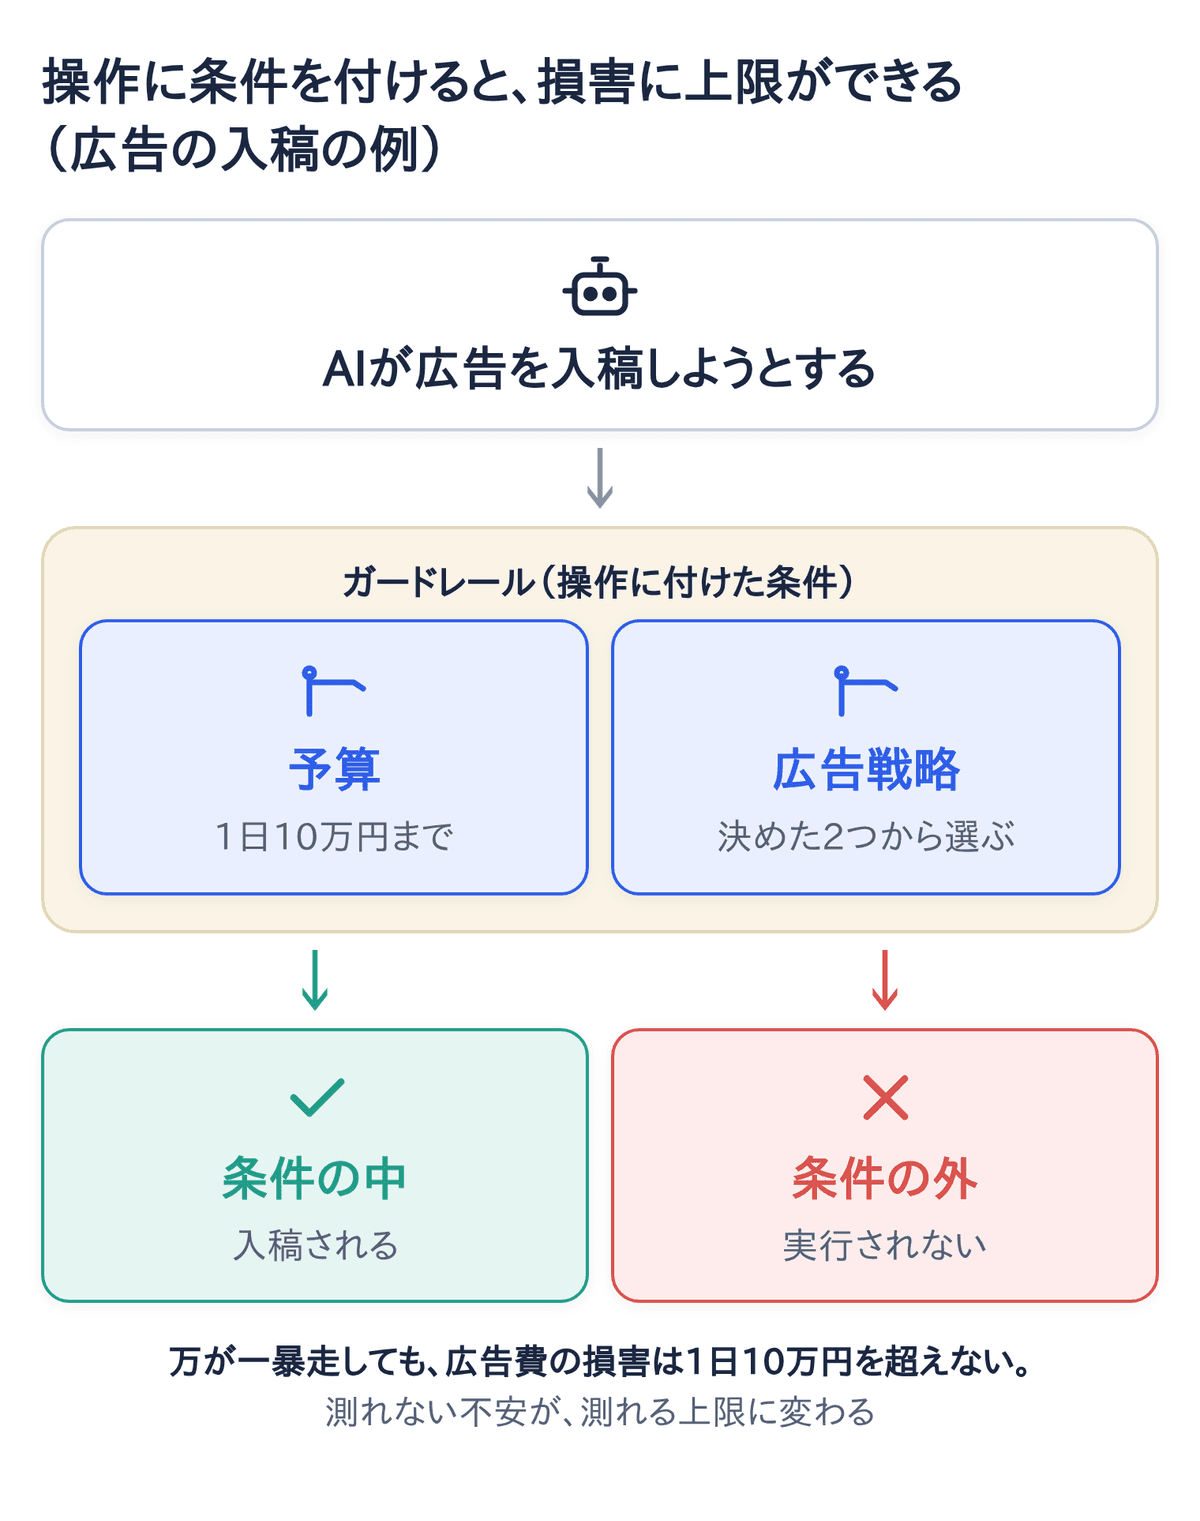
こうしておけば、万が一AIが暴走しても、損害には上限があります。暴走とは、たとえば成果の出ていない広告に予算を積み増し続けるような動きです。そうなっても、使われる予算は1日10万円で止まります。予測できるリスクの範囲で、広告の運用を自動化できるのです。
上限が決まれば、「どこまで損をするか分からない」という測れない不安が、「多くても1日10万円」という測れる上限に変わります。前の節の最悪の場合の見積もりも、この上限から組み立てられます。ベンダーに頼む場合は、AIが実行できる操作と、その操作に付けられる条件を確かめます。
リスクとメリットを並べて、組織で許容を決める
ここまでの材料を、リスクとメリットに分けて1つの表に並べます。リスクは見落としによる損害で、メリットは工数削減の効果と売上の向上です。工数削減の効果には、第5回(業務フローの作り方と、AI導入のROIの出し方)のやり方で出したROIを使います。ROIは、投資に対してどれだけ効果が返るかを表す指標です。売上の向上は、浮いた時間を売上を生む仕事へ回した効果です。これは第9回(AIで人を減らさずに成果を出す、リソースシフトとリスキリングの考え方)で扱います。
側 | 並べるもの | 出し方 |
|---|---|---|
リスク | 最悪の手戻り時間 | 見落としの上限の率 × 月の件数 × 1件あたりの手戻り時間 |
リスク | 時間で測れない損害 | 起きたときの損害を金額に直す |
リスク | 損害の上限 | ガードレールで決めた条件 |
リスク | AIの後の人の確認 | 承認や経理の確認があるか |
メリット | 工数削減の効果 | 第5回のやり方で出したROI(時間の削減) |
メリット | 売上の向上 | 浮いた時間を売上を生む仕事へ回した効果(第9回) |
この記事の経費精算の例なら、リスク側は最悪で月10時間の手戻りと、誤った支払いが起きたときの損害額です。AIの判定の後には、上長の承認と経理の確認があるとします。メリット側は月120時間の作業の削減です。これを並べれば、受け入れるかどうかを数字の上で話し合えます。
許容するかどうかを決めるのは、推進担当一人ではなく組織です。推進担当の仕事は、組織が決められる形に材料をそろえることです。
冒頭で、AIのミスが怖いのは責任の所在が見えないからだと書きました。リスクとメリットを並べ、受け入れるかどうかを組織で決めることは、ミスのリスクを組織として引き受けると決めることでもあります。この決定から逃げると、漠然とした不安が残り、AXを進める妨げになります。
推進担当が押さえる要点
- 人間もミスをする。AIのミスが怖いのは、責任の所在が見えないから
- 精度は「人の確認が要るか」の○×で数え、見落としと空振りを分ける
- ベンダーには「精度95%」のような1つの数字ではなく、4つの数を出してもらう
- 事実の誤りは必ず○×で判定する。合否を決める用途では、点数ではなく○×で判定させる
- 見落としが0件でも0%と言わず、統計的な上限で最悪の手戻り時間を出す
- 漠然とした理由で評価から逃げない。時間で測れない影響は損害額に直す
- ガードレールで操作に条件を付け、損害の上限を決める
- 許容を決めるのは組織。推進担当は、決められる形に材料をそろえる
まとめ:漠然とした不安を、決められる材料に変える
人間もミスをします。それでもAIのミスが怖いのは、AIが間違えたときの責任の所在が見えないからです。この記事では、その怖さを、組織が決められる材料に変える手順を見てきました。見落としを○×で数え、影響を時間と金額に直し、ガードレールで損害の上限を決めれば、リスクとメリットを1つの表で比べられます。許容を決めるのは推進担当一人ではなく組織で、それはミスのリスクを組織として引き受けることでもあります。どの手順も、漠然とした理由で評価から逃げないためのものです。
次回の第7回(AI導入の費用相場と予算の取り方、ベンダーの選び方)では、どこに頼み、予算をどう取るかを扱います。
シリーズの目次
- AXとは?DXとの違いと、AIを前提に業務を組み直す考え方 〜AX推進入門 第0回〜
- 生成AIを全社員に配っても使われない理由と、利用率を上げる進め方 〜AX推進入門 第1回〜
- AX推進の体制づくりと、推進担当が着任して最初にやること 〜AX推進入門 第2回〜
- AI導入の進め方:7つのステップと、人とAIの分担 〜AX推進入門 第3回〜
- 要求定義と要件定義の違い:AI導入で何を作るかの決め方 〜AX推進入門 第4回〜
- 業務フローの作り方と、AI導入のROIの出し方 〜AX推進入門 第5回〜
- AIのミスはどこまで許容するか:精度の測り方とリスクの決め方 〜AX推進入門 第6回〜(この記事)
- AI導入の費用相場と予算の取り方、ベンダーの選び方 〜AX推進入門 第7回〜
- AXが進まない会社で、上と現場を動かして社内合意をつくる方法 〜AX推進入門 第8回〜
- AIで人を減らさずに成果を出す、リソースシフトとリスキリングの考え方 〜AX推進入門 第9回〜
関連記事
- AIエージェントの責任は誰が負う?システムと運用の責任分界:AIが間違えたときの責任の所在を、システムと運用に分けて整理しています
- AIエージェントの権限設計|オントロジーで「やっていい操作」を定める:この記事のガードレール、つまりAIに許す操作と条件の決め方を詳しく扱います
- AIエージェントの承認はどの粒度で?承認疲れと自動承認ルール:AIの判定の後に人が確認する工程として、承認をどこに入れるかを扱います
- 業務フローの作り方と、AI導入のROIの出し方 〜AX推進入門 第5回〜:リスクと並べるメリット側の数字を、この回で出しています
参考資料
- Haldar, Hockenmaier「Rating Roulette: Self-Inconsistency in LLM-As-A-Judge Frameworks」(Findings of EMNLP 2025、2025年10月、https://arxiv.org/abs/2510.27106 (2026年11月9日確認))
- Lau「Same Input, Different Scores: A Multi Model Study on the Inconsistency of LLM Judge」(2026年、https://arxiv.org/abs/2603.04417 (2026年11月9日確認))
- Liu et al.「G-Eval: NLG Evaluation using GPT-4 with Better Human Alignment」(2023年3月、https://arxiv.org/abs/2303.16634 (2026年11月9日確認))
- Min et al.「FActScore: Fine-grained Atomic Evaluation of Factual Precision in Long Form Text Generation」(EMNLP 2023、2023年5月、https://arxiv.org/abs/2305.14251 (2026年11月9日確認))
- Hamel Husain「Using LLM-as-a-Judge For Evaluation: A Complete Guide」(2024年10月、https://hamel.dev/blog/posts/llm-judge/ (2026年11月9日確認))
- OpenAI「Evaluation best practices」(https://developers.openai.com/api/docs/guides/evaluation-best-practices (2026年11月9日確認))
- Nandwani, Gakhar「Ask, Then Grade: When Graded Scales Beat Binary Decomposition for LLM-as-Judge Evaluation」(NeurIPS 2026 Workshop、2026年、https://neurips.cc/virtual/2026/161241 (2026年11月9日確認))
Askhubについて
Askhubは、日本の中堅・大企業がAIに業務を任せるための基盤です。業務の型(オントロジー)でAIに許す操作を定め、承認と判断ログで任せる範囲を広げながら、国産の基幹システムまで書き込めるようにします。導入はコンサルタントが伴走します。
この記事の言葉で言えば、Askhubは、AIが実行できる操作に条件を付けるガードレールと、判定ごとの根拠を残す記録を受け持つ基盤にあたります。
※Askhubのサービスに関する記載は、2026年11月時点の情報です。
AIの精度の確かめ方や、リスクの見積もり方を相談したい方は、お問い合わせからご連絡ください。
この記事を書いた人
この記事の内容について相談する
自社の業務でどう進めるか、相談したい方はこちらのフォームからご連絡ください。1〜2営業日以内に担当者よりご連絡します。