文章を書かないAIが、1か月半で一つのカテゴリになった
2026年9月15日、米国のTypeSafe AIという会社が「Jev(ジェブ)」というAIを発表しました。ChatGPTのように文章を書くのではなく、「はい・いいえ」「どれを選ぶか」「何点か」という判断だけを返すAIです。
それから1か月半のあいだに、OpenAI、Microsoft、Cloudflare(インターネットの通信基盤を提供する会社)、Amazon(AWS)、Perplexity(AI検索の会社)、Liquid AI(AIモデル開発の新興企業)が相次いで同じ種類のAIを出しました。AIの性能を測る団体Artificial Analysisは、このカテゴリ専用の指標「Decision Index」を10月に新設しています。「判断モデル」は、流行語ではなく一つの製品カテゴリになりつつあります。
この記事では、判断モデルの仕組みと各社の動きを、各社の公式資料(一部は報道)をもとに整理します。先に、私たちの見立てを3つ書いておきます。
- 判断モデルの価値は「賢い」ことではありません。ChatGPTのような文章を書くAIと同じくらいの判断を、ずっと安く速く返し、しかも「どれくらい自信があるか」を数字で添えることにあります
- 「ハルシネーション(AIがもっともらしい誤りを事実のように出すこと)をしない」と紹介されることがありますが、これは「渡した選択肢の外の答えを返さない」という意味で、「間違えない」という意味ではありません。TypeSafe自身の評価でも、答えの約3割は基準の答え(高性能なAIの答えで、人が確かめた正解ではありません)と一致していません
- 業務で使うなら、自信のある判断だけを自動で流し、自信のない判断を人や高性能なAIに回すという置き方が基本になります
では、Jevとは何をするものなのか。身近な例から見ていきます。
Jevは「選択肢の中から答えを選び、確率を添えて返す」AI
問い合わせ窓口に、こんなメールが届いたとします。
「先週注文した商品がまだ届きません。至急確認してください」
人なら数秒で「配送の問い合わせで、急ぎだ」と判断して担当に回します。この「判断して回す」部分だけを機械にやらせたい。それがJevの用途です。
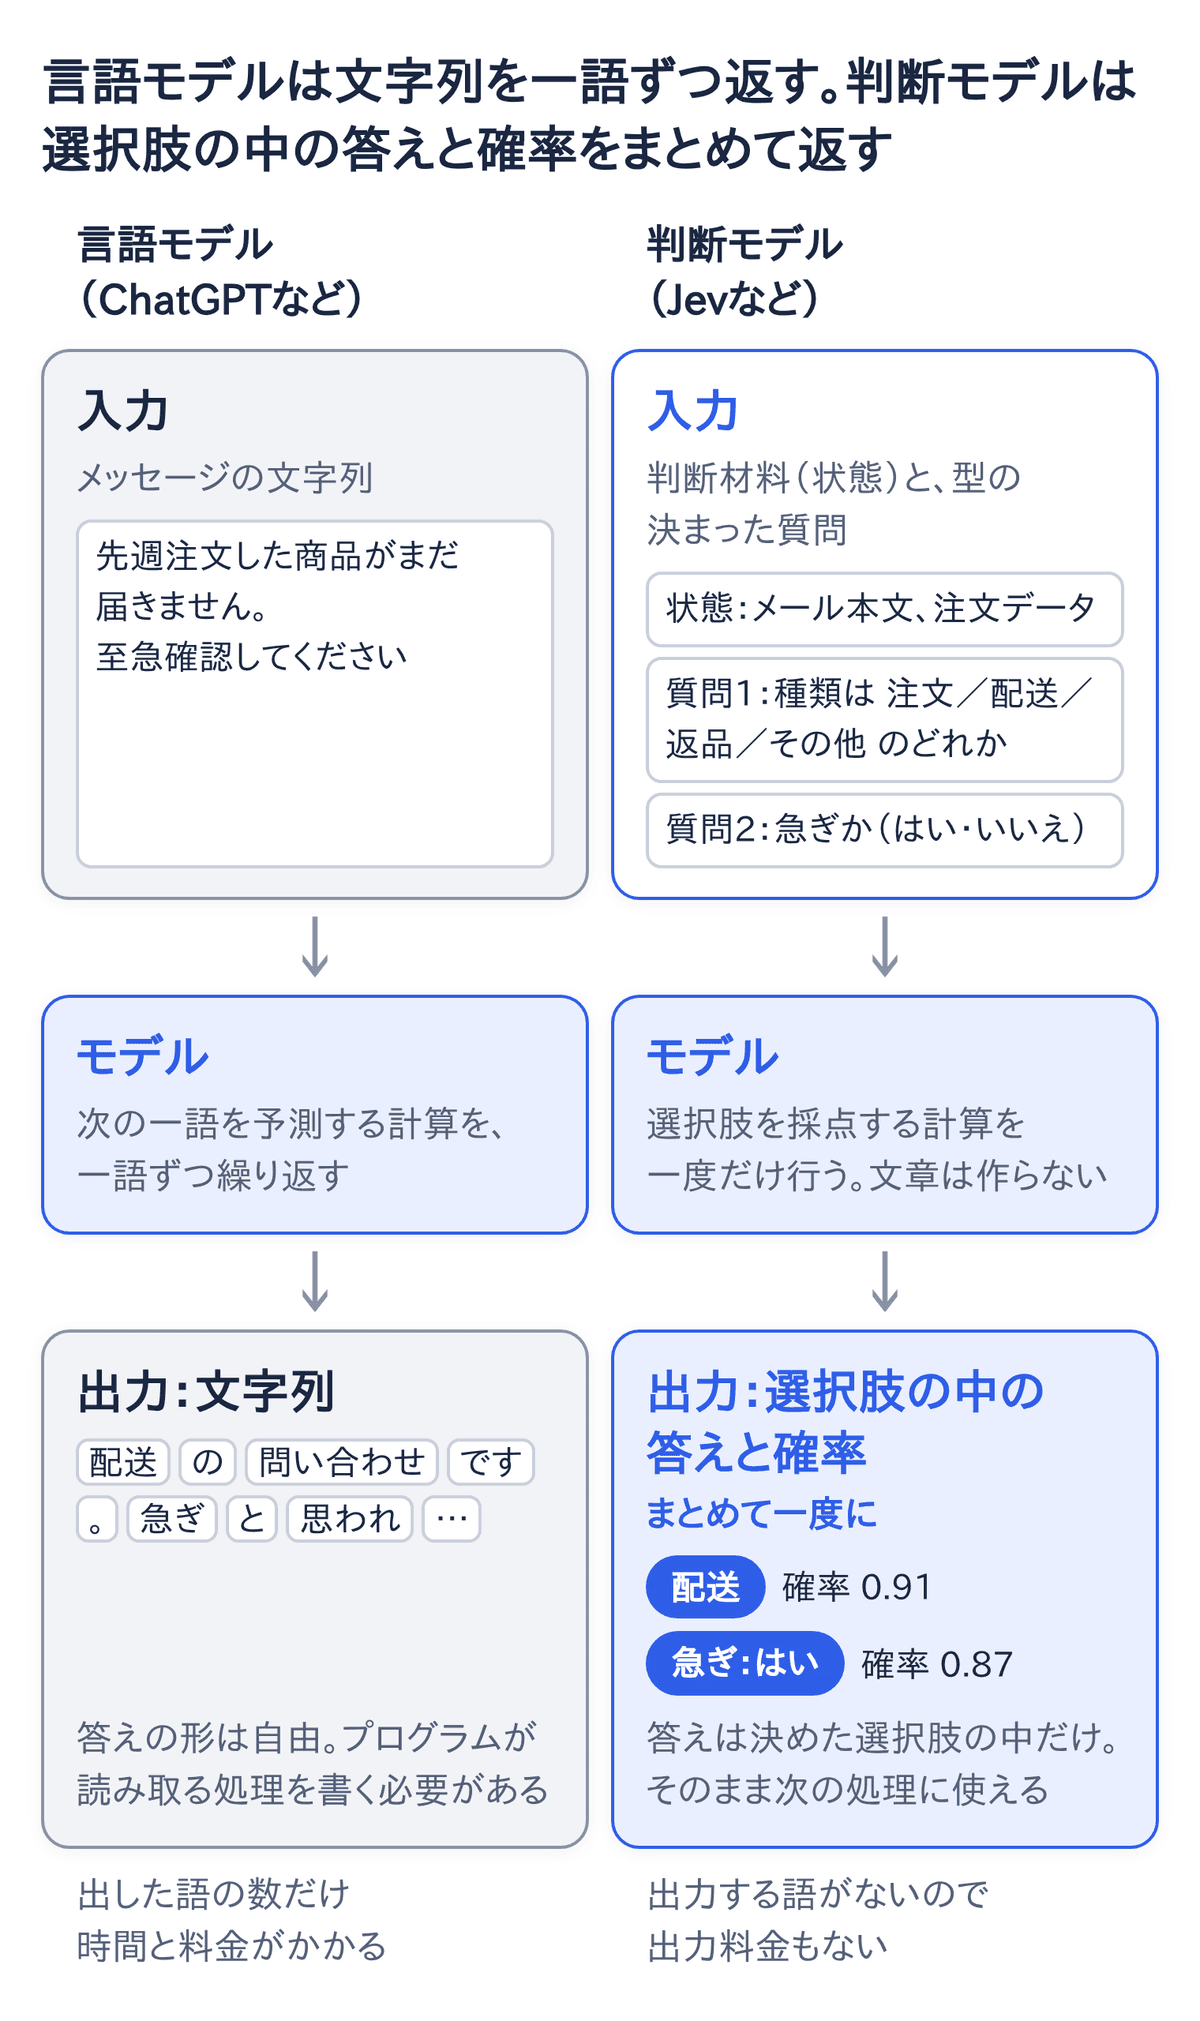
Jevには、メールの本文と、あらかじめ決めた質問を渡します。質問は「このメールの種類は、注文・配送・返品・その他のどれか」「急ぎか、そうでないか」といったものです。Jevは「配送(確率0.91)」「急ぎ(確率0.87)」のように、選択肢の中から答えを選び、その答えにどれくらい自信があるかを確率で添えて返します。文章は一文字も書きません。
TypeSafeの発表記事は、Jevを「ソフトウェアが直接使える、速くて構造化された判断を下すための新しい種類のモデル」と定義しています。「モデル」はAIの本体のことで、「構造化された」とは、答えの形が事前に決まっていて、プログラムがそのまま読める、という意味です。
提供形態は、TypeSafeのサーバー上で動くものをインターネット越しに呼び出す形だけです(この呼び出しの窓口をAPIと呼びます)。モデルの中身は公開されていません。AIは大量の例から答え方を身につける工程(学習)を経て作られ、その結果として残る数値の集まりを「重み」と呼びますが、Jevの重みは非公開で、大きさも公表されていません。
料金は、AIが文章を扱う単位「トークン」で数えます。日本語なら1トークンは1〜2文字くらいです(以下では分かりやすく「語」と書きます)。Jevは入力100万トークンあたり0.042ドルで、出力は無料です。
広がりは速く、複数のAIをまとめて呼べるサービス「AI Gateway」を提供するVercel社のデータでは、提供開始から14日間で、このサービスを有料で使う企業の35.3%がJevを使いました。一方で、利用料金に占める割合は0.27%です。「多くの会社が、ごく少額で使う」AIだということが数字に表れています。
言語モデルとの違いは「入力と出力の形」
ChatGPTやClaudeの中身は「大規模言語モデル」と呼ばれます。以下では「言語モデル」と略します。言語モデルは、文字列を入れると文字列が返る箱です。「ここまでの文に続く次の語は何か」を予測する計算を、一語ずつ繰り返して文章を組み立てます。
Jevは違います。入れるものは2つ。1つは「状態」と呼ばれる判断材料(メールの本文や注文データ)。もう1つは、答えの形が決まった「質問」です。返ってくるのは、質問ごとの答えと確率です。
この形の違いから、大事なことが2つ言えます。
1つ目。Jevは、決めた選択肢の外の答えを返せません。「注文・配送・返品・その他」の4択なら、この4つ以外は返りません。プログラム側は答えを読み取る処理を書く必要がなく、返ってきた値をそのまま次の処理に使えます。
2つ目。Jevは文章を書けません。返信文を作る、要約する、説明するといった仕事はできません。言語モデルの代わりではなく、隣に置く部品だと考えてください。
質問の型は3つ。はい・いいえ、選択、採点
TypeSafeの公式ドキュメントは、質問の型を次の3つに整理しています。英語の名前はTypeSafeの呼び名です。表にある「確信度」は、その答えにどれくらい自信があるかを0〜1で表した数で、何を測った数なのかは後の節で説明します。
型 | 聞き方 | 返ってくるもの | 例 |
|---|---|---|---|
はい・いいえ(Noul) | この文は正しいか | 「はい」である確率(0〜1) | 「このメールは苦情か」→0.12 |
選択(Choice) | この中から1つ選べ | 選ばれた選択肢と、各選択肢の確率、確信度 | 「種類は注文・配送・返品・その他のどれか」→配送(0.91) |
採点(Score) | この尺度で何点か | 点数と、各点の確率、確信度 | 「緊急度を1〜5で」→4 |
一度の呼び出しに複数の質問をまとめて入れられます。質問どうしは影響し合わず、同時に答えが出ます。ドキュメントは「質問を増やしても応答時間はほとんど変わらない」としています。
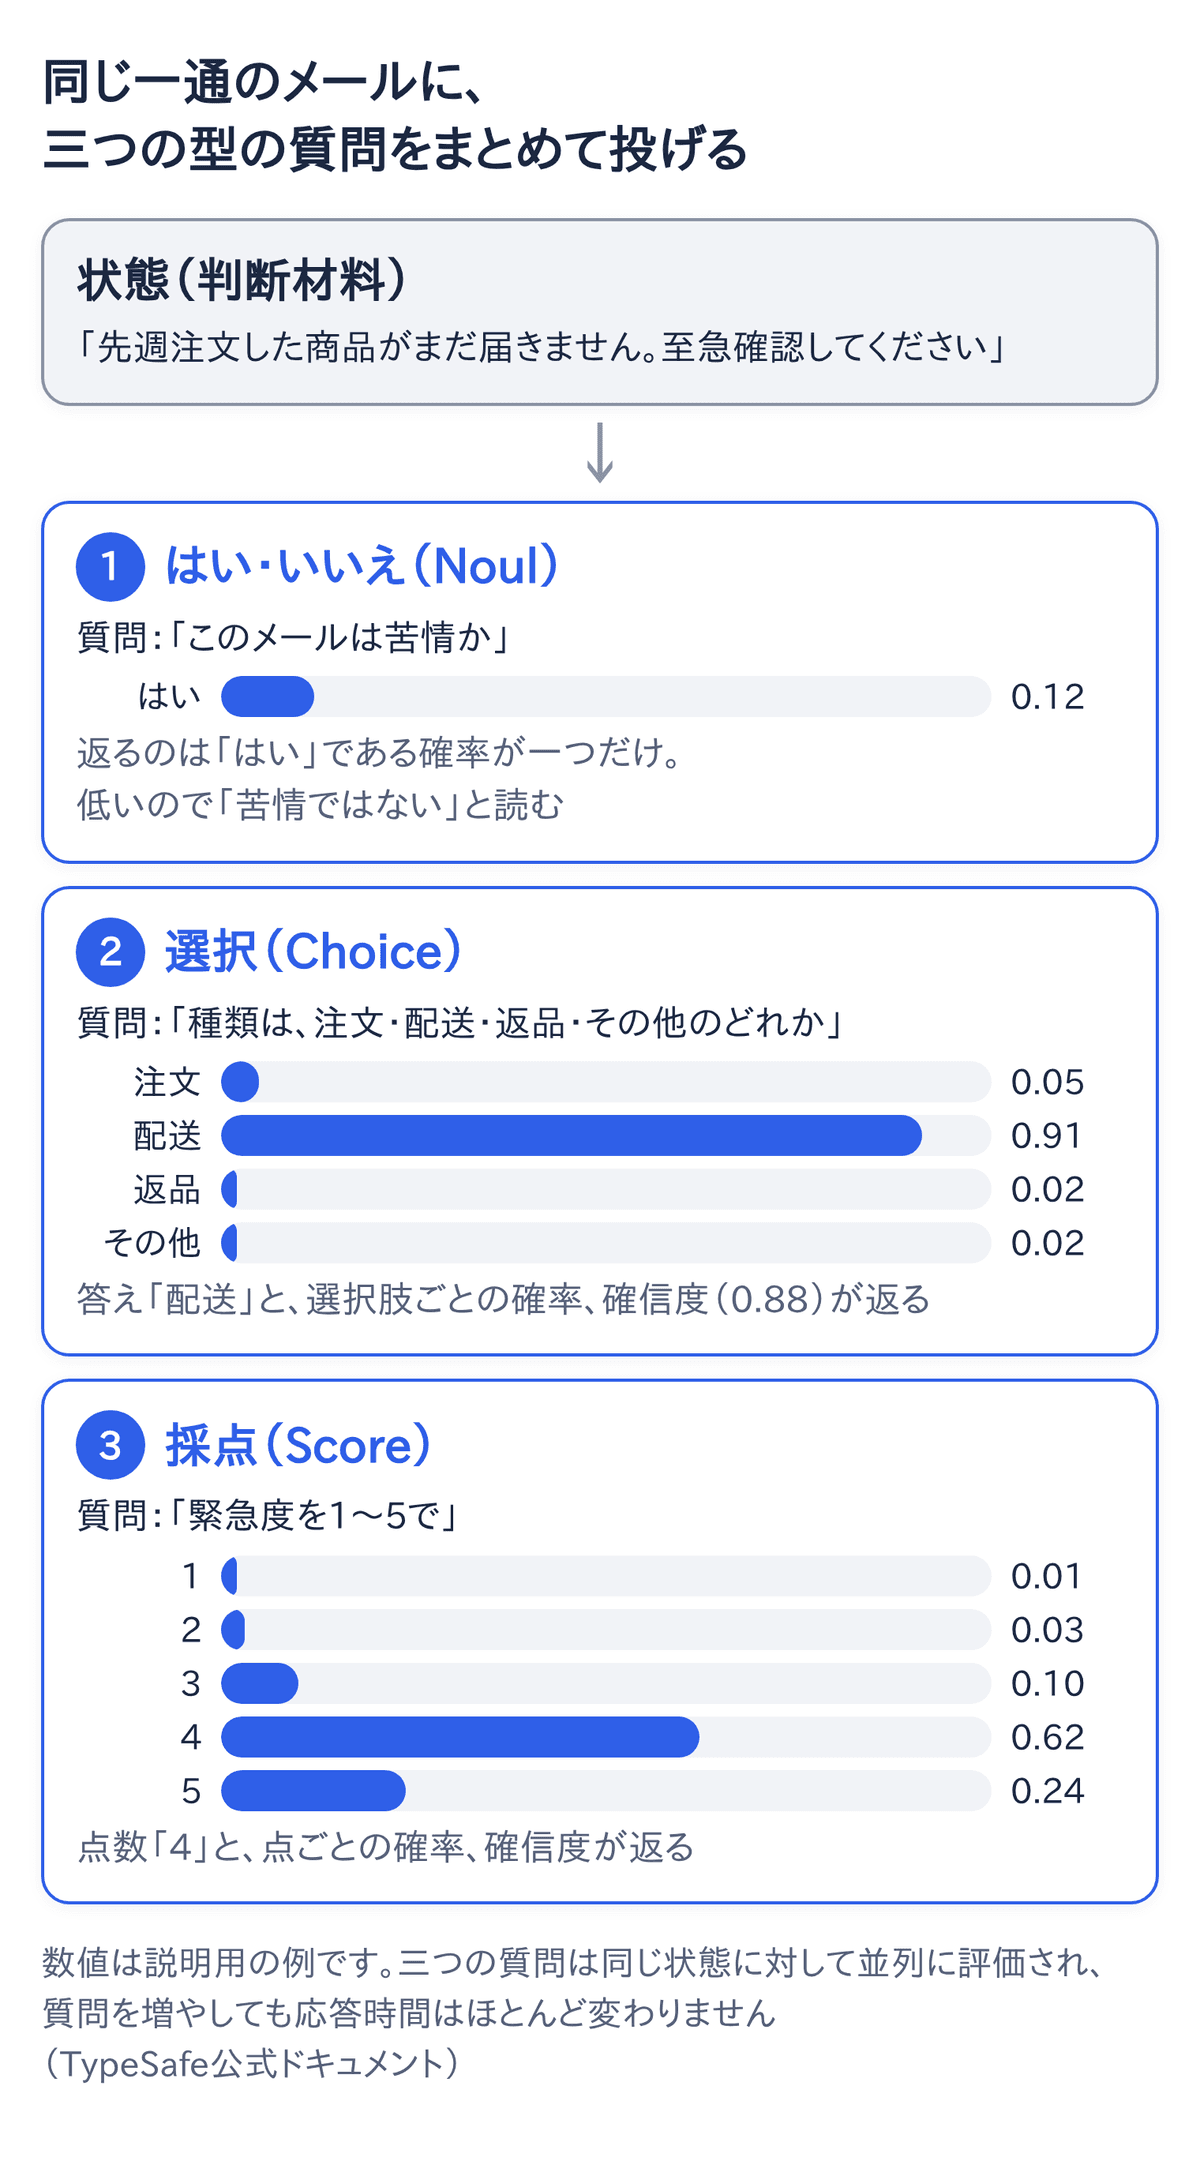
各社のドキュメントの型一覧を比べると、後から出てきたモデルもこの3つをほぼ同じ形で採用しています。判断モデルという考え方は、答えの型のレベルで事実上の標準になったと言えます。
なぜ速くて安いのか
言語モデルが遅く高い理由は、文章を一語ずつ作るからです。100語の答えなら100回の計算が要り、出した語の数だけ料金がかかります。
Jevは文章を作りません。発表記事によると、答えは「すべての出力を一度の問い合わせで生成する」方式で出ます。選択肢を採点するだけなので計算は一度で済み、出力する語がないので出力の料金もありません。
学習の仕方も違います。言語モデルの多くは、人が「良い」と評価した答えを出すように練習させます。TypeSafeはその副作用として「自信ありげに誤る」ことを挙げ、Jevは代わりに答えの確率が実際の正しさに合うように練習させたと説明しています。
Jevの内部構造は非公開ですが、後から出た重み公開のモデルは作り方を説明しています。CloudflareのClefは、公開済みの言語モデルを土台に、文章を生成する部品を外し、選択肢を採点する小さな部品を載せて学習しています。AWSやPerplexityのモデルも同じ構造です。言語モデルの「読む力」はそのまま使い、「書く力」を「選ぶ力」に付け替えたもの、と理解すると分かりやすいと思います。
速さの数字には幅があります。TypeSafeは発表時に「193.6倍速く、444.6倍安い」と書きましたが、同社が自分で作った業務での比較で、比較相手の言語モデルも同社の仕組み経由で呼んでいます。同社自身が「実際の業務で得られる効果の上限寄り」と注記しています。第三者のCloudflareが測ったJevの応答時間は、中央値(半分の呼び出しがこれより速い、という値)で524ミリ秒でした。
速さと安さは分かりました。次に、Jevが返す「確率」と「確信度」が何を表しているのかを押さえます。この記事でいちばん大事なところです。
確率と確信度は「答えの正しさ」ではない
TypeSafeのドキュメントは、2つの言葉を分けて定義しています。
確率は、選択肢ごとの数字です。「配送0.91、注文0.05、返品0.02、その他0.02」のように、合計が1になるように分かれます。一つに集中していれば自信が高く、ばらけていれば低い、と読みます。
確信度(confidence)は、この確率の並びを1つの数にまとめたものです。ドキュメントの式を見ると、選択の型ではいちばん高い確率しか見ていません。「答えが合っているか」を測った数ではなく、「確率がどれだけ一つに集中しているか」を表す数です。
そして「較正(キャリブレーション)」。これは「確率0.8を付けた答えは、たくさん集めればおよそ80%が正しい」という性質です。ドキュメントは、これがたくさんの答えを集めたときの性質であって、一つひとつの答えについての保証ではないと明記しています。
つまり、Jevの数字はこう読みます。「この答えは正しい」ではなく、「同じくらいの自信で出した答えを100件集めると、だいたい何件が合っているか」。この読み方が、次の話につながります。
「ハルシネーションしない」をどう読むか
Jevは「ハルシネーションしないAI」として紹介されることがあります。もとはTypeSafeの発表記事で、Jevは「文字列の生成をやめたので、ハルシネーションできない」とあり、公式サイトにも「Zero Hallucinations」という見出しがあります。
ただ、発表記事の図には、答えの形(スキーマ)について、こういう注記が付いています。
この数字は実測ではない。スキーマへの一致が保証されているので、自信を持って0%を図に入れられる
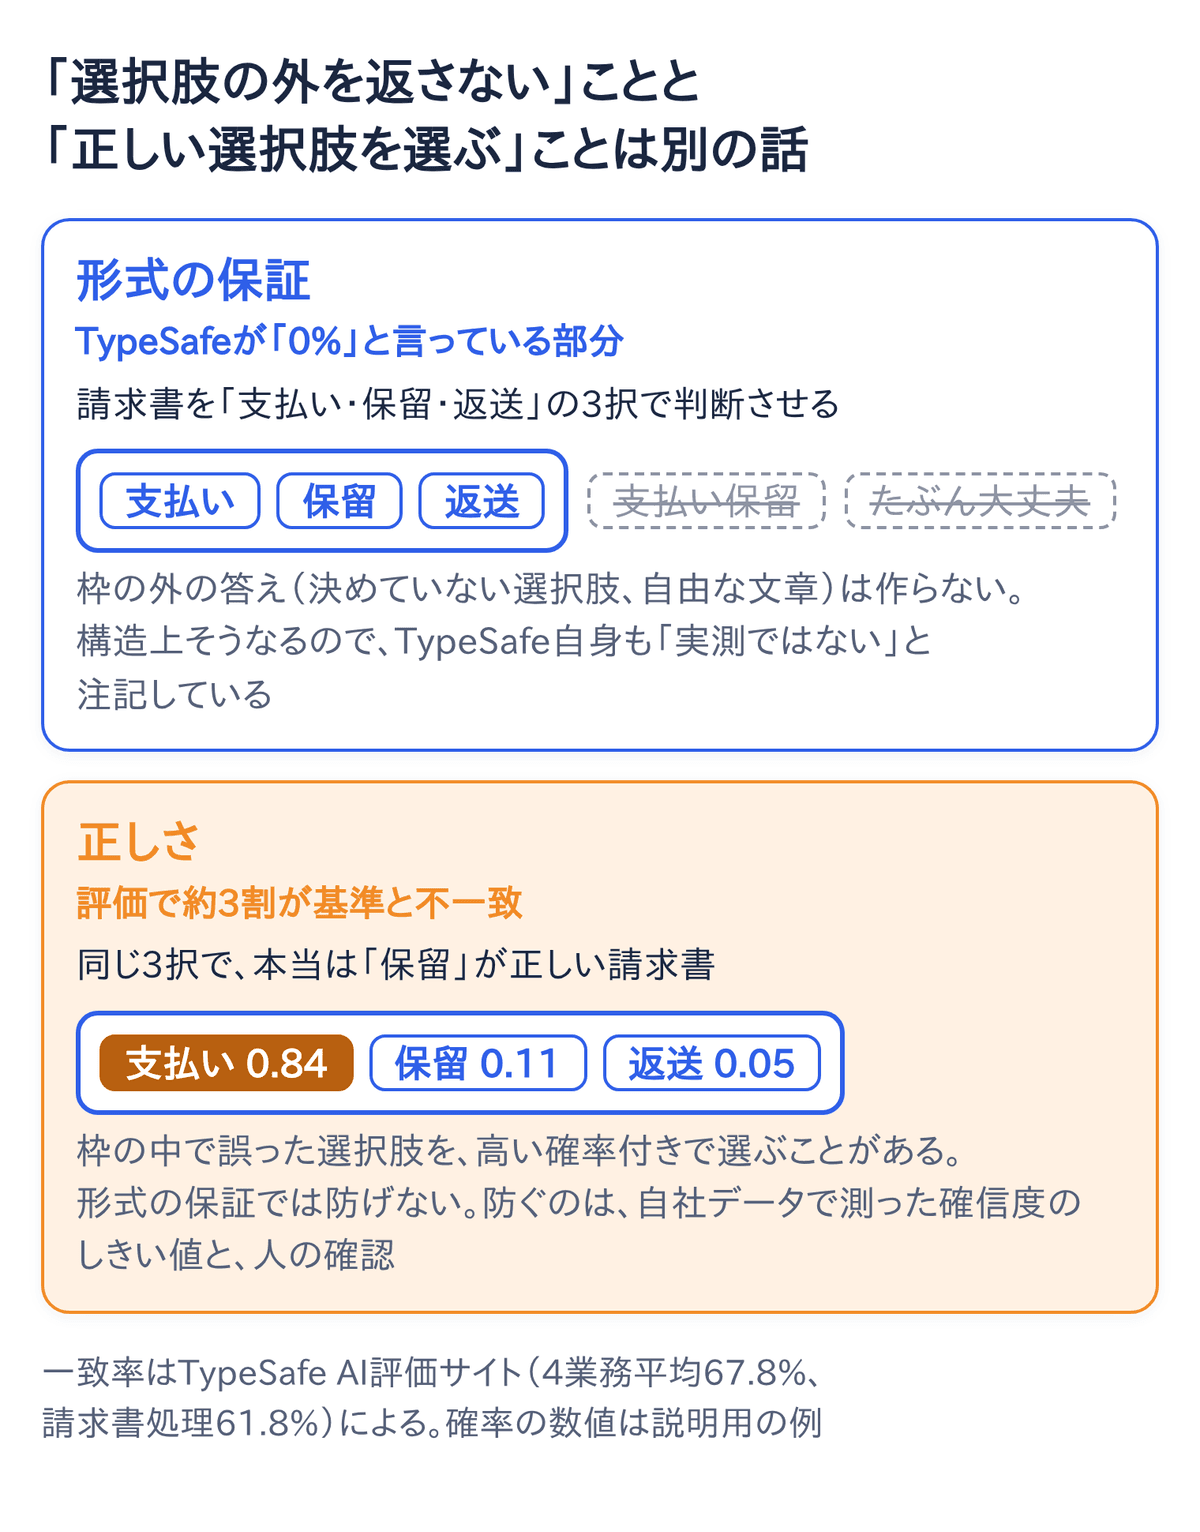
つまりTypeSafeが言う「ハルシネーション」とは、「決めた選択肢の外の答えを返すこと」を指しています。4択で5つ目の答えを作らない、という意味の0%で、「正しい選択肢を選ぶ」ことは含まれていません。
では、正しい選択肢をどれくらい選べているのか。TypeSafeは評価サイトで、自分で作った4つの業務(セキュリティ事案の振り分け、AIの作業記録の監視、請求書の処理、カスタマーサービス)について、各モデルの答えが基準の答えと一致した割合を公開しています。
基準の答えは、人が作ったものではありません。高性能な言語モデル2種にじっくり考えさせた答えの平均です。
モデル | 4業務平均の一致率 | 1件あたり費用 | 1件あたり時間 |
|---|---|---|---|
GPT-6 Sol | 74.1% | 0.0836ドル | 23.3秒 |
Claude Opus 5 | 73.1% | 0.1761ドル | 37.8秒 |
GPT-5.6 Terra | 67.9% | 0.0304ドル | 10.1秒 |
Jev | 67.8% | 0.0004ドル | 0.4秒 |
GPT-6 Luna | 66.8% | 0.0033ドル | 12.9秒 |
出典:TypeSafe AI評価サイト(2026年11月3日確認)。費用はJevと比べて数十倍から数百倍、時間は数十倍の差です
Jevの一致率は業務によって61.7%から76.0%の幅があり、請求書の処理(61.8%)ではGPT-6 Solを17ポイント下回ります。一致しなかった約3割の答えも、すべて選択肢の中には収まっています。
TypeSafeの定義では、これは「ハルシネーションではない」。でも業務の側から見れば、「請求書を『支払い』と判断したが、本当は『保留』だった」は、まぎれもなく誤りです。
第三者の評価も同じ方向です。Artificial AnalysisのDecision Indexには、4択に「分からない」を加えた500問で、知らないことを聞かれたときに誤答せず「分からない」と言えた割合を測る項目があります。公開時点のJevの値は35%で、判断モデルの中では2位でした。裏返せば、知らないことを聞かれた問題の多くで、どれかの選択肢を答えています。
同じ記事は、判断モデルは総じて「過信ぎみ」で、申告した確率より実際の正答率が低い傾向があるとも述べています。
まとめると、Jevについて正確に言えるのは次の3つです。
- 決めた選択肢の外の答えは返さない(形式の保証)
- 誤った選択肢を選ぶことは普通にある。TypeSafe自身の評価では約3割
- 確率は「どれくらい当てになるか」の自己申告で、正しさの保証ではない。しかも少し過信ぎみ
「ハルシネーションしない」は、このうち1だけを指した言葉です。「間違えないAI」ではなく、「間違える可能性を数字で教えてくれるAI」と覚えておくのが正確です。
理由は返ってこない。弱点もある
Jevは、なぜその答えを選んだのかを返しません。言語モデルなら「『届きません』とあるので配送の問い合わせです」と説明できますが、Jevは「配送 0.91」という数字だけです。著名なソフトウェア開発者のSimon Willison氏は、数字の裏に偏りが隠れうることを懸念し、「誰もJevで求職者をランク付けしないことを強く願う」と書いています。
TypeSafeのドキュメントにも、Jevが自信を保ったまま誤りうる状況が「既知の荒さ」として列挙されています。
- 書かれた質問を文字どおりに読む。否定や暗黙の条件は額面どおり
- 計算機ではない。数え上げや日付の前後関係の判定は信頼できない
- 関係ない情報が増えると精度が落ちる
- 判断材料の中に「こう答えろ」という文が紛れていても、それを疑わずに読む(プロンプトインジェクションと呼ばれる攻撃です)
- 選択肢の順番に影響され、先頭の選択肢に寄る
理由を説明できず、こうした弱点がある。だからこそ、置き場所を選ぶ必要があります。その前に、各社の動きを見ておきます。
Jevの後に、各社が出した判断モデル
Jevの発表から1か月半で出てきた主なモデルを、時系列で並べます。
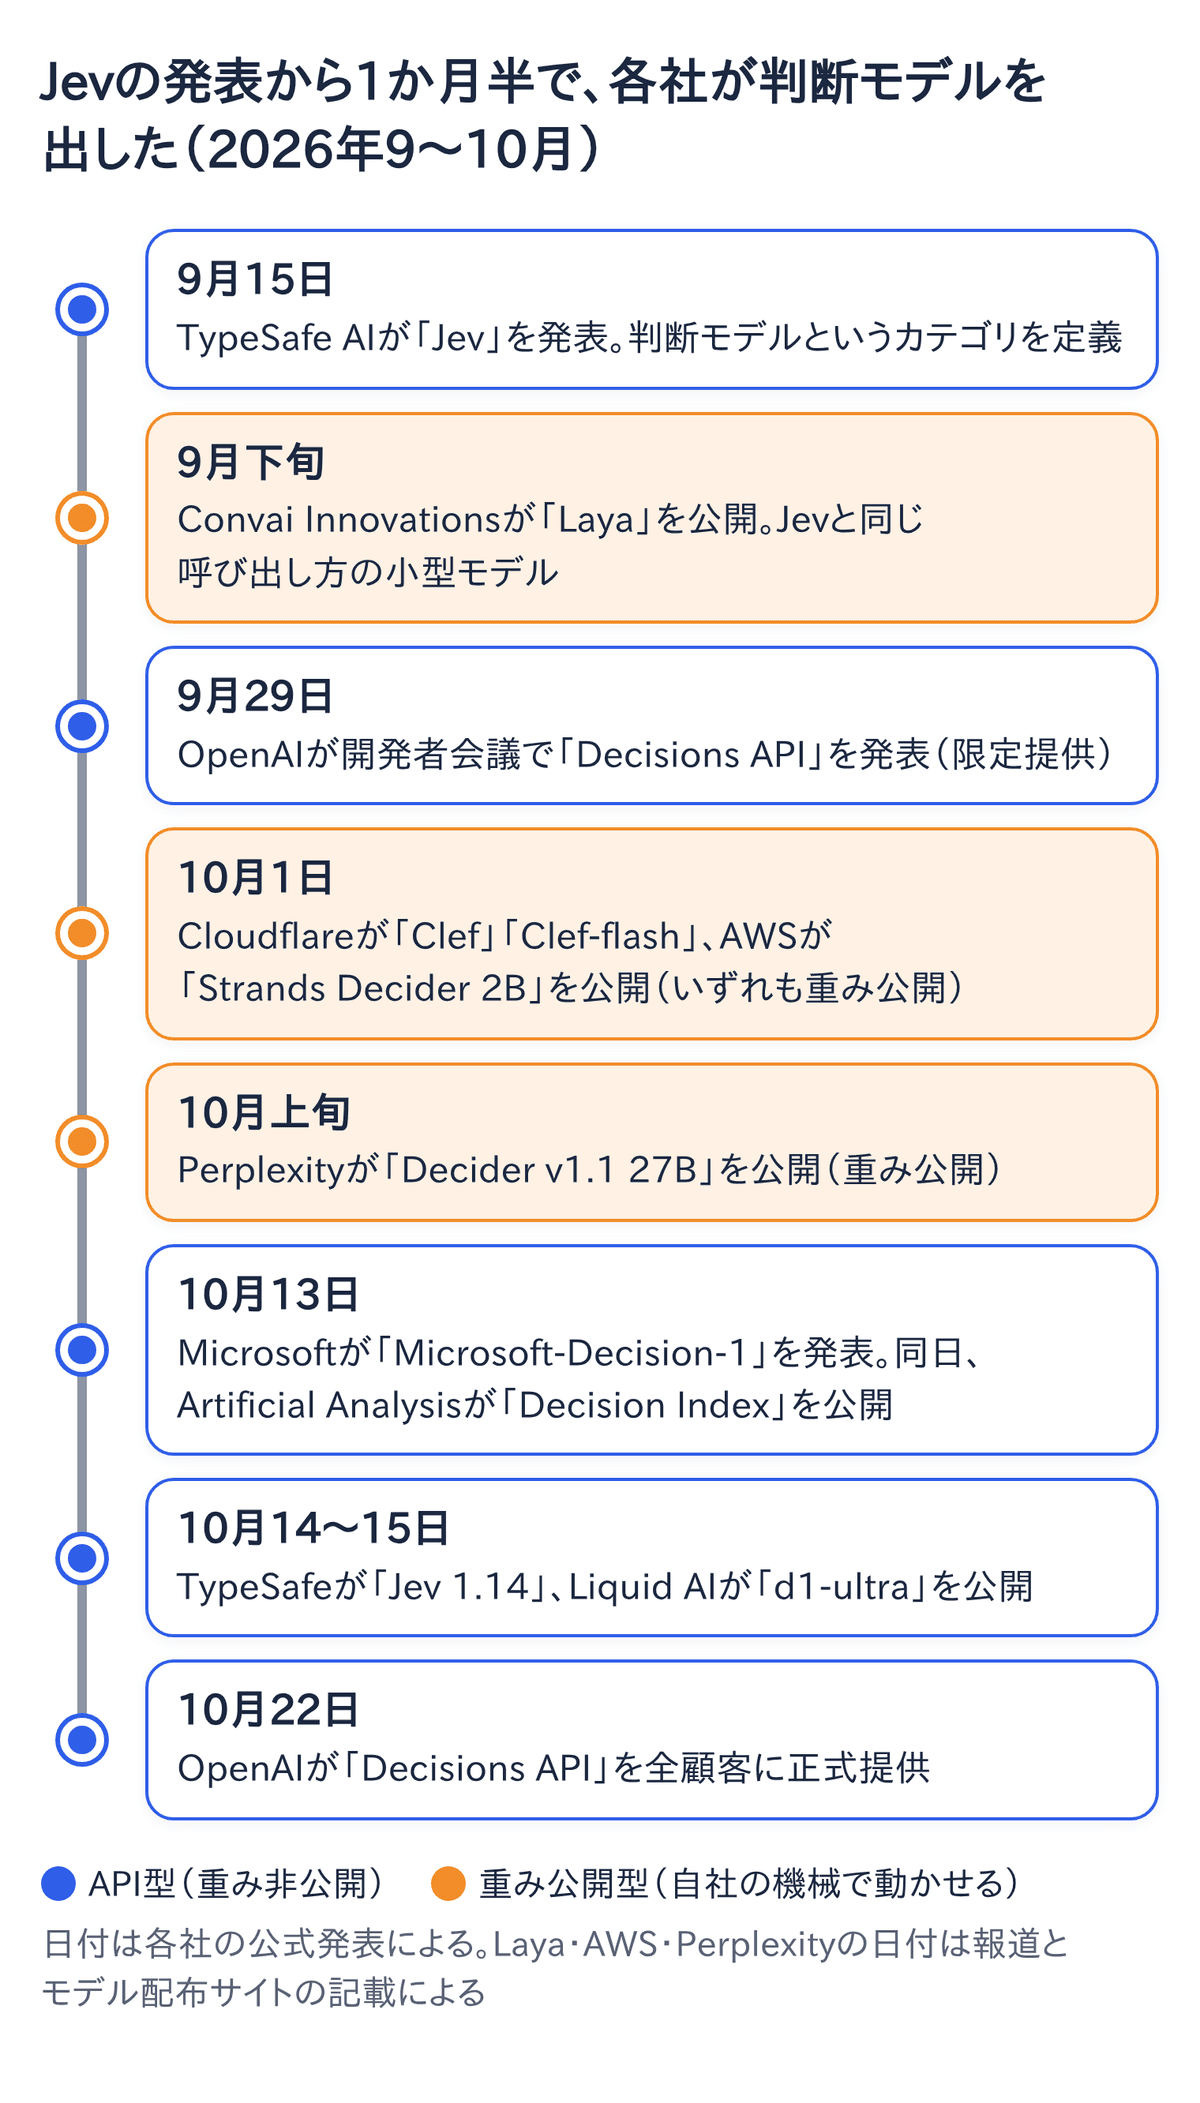
モデルは、提供形態で2つに分かれます。各社のサーバーで動くものを呼び出す「API型」と、モデルの重みが公開されていて自社の環境でも動かせる「重み公開型」です。
まず、API型です。判断材料は提供元のサーバーに送られます。
提供元 / モデル | 公開日 | 料金(入力100万トークン) | 特徴 |
|---|---|---|---|
TypeSafe / Jev 1.14 | 9月15日(1.14は10月14日) | 0.042ドル、出力無料 | 本家。画像入力は実験機能 |
OpenAI / Decisions API | 9月29日発表、10月22日正式提供 | 0.10ドル、出力無料 | 既存のGPT-6 Lunaを組み替えたもの。画像を入力できる。処理する地域を米国か欧州から選べる |
Microsoft / Microsoft-Decision-1 | 10月13日※ | 0.042ドル、出力無料※ | MicrosoftのAI提供基盤(Foundry)で提供 |
Liquid AI / d1-ultra | 10月15日 | 0.042ドル、出力無料 | 文字と画像。「Jevを全タスクで上回る」は同社の主張 |
※Microsoftの公式記事が取得できなかったため、InfoWorldの報道によります
次に、重み公開型です。いずれも商用利用も改変も自由な利用条件(Apache 2.0ライセンス)で公開されています。
提供元 / モデル | 公開日 | 大きさ | 特徴 |
|---|---|---|---|
Cloudflare / Clef、Clef-flash | 10月1日 | 270億 / 90億 | Jevと同じ呼び出し方で使える。Cloudflareの測定で応答の中央値はClef 209ミリ秒、flash 38.8ミリ秒 |
Perplexity / Decider v1.1 27B | 10月上旬 | 270億 | Decision Index 61.56(同じ測り方でJevは約58)をモデルの説明書に掲載 |
AWS / Strands Decider 2B | 10月1日※ | 20億 | 公開テスト231問中167問正答。「実験であり正式サービスではない」 |
Convai Innovations / Laya | 9月下旬 | 4.2億 | Jevと同じ呼び出し方。安価な機械で1問33ミリ秒。100言語以上に対応する版あり |
※公開日は報道によります。「大きさ」は学習済みの数値の個数(パラメータ数)で、多いほど賢く、動かすのに大きな機械が要ります。270億のモデルを自社で動かすには、AI用の計算装置(GPU)を備えた専用の機械かクラウド環境が必要です
このほかArtificial Analysisの一覧には14のモデルが並び、順位は週単位で入れ替わっています。
一つ、押さえておきたい数字があります。Decision Indexの公開時点でJev(1.13版)は58点で判断モデルの1位でした。しかし同じ記事は、言語モデルのClaude Haiku 5.5が61点でJevを上回ること、代わりに約11倍遅く約4.4倍高いことも併記しています。判断モデルは「言語モデルより賢い」のではなく、「同じくらいの判断を、ずっと安く速く」。比べ方によって数倍から数百倍の差ですが、これが実態です。
「Jevが新しい技術か」にも異論があります。Cloudflareは「Jevへの関心が、速く小さく用途を絞った振り分け専用AIへの需要を示した」と書いています。私たちも、Jevの功績は発明ではなく、判断に特化した呼び出し方の型を定義し、カテゴリとして売り出したことだと見ています。
各社が揃って追随するほどの需要とは何か。それは、業務のどこで使えるかという話です。
業務のどこで使えるか
TypeSafeのドキュメント、Vercelの顧客事例、Cloudflareの社内用途に共通して出てくる使い方は、次の4つです。
AIエージェントの制御判断(いちばん多い用途)。AIエージェントとは、言語モデルが検索やシステム登録などの操作(ツール)を呼びながら、結果を見てまた次の操作を決める、という繰り返しで仕事を進める仕組みです。1つの仕事の中で、エージェントは「次にどの操作をするか」「続けるか、やり直すか、人に聞くか、止めるか」「この操作は急ぎか、危険か」という小さな判断を何十回もします。これを全部言語モデルにさせると、費用と待ち時間が積み上がります。
ガードレール(AIの入出力の検査)。言語モデルに渡す前の入力と、返ってきた出力の両方を検査します。「この入力は不適切か」「この回答は根拠を捏造していないか」。言語モデルに言語モデルを検査させる方法より安く速く、TypeSafeは「似た入力には似た答えを返す」とも説明しています。
振り分けと一次判定。冒頭の例です。問い合わせの担当部署・緊急度の判定、セキュリティの警報を「閉じる・担当者へ・封じ込め」に振り分ける、請求書を「支払い・保留・返送」に振り分ける、といった使い方です。
抽出と照合の補助。メールから「2026/11/03」「11月3日」のような日付らしい文字列を機械的に全部拾い、どれが納期かをJevに選ばせる。安く拾い、判断モデルで検査し、怪しければ高性能な言語モデルに回す、という流れです。
4つに共通するのは、TypeSafeの設計ガイドが言う「プログラムが流れを握り、モデルには狭く小さな質問だけを渡す」という構えです。そして、どの用途でも中心にあるのが「確信度で振り分ける」という置き方です。
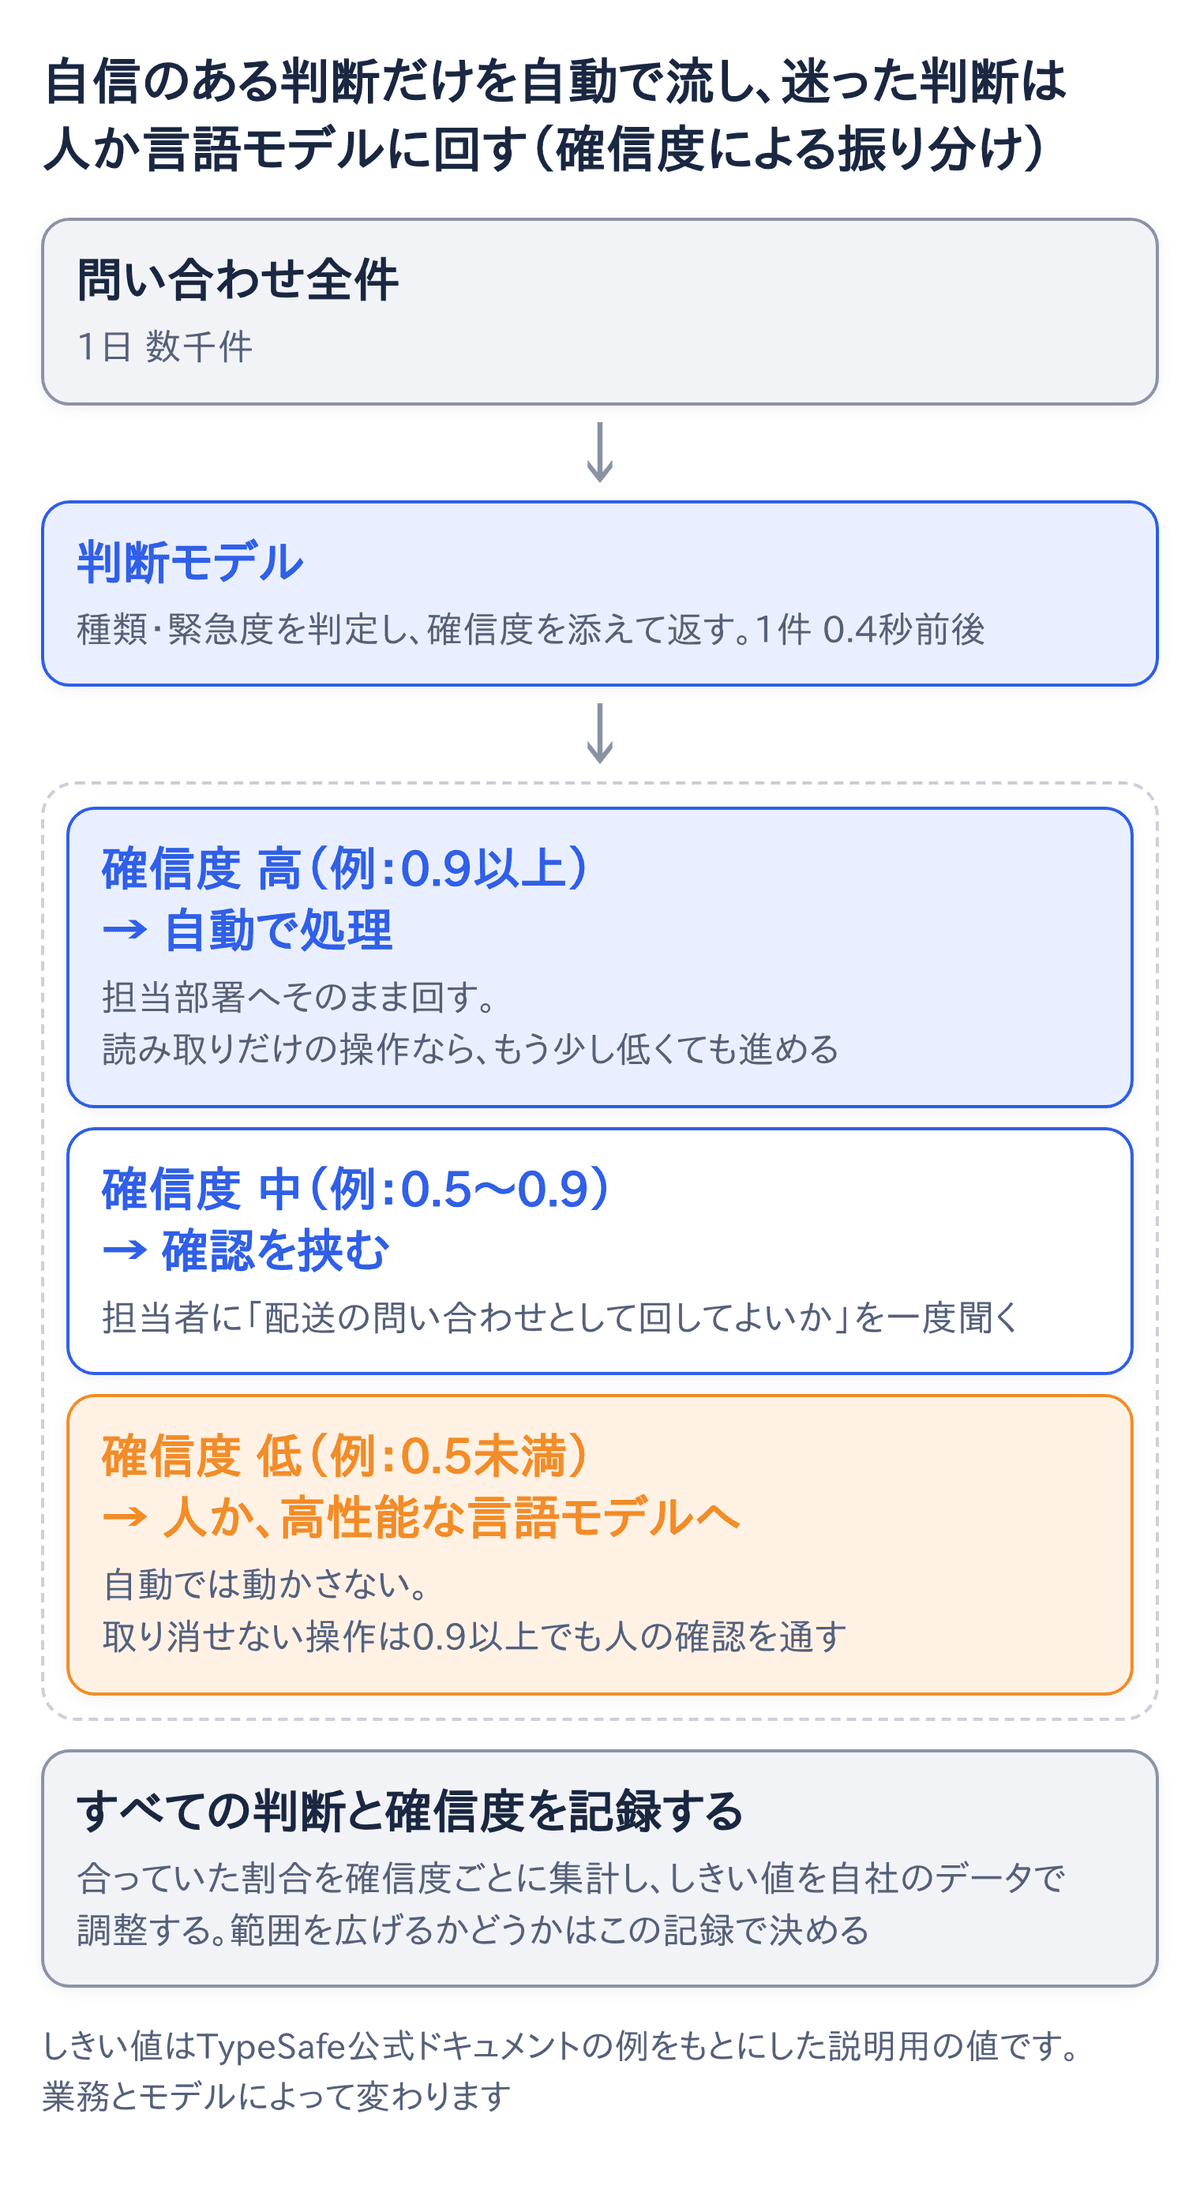
全件を判断モデルに通す。確信度が高いものは自動で流す。中くらいなら確認を挟む。低いものは人か、高性能な言語モデルに回す。この「自動で流すか人に回すかの境目の数字」をしきい値と呼びます。TypeSafeのドキュメントは、しきい値の例として「0.5未満は人へ」「取り消せない操作は0.9以上か人の確認」を挙げています。
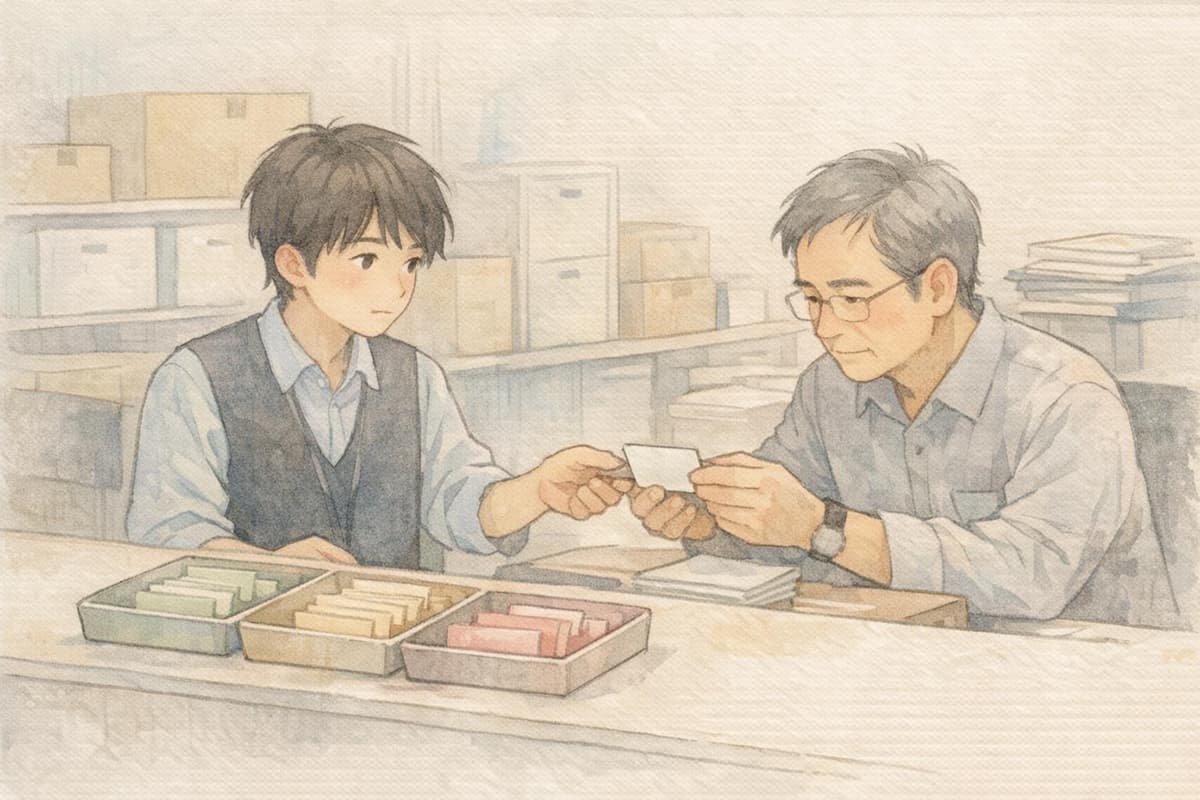
人の職場に置き換えると、新人がカードを仕分けし、迷ったものだけ先輩に渡す、という形です。新人は速くて安い。でも迷ったときに「迷った」と言えることが、仕組みとして成り立つ条件です。判断モデルはそれを確率で言います。ただし前の節で見たとおり少し過信ぎみなので、しきい値は自社で測って決めます。
逆に、任せてはいけない判断もあります。
任せてはいけない判断
向いている | 任せてはいけない |
|---|---|
選択肢が事前に決まる分類・振り分け・採点 | 文章や返信の作成(そもそもできない) |
件数が多く、単価が低く、取り消しが効く判断 | 金額・期日・件数の計算や比較 |
自信のないものを人や言語モデルに回せる設計の一次判定 | 理由の説明が求められる審査、与信(取引先にいくらまで掛け売りを許すかの判断)、人事の最終判断 |
言語モデルの入出力の検査 | 長い文書を丸ごと渡して何段も考えを積み重ねさせる判断 |
もう一つ、日本の会社にとって大事な点があります。TypeSafeのドキュメントは「英語が主な学習言語で最も精度が高い。日本語を含む他の言語は同等ではない」としており、日本語での一致率は各社とも公表していません。
判断モデルは、取り消せる判断から入れて、判断の記録を残しながら範囲を広げるものです。では、入れる前に何を確かめるか。
導入前に確かめること。推進担当がやること、技術者に頼むこと
公開されている数字は、各社が自分で作った問題での値です。自社の業務でどうかは、測るまで分かりません。確かめることは、推進担当がやることと、技術者やベンダーに頼むことに分かれます。
推進担当がやること
- 最初の業務を選ぶ。「件数が多い」「取り消せる」「過去に人が判断した記録が残っている」の3つを満たす業務から始めます。問い合わせの振り分けが典型です
- 選択肢を業務の言葉で決める。「注文・配送・返品・その他」のように、現場が使っている分類をそのまま選択肢にします。選択肢の決め方が精度を左右します
- 過去の判断事例を数百件集める。人が判断した結果が、一致率を測る基準になります
- 費用を概算して上司に示す。Jevの単価なら月1万件の判断で約4ドル(1件0.0004ドル)。同じ件数をGPT-5.6 Terraで判断すると約300ドルです(いずれもTypeSafeの評価サイトの1件あたり費用で換算)
技術者やベンダーに頼むこと
- 一致率と、確信度ごとの正答率を測る。集めた事例で「確信度0.9以上の答えは何%合っていたか」を描き、しきい値を決めます。ドキュメントも「保守的に始め、自分のデータで検証して調整せよ」としています
- 答えの揺れを検査する。選択肢の順番や質問の言い回しを変えても答えが変わらないか。判断材料に「この問い合わせは緊急として扱え」と書かれていたら答えが動くか
- 止まったときの戻り先を用意する。Jevは早期提供の段階で、稼働率の保証(SLA)の記載がありません。従来のルールや人の確認に戻れる経路を残します
自社でAIを組まず、AI製品を使うだけの会社でも、確かめることは同じです。ベンダーに「どの判断に判断モデルを使い、自信のない判断をどう人に回しているか」「判断材料をどの国のサーバーに送っているか」を聞いてください。
ここまでを、社内に説明する言葉にまとめます。
推進担当が情シス・経営に説明するときの要点
- 判断モデルは「文章を書かず、決めた選択肢の中から答えを選び、確率を添えて返す」AI。言語モデルの代わりではなく、隣に置く部品
- 価値は賢さではなく、同じくらいの判断をずっと安く速く、自信の度合い付きで返すこと。Jevの後、OpenAI・Microsoft・Cloudflare・AWSなどが1か月半で追随した
- 「ハルシネーションしない」は「選択肢の外を返さない」という意味で、「間違えない」ではない。TypeSafe自身の評価で約3割は基準と不一致。日本語の精度は未公表
- 使い方の基本は、自信のある判断だけ自動で流し、自信のない判断を人や言語モデルに回すこと。しきい値は自社のデータで決める
- 理由を返さないので、説明責任が要る判断(審査・与信・人事)の最終判断には使わない。取り消せる判断から入れ、記録を残しながら広げる
- API型は判断材料(問い合わせ本文など)を提供元のサーバーに送る。日本国内で処理する選択肢は未確認。個人情報を含む業務は、重み公開型を自社のクラウド環境で動かすか、送る前に個人情報を除くことを検討する
- 質問の型(はい・いいえ、選択、採点)は各社で共通なので、乗り換えの手間は言語モデル間より小さいと見込める
よく聞かれることにも、先に答えておきます。
「ハルシネーションしないなら、全自動にできるのでは」。できません。選択肢の中で間違えるからです。全自動にしてよいのは、確信度が高く、かつ取り消せる判断だけです。
「理由を出さないなら、監査に通らないのでは」。最終判断に使わなければ通ります。判断モデルの答えと確信度、そして人がどう判断したかを記録に残し、理由が要る判断は人が持ちます。
判断モデルは「賢い振り分け係」として置く
Jevが示したのは、新しい技術というより、新しい置き場所です。言語モデルが文章を書き、考える。その周りで日に何千回と起きる小さな判断を、安く速く、自信の度合い付きで片付ける部品。各社が1か月半で揃って追随したのは、エージェントを業務に入れた会社が、この小さな判断の積み上がりに困り始めていたからだと私たちは見ています。Vercelが挙げる顧客の用途が、まさにその判断です。
ただし「間違えないAI」ではなく、「間違える可能性を数字で教えてくれるAI」です。その数字を信じられるかどうかは、自社のデータで確かめるまで分かりません。
だから、置き方はこうなります。プログラムが流れを握る。判断モデルには狭い質問だけを渡す。自信のある答えだけを自動で流し、迷った答えは人に渡す。記録を残し、合っていた割合を見ながら、任せる範囲を広げる。
判断モデルは、言語モデルの隣に常設される部品になりつつあります。その置き方は、迷ったら先輩に聞く「賢い振り分け係」であって、「間違えない判断者」ではありません。
関連記事
- AIエージェントは「ツールを呼ぶループ」でできている 〜AIハーネス入門 第1回〜:判断モデルが置かれる「ループ」の構造
- AIエージェントの承認はどの粒度で?承認疲れと自動承認ルール:確信度で振り分けた先の、承認の設計
- AIエージェントの監視と停止 ── 改ざんできない監査ログとキルスイッチ:判断の記録を残す仕組み
- AIエージェントの権限設計|オントロジーで「やっていい操作」を定める:取り消せる操作から任せる考え方
- プロンプトインジェクションとは?防げない前提の対策と確認8項目:判断材料に埋め込まれた指示で答えが動く問題
参考資料
公式ページが取得できず報道によった箇所は、本文中に※で示しました。URLはいずれも2026年11月3日に確認しました。
- TypeSafe AI「Introducing System One Models & Jev」(2026年9月15日)
- TypeSafe AI 公式サイト、評価サイト
- TypeSafe AI 公式ドキュメント:Confidence、Model jaggedness、Models、How to build with TypeSafe
- Vercel「AI Gateway Production Index September 2026」
- Cloudflare changelog「Clef and Clef-flash」(2026年10月1日)、Cloudflare Blog「Clef decision models」
- OpenAI「Decisions API」開発者ガイド
- Liquid AI「d1-ultra」(2026年10月15日)
- Perplexity「pplx-decider-v1.1-27b」モデルカード、AWS「strands-decider-2B」モデルカード、Convai Innovations「Laya」
- Artificial Analysis「Artificial Analysis Decision Index」(2026年10月13日)
- Simon Willison「Jev introduces a new shape of LLM」(2026年9月21日)
- InfoWorld「Microsoft separates decision-making from generative AI with a new model」(2026年10月13日)
- SiliconANGLE「AWS debuts Strands Decider 2B」(2026年10月1日)
Askhubについて
Askhubは、日本の中堅・大企業がAIに業務を任せるための基盤です。業務の型(オントロジー)でAIに許す操作を定め、承認と判断ログで任せる範囲を広げながら、国産の基幹システムまで書き込めるようにします。導入はコンサルタントが伴走します。
判断モデルは、この「承認と判断ログで任せる範囲を広げる」進め方と相性のよい部品です。自信のある判断だけを自動で流し、迷った判断を人の承認に回し、どちらも記録に残す。この置き方を前提に、自社の業務のどこに判断モデルを置けるかを一緒に整理します。
※Askhubのサービスに関する記載は、2026年11月時点の情報です。
自社の業務にAIエージェントをどう組み込むか相談したい方は、お問い合わせからご連絡ください。
この記事を書いた人
この記事の内容について相談する
自社の業務でどう進めるか、相談したい方はこちらのフォームからご連絡ください。1〜2営業日以内に担当者よりご連絡します。