同じモデルなのに、製品によって違うのはなぜか
同じAIモデルを使っているはずなのに、製品によって、任せられる仕事の範囲も答えの質も違う。AIエージェント製品をいくつか試した方なら、この違和感に覚えがあると思います。
違いはどこから来るのか。それが分からないと、製品を選ぶことも、自社で何を用意すべきかを決めることもできません。
このシリーズ(全4回)では、AIエージェントの仕組みを、モデルそのものではなく、モデルの周りにある部分に注目して説明します。その部分を「ハーネス」と呼びます。言葉の意味は、この記事の後半で説明します。
この記事は、AIハーネス入門シリーズ(全4回)の第1回です。シリーズの一覧はこちら。
第1回は土台です。AIとは何をするものか、から始めて、AIエージェントがどういう構造でできているかまでを追います。
先に結論を言うと、構造は驚くほど単純です。そして単純だからこそ、技術者でなくても、製品の差を「AIにどの情報を渡し、どの操作を許しているか」という業務の言葉で読み解けます。
機械学習は、例から「入力と出力の対応」を学ぶ
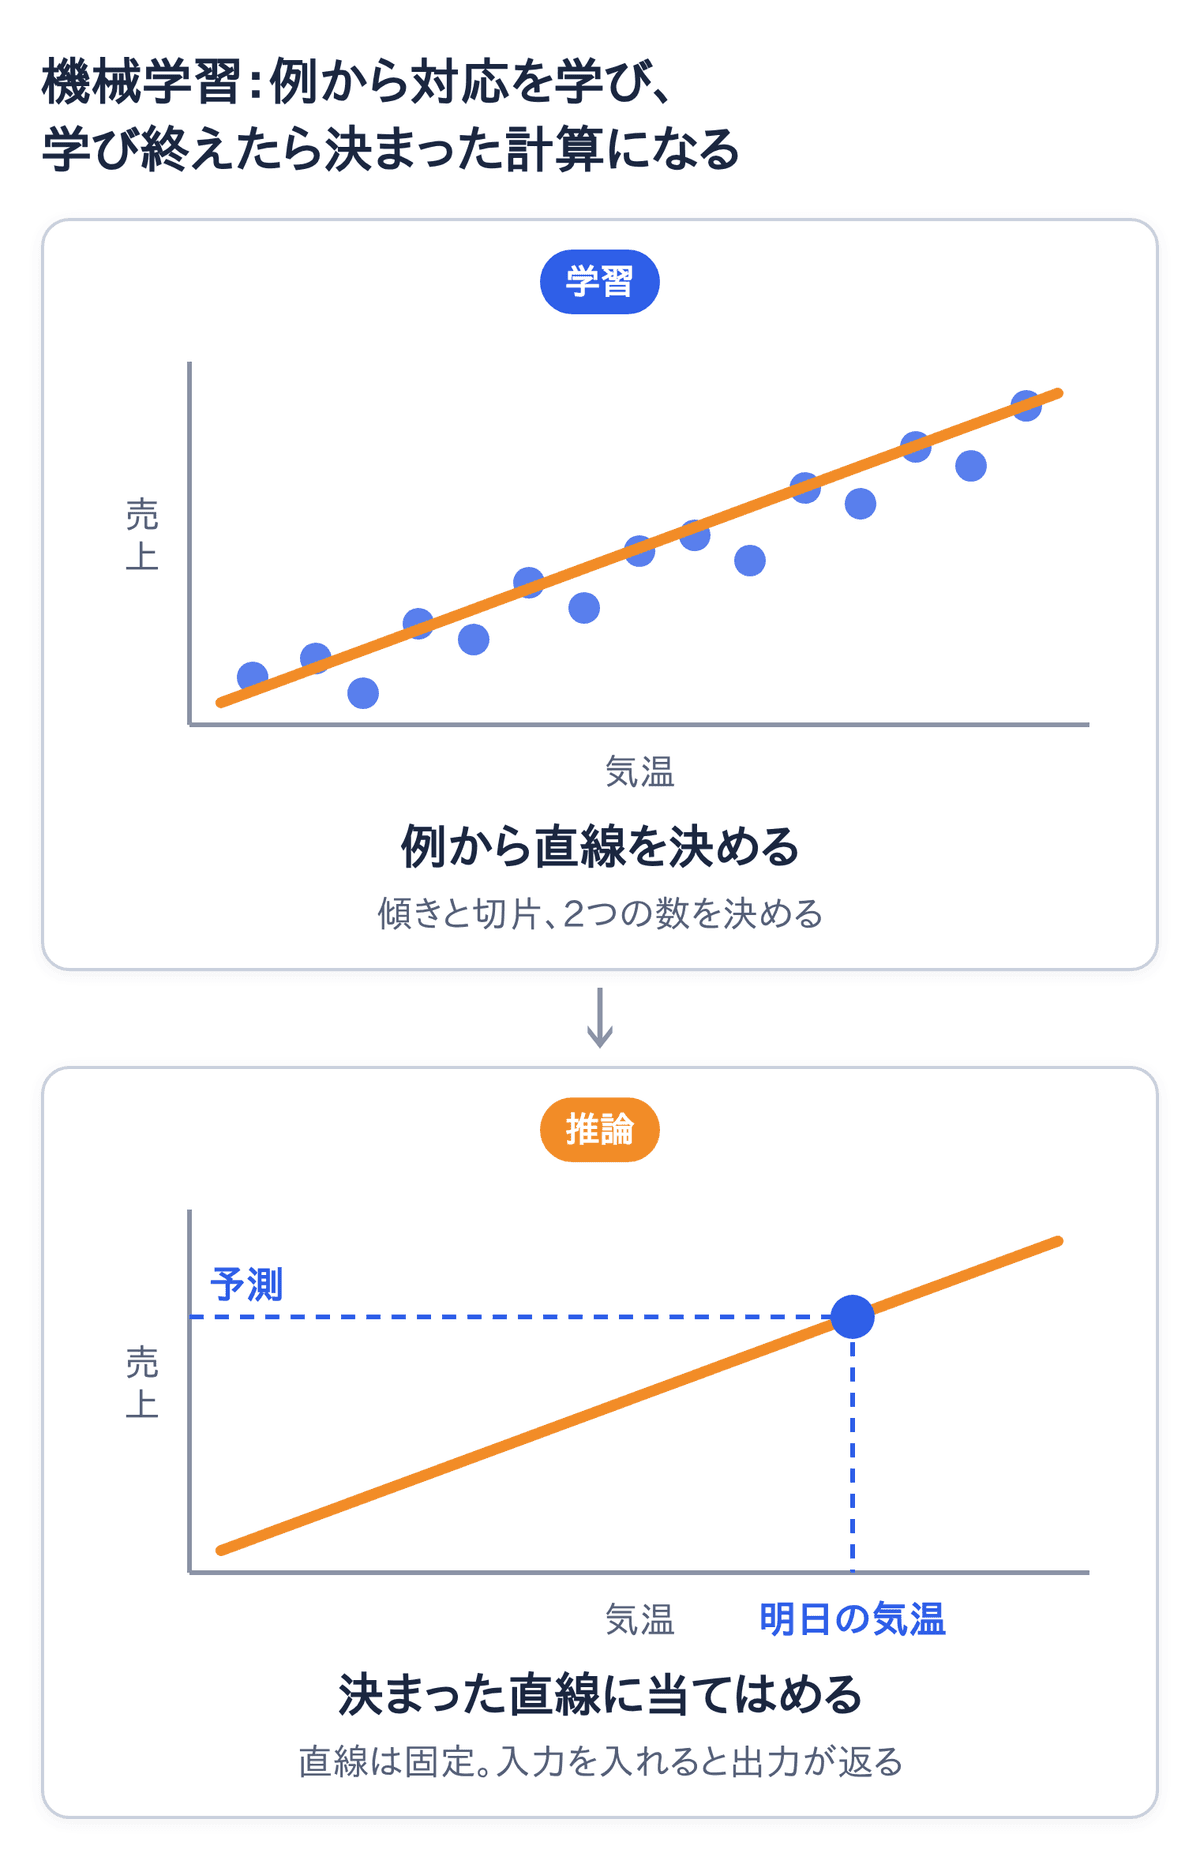
AIと呼ばれるものの多くは、機械学習という方法で作られています。やっていることは一言で言えば、「入力と出力の対応を、例から学ぶ」ことです。
過去1年分の「その日の気温」と「アイスの売上」の記録があるとします。この関係を1本の直線で表すなら、決めるべき数は2つだけです。直線の傾きと、直線がどの高さから始まるか(切片)です。たくさんの記録に一番よく合う2つの数を、コンピュータが探す。これが「学習」です。
学習が終わると、2つの数は固定されます。あとは明日の予想気温を入れれば、売上の予測が出てきます。この「使う場面」を、専門用語で「推論」と呼びます。
覚えておいてほしいのは、1点だけです。
AIが賢くなるのは、学習のときです。使うときのAIは、入力を受け取って出力を返す、決まった計算です。使っている最中に、勝手に賢くなることも、何かを覚えることもありません。
では、文章を書くAIは、何を入力して何を出力しているのでしょうか。
言語モデルは、入力も出力も文字列
ChatGPTやClaudeの中身は「大規模言語モデル」と呼ばれます。以下では短く「モデル」と呼びます。
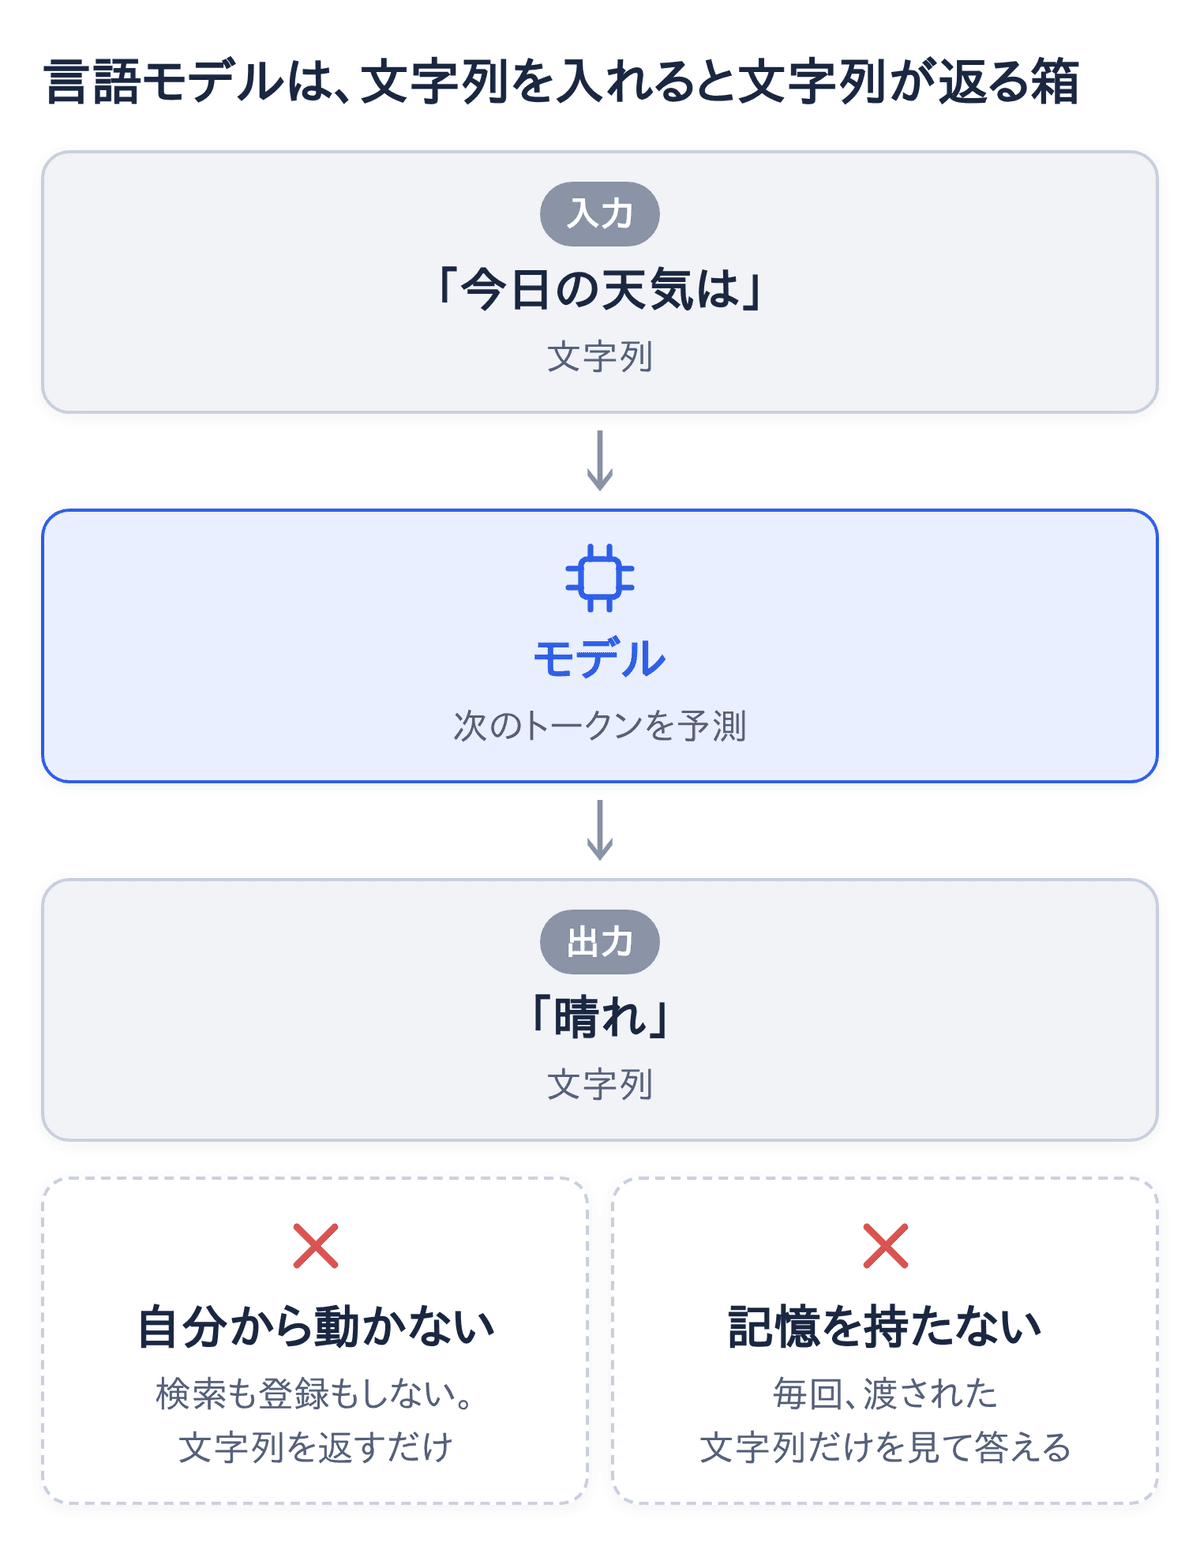
モデルの入力は文字列で、出力も文字列です。
モデルは文字列を「トークン」という小さな単位に切って扱います。日本語なら1〜2文字、英語なら単語の一部くらいの長さです。モデルがしているのは、「ここまでのトークンの並びに続く、次のトークンは何か」を予測することの繰り返しです。「今日の天気は」まで来たら、次は「晴れ」か「雨」か。どちらが続きやすいかを、膨大な文章から学んでいます。
最近は画像も受け取れるモデルが増えました。その話は第3回で扱います。ここでは基本の形だけ押さえてください。文字列を入れると、文字列が返る。
この形から、大事なことが2つ言えます。
1つ目。モデルは、自分から何かをしに行きません。検索も、ファイルの保存も、システムへの登録も、モデル単体ではできません。文字列を返すだけです。
2つ目。モデルは、記憶を持ちません。前回の会話を覚えているように見えるのは、モデルを呼び出しているプログラムが、前回までの会話を毎回まとめて入力に含め直しているからです。モデル自身は、毎回、そのとき渡された文字列だけを見て答えています。
この「そのとき渡された文字列」に、名前を付けておきます。
渡す文字列のまとまりを「コンテキスト」と呼ぶ
モデルに1回の推論で入力する情報の全体を、「コンテキスト」と呼びます。指示の文章も、使えるツールの説明も、これまでのやり取りも、検索して取り出した文書も、入力されるものは全部コンテキストです。特定の何かを指す言葉ではなく、入力の総称です。
たとえ話で言うと、コンテキストは「AIに渡された書類」です。
AIは、渡された書類しか見えません。書庫に何が眠っていても、渡されていなければ存在しないのと同じです。逆に、書類に加えれば、どんな情報でもAIの判断材料になります。モデルには学習で身につけた一般的な言葉の知識がありますが、自社の注文や規程のような個別の情報は持っていません。仕事の材料になる個別の情報は、渡された書類だけです。
渡された書類は、ばらばらに渡されるのではなく、1つにつながった文字列として渡されます。その中で、どの情報が先に、どの情報が後に並ぶかには意味があります。この並び順の意味は、第2回で説明します。
そして、何を書類に入れて渡すかを決めるのは、モデル自身ではありません。周りの仕組みです。
このシリーズを通じて一番大事な言葉が、このコンテキストです。第2回でこの書類の中身を細かく見て、第4回では「書類に何を入れるかを決める仕事を、社内の誰が担うべきか」を考えます。
その前に、文字列しか返せないモデルが、どうやってシステムを操作しているのかを見ます。
ツール呼び出しとは、モデルが「決まった形式」で使いたいツールを書き出すこと
AIエージェントは、社内システムを検索したり、記録を更新したりします。文字列しか出せないモデルが、どうやってそれをしているのでしょうか。
答えは、「モデル自身は操作していない」です。
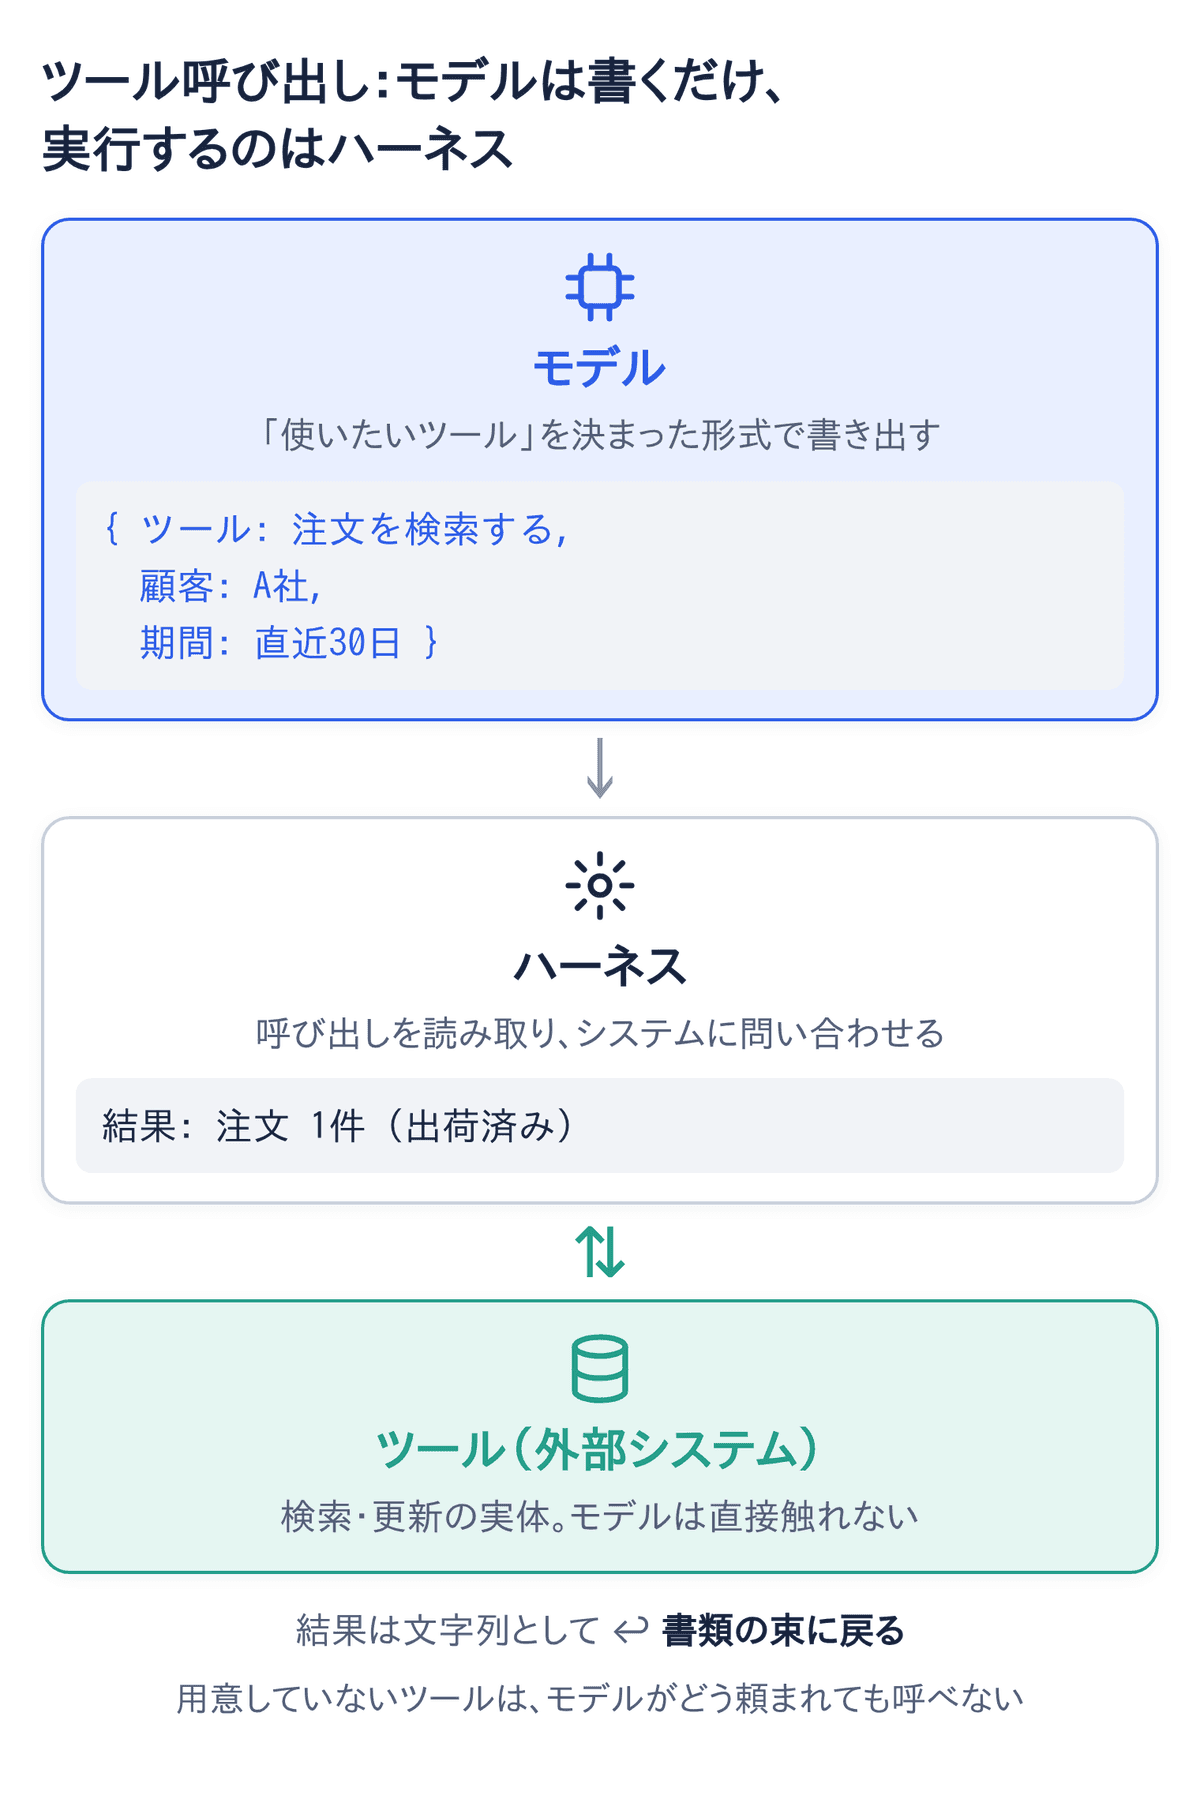
モデルがしているのは、「このツールを、この条件で使いたい」と、決まった形式の文字列で書き出すことだけです。たとえばこんな形です。
{ "ツール": "注文を検索する", "顧客": "A社", "期間": "直近30日" }波括弧や引用符は、プログラムが機械的に読み取るための決まった書き方です(JSONと呼ばれます)。意味は「ツール=注文の検索、顧客=A社、期間=直近30日」。これだけです。
この文字列を受け取った周りのプログラムが、実際に検索を実行し、結果を文字列にしてモデルに返します。
これを「ツール呼び出し」と呼びます(英語ではツールコール、ファンクションコーリングとも言います)。モデルは、この決まった形式をきちんと守って書けるように、追加の学習を受けています。形式が守られるから、プログラムが読み取れる。それだけのことで、文字列しか返せないモデルがシステムとつながりました。
ここから、重要な帰結が2つ出てきます。
1つ目。モデルは、周りのプログラムが用意したツールしか使えません。「こういうツールが使える」という一覧(ツール定義)に載っていない操作は、どんなに頼まれても書き出しようがありません。業務オントロジー入門の第5回で「AIに渡すのは3種類の道具(ツール)だけ」と書きましたが、それが成り立つ理由はここにあります。
2つ目。ツールの実行結果は、文字列として次の入力(コンテキスト)に追加されます。つまりツールは、操作をするだけでなく、AIに新しい情報を渡す手段でもあります。
では、ツール呼び出しを1回で終わらせず、繰り返したらどうなるでしょうか。
結果を次の入力に戻すと、ループになる
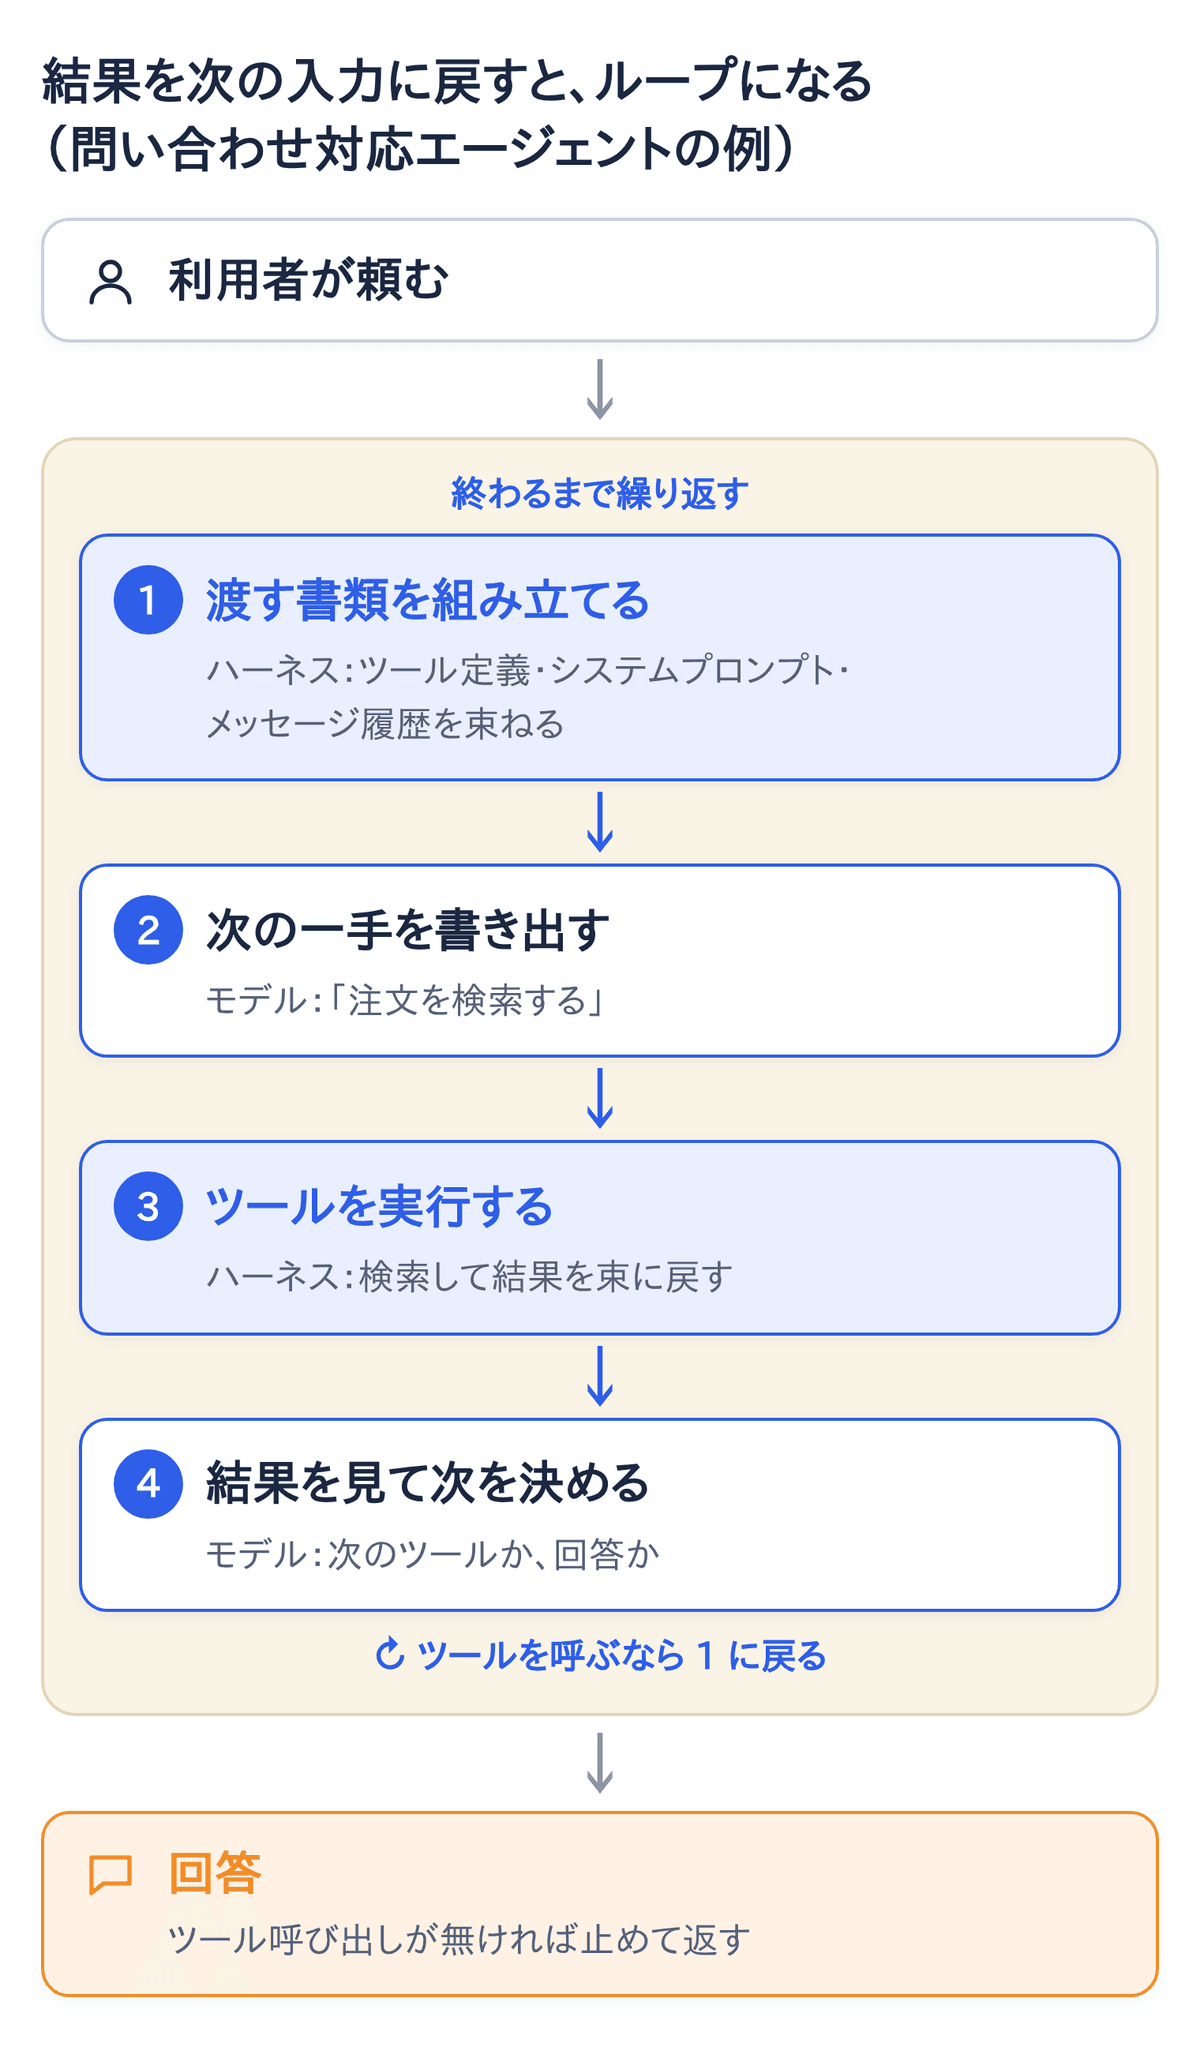
モデルがツールを1回使って終わり、ではなく、実行結果を見てから次に何をするかをモデル自身が決める。それを仕事が終わるまで繰り返す。
この繰り返しの仕組み全体が、AIエージェントです。
このシリーズでは、「問い合わせ対応エージェント」を通し例にします。顧客からの「注文した商品はいつ届きますか」という問い合わせに、注文と配送の状況を調べて答える、という仕事です。流れはこうなります。
- 担当者が「A社から『注文した商品はいつ届きますか』と問い合わせが来た。答えて」と頼む
- モデルが「注文を検索する」というツール呼び出しを書き出す
- 周りのプログラムが検索を実行し、結果(A社の注文1件、出荷済み)を書類の束に追加する
- モデルが結果を見て、「配送状況を確認する」という次のツール呼び出しを書き出す
- 結果(明日の午前に到着予定)が戻る。モデルが「これで答えられる」と判断し、回答の文章を書く
- 周りのプログラムが、モデルの出力にツール呼び出しが含まれていないことを確認し、ループを止めて回答を担当者に返す
Anthropicは2024年12月の記事で、エージェントを「ツールの実行結果を見ながら、ループの中でツールを使い続ける言語モデル」と説明しています。そして、次に何をするかを人が先にプログラムで決めてあるものを「ワークフロー」、その場でモデルが決めるものを「エージェント」と呼び分けています。ここでの「ワークフロー」は社内の承認ワークフローとは別の用語で、「手順を人が先に固定したもの」という意味です。
違いは、次の一手を決めるのが人か、モデルかです。モデルが決めるから「自律型」と呼ばれます。
ループには、止める条件が必要です。たとえば、モデルが「仕事は終わった」と判断したとき、繰り返しの回数が上限に達したとき、使った費用が上限に達したとき、などです。この止める条件を決めているのも、モデルではなく周りのプログラムです。
ここまでで、「周りのプログラム」が何度も出てきました。渡す書類を組み立て、ツールを実行し、結果を戻し、止めどきを決める。この部分に名前を付けます。
モデル以外の全部を「ハーネス」と呼ぶ
エージェントは、モデルと、その周りのプログラムでできています。周りの部分を「ハーネス」と呼びます。
ハーネスは、もともと馬具のことです。馬そのものの力は変えられませんが、馬具の出来で、馬を仕事に使えるかどうかが決まります。AIでも同じで、モデルの賢さを実際の業務で使える形にするのがハーネスです。
ハーネスという言葉がエージェントの話で使われ出したのは、2026年に入ってからです。同じ年の7月には、プログラミング支援のエージェント製品11本の中身(プログラムそのもの)を調べた論文が公開されました。このシリーズでは、説明に抜け漏れが出ないよう、この論文が示したハーネスの分類をそのまま使います。論文が調べたのはプログラミング用の製品なので、業務用の製品にもそのまま当てはまるかは、話題ごとに確かめながら進めます。ただし、ハーネスの基本の部品構成はどの用途でも同じです。
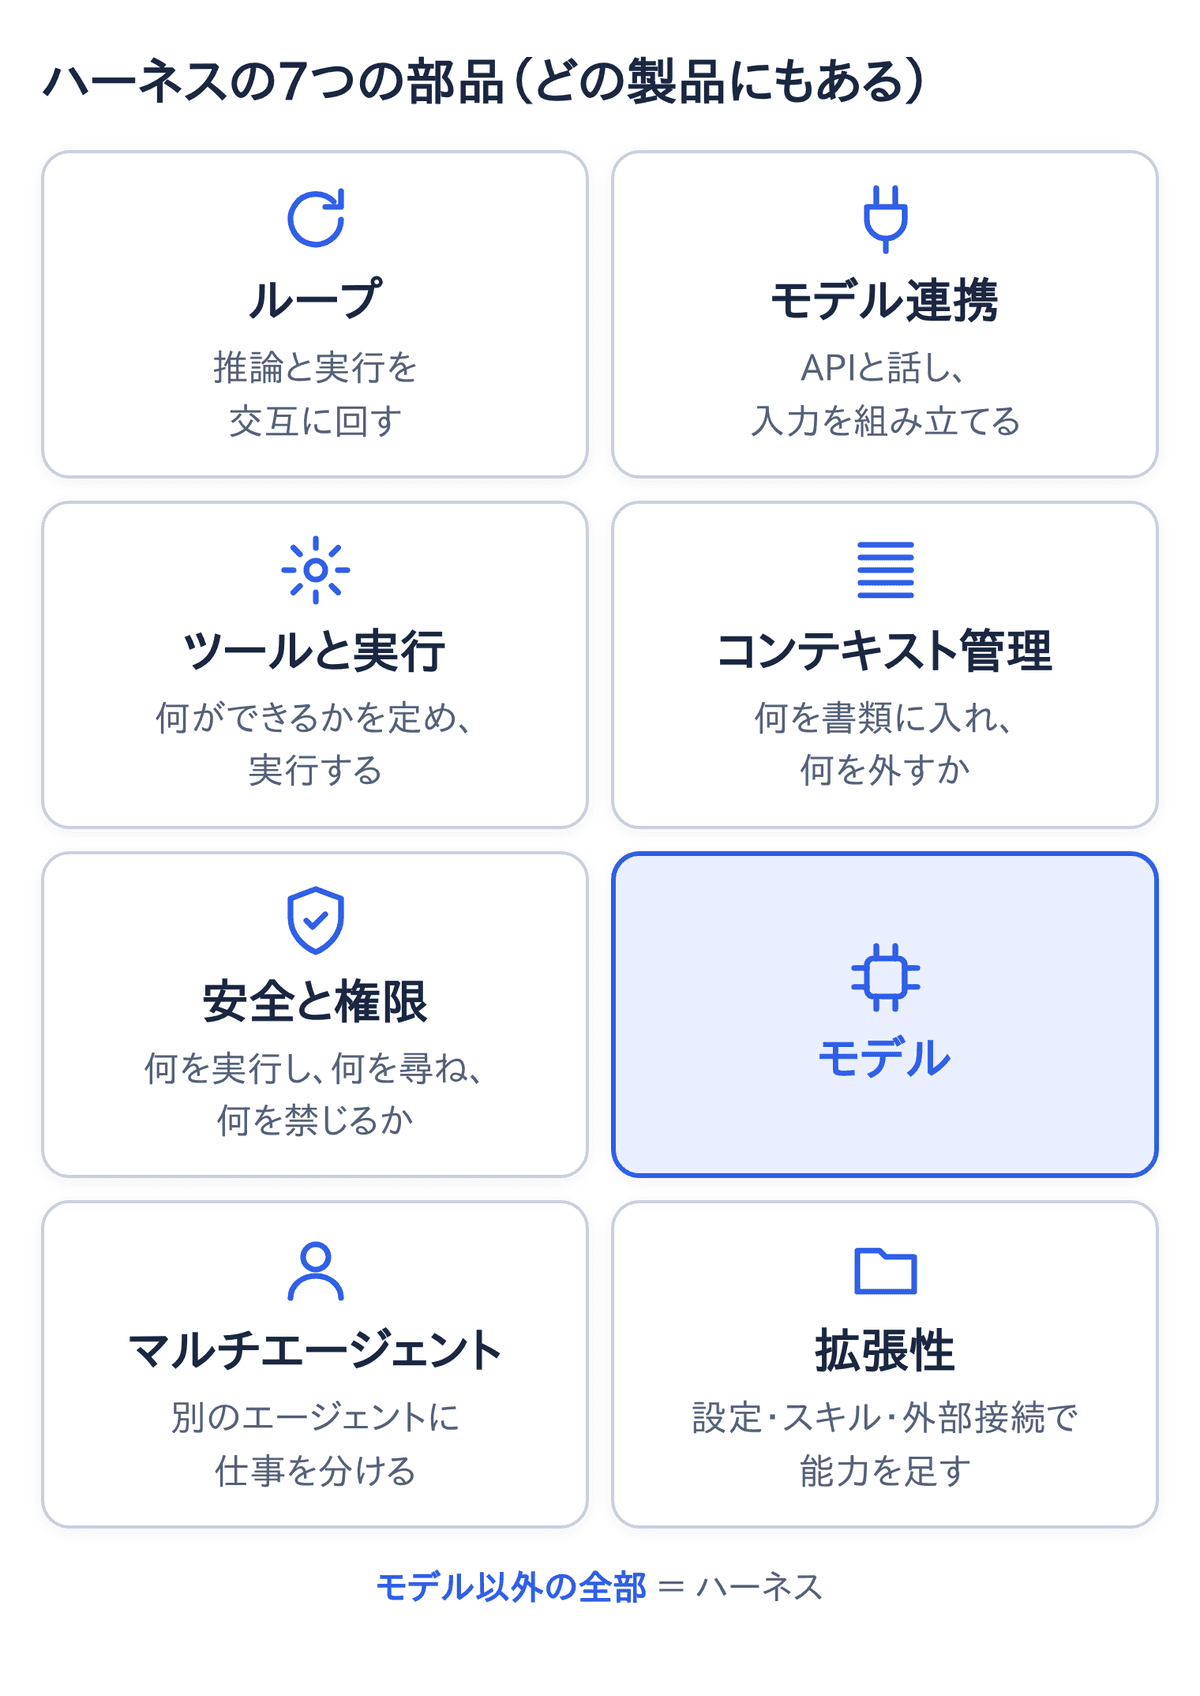
論文の定義は、一言で言えば「ハーネスは、モデル以外の全部」です。そして、どのハーネスも必ず7つの部品を持つと整理しています。
部品 | 何をするか |
|---|---|
ループ | モデルの呼び出しとツールの実行を交互に繰り返す。止める条件を持つ |
モデル連携 | 渡す書類の束を組み立て、モデルのAPI(プログラムからモデルを呼び出す接続口)に送って、出力を受け取る |
ツールと実行 | 何ができるかを定義し、実際に実行する |
コンテキスト管理 | 何を書類に入れ、何を外すかを決める。長くなったやり取りを要約して短くする処理や、過去のやり取りを保存して次回に渡す仕組みもここ |
安全と権限 | 何を実行し、何を人に尋ね、何を禁じるかを決める |
マルチエージェント | 別のエージェントを呼び出して仕事を分ける |
拡張性 | 設定・スキル(仕事のやり方の手順書)・外部接続で、あとから能力を足す |
論文が調べたClaude Code、Codex、Gemini CLIといったプログラミング支援の製品も、調査の対象外だった業務向けの製品も、モデルの周りにこの7部品を持つ点は同じです。製品ごとの違いは、7部品の作り方の違いです。
たとえば、ある製品は社内規程を参照して答えられ、別の製品は顧客への返信の送信までできる。この差は、モデルの賢さの差ではありません。前者は規程を書類に加える仕組みを持ち、後者は「返信を送る」ツールをモデルに渡している。それだけの差です。
では、この7部品を作るのは、どれほど大変なのでしょうか。
7つの部品は、A4で2〜3枚のプログラムで揃う
先ほどの論文に、興味深い発見があります。
調べた11製品のうち、最も小さいものは、7部品すべてをおよそ100行、紙にすればA4で2〜3枚のプログラムで実装していました。中身は、ループが1つ、ツールが1つ、コンテキスト管理はメッセージ履歴(やり取りの記録)を全部そのまま渡すだけ、安全と権限は回数と費用の上限だけ、という作りです。
それでも、プログラミングの課題を解く標準的なテストでは、プログラムの量が何十万行もある製品と同じくらいの成績を出しています。成績は各製品の自己申告で、条件が揃った比較ではありませんが、論文が強調しているのは、順位ではなく次の点です。
仕事をこなすだけなら、必要なプログラムはA4で2〜3枚に収まる。製品の残りの何十万行は、安全、使いやすさ、機能の追加、失敗からの立て直し、費用の管理に使われている。つまり製品のプログラムの大きさは、「安心して任せる」ための仕組みの大きさです。
論文はこの関係を、部品を足していったときに成績がどう変わるかを表す1本の曲線として描いています。部品がまったく無ければ動かない。ループとツールとメッセージ履歴という最低限の部品を足すと、成績は急に上がる。その先に部品を足しても、成績はほとんど変わらず、代わりに安全や使いやすさが良くなる。論文自身はこれを「まだ検証途中の見立て」と断っています。
もしこの見立てが正しければ、AIエージェントへの投資は、最低限の部品が揃った後は「賢くする」投資ではなく、「安心して任せる」投資になる、と読めます。そして「安心して任せる」ための中身、つまりAIにどの情報を渡し、どの操作を許し、何を記録に残すかは、技術ではなく業務の話です。
AIエージェントの構造そのものは、ここまでで全部です。文字列を返すモデルにツール呼び出しの形式を覚えさせ、結果を戻すループにする。それだけです。この先の3回は構造の話ではなく、その構造に何を入れるか、つまりAIに渡す情報、許す操作、投資すべき場所の話になります。
推進担当が押さえる要点
- 機械学習は、入力と出力の対応を例から学ぶ。学習が終わったAIは、入力を受け取って出力を返す決まった計算
- 言語モデルは、入力も出力も文字列。自分から動かず、記憶も持たない。毎回、渡された文字列(コンテキスト=渡された書類)だけを見て答える
- ツール呼び出しとは、モデルが「このツールをこう使いたい」と決まった形式で書き出すこと。実行するのは周りのプログラム。だから、用意されていないツールは使えない
- ツールの実行結果を次の入力に戻して繰り返すと、エージェントになる。次の一手をモデルが決めるから「自律型」
- モデル以外の全部を「ハーネス」と呼ぶ。7つの部品からなり、仕事をこなすだけの最小の実装はA4で2〜3枚に収まる。製品のプログラムの大きさは、安心して任せるための仕組みの大きさ
構造が単純だから、問うべきことがはっきりする
AIエージェントは、中身の分からない魔法の箱ではありません。文字列を返すモデルと、その周りで渡す書類を整え、ツールを実行し、止めどきを決めるハーネス。この2つだけでできています。
構造が単純だからこそ、問うべきことがはっきりします。AIに渡された書類には何が入っているのか。何をしてよいことになっているのか。そして、それを決めているのは誰か。
次回は、渡された書類の中身を細かく見ます。書類は3つの区分に分かれていて、そのうちの1つであるシステムプロンプト(AIへの基本の指示を書いた部分)には、さらに2つの層があります。渡せる量には上限があり、上限に余裕があっても、書類が増えるほどAIは見落としやすくなります。
シリーズの目次
- AIエージェントは「ツールを呼ぶループ」でできている 〜AIハーネス入門 第1回〜(この記事)
- AIが見ているのは「渡された書類」だけ 〜AIハーネス入門 第2回〜
- 何を任せられるかは「能力」と「安全」で決まる 〜AIハーネス入門 第3回〜
- ハーネスのどこに、会社は投資するか 〜AIハーネス入門 第4回〜
関連記事
- AIエージェントは型の上でどう動くか 〜業務オントロジー入門 第5回〜:AIに渡す3種類の道具(ツール)と、人と同じ関門を通る仕組み
- AIエージェントの権限設計|オントロジーで「やっていい操作」を定める:定義にない操作はそもそも実行できない、の設計
- AIエージェントのセキュリティ全体像:統制をモデルの外に置く考え方
参考資料
- Anthropic「Building effective agents」(2024年12月、https://www.anthropic.com/engineering/building-effective-agents (2026年11月2日確認))
- Paul Barbaste, Tristan Darrigol, Germain Vu, Tom Wiltberger, "Harness Engineering: Anatomy, Architecture, and Evolution of Coding Agents: A Source-Code Study of Eleven Systems," arXiv:2609.00006(2026年7月、https://arxiv.org/abs/2609.00006 (2026年11月2日確認))
Askhubについて
Askhubは、日本の中堅・大企業がAIに業務を任せるための基盤です。業務の型(オントロジー)でAIに許す操作を定め、承認と判断ログで任せる範囲を広げながら、国産の基幹システムまで書き込めるようにします。導入はコンサルタントが伴走します。
この記事の言葉で言えば、Askhubは「モデルに渡すツール定義」を業務の型から作るハーネスです。一覧にない操作は、AIがどんな指示を受けても呼び出せません。
※Askhubのサービスに関する記載は、2026年11月時点の情報です。
自社の業務にAIエージェントをどう導入するか相談したい方は、お問い合わせからご連絡ください。
この記事を書いた人
この記事の内容について相談する
自社の業務でどう進めるか、相談したい方はこちらのフォームからご連絡ください。1〜2営業日以内に担当者よりご連絡します。