判断モデルは「迷ったら人に回す」形で業務に置く
AIに業務の判断を任せるときは、確信度の高い判断だけを自動で流し、低い判断を人に回します。確信度は、答えにどれくらい自信があるかを表す数字です。全自動にしてよいのは、確信度が高く、取り消せる判断だけです。
判断だけを返すAI(判断モデル)は、この置き方に向いた部品です。向くのは、問い合わせの振り分けや請求書の一次判定のように、選択肢が決まった判断を大量にこなす仕事です。一方で判断の理由を返さないので、置き場所を間違えると、誰も説明できない判断が積み上がります。
2026年秋から各社が提供を始めました。AIの呼び出しを仲介するVercel社の集計では、1回の呼び出しにかかる費用は、文章を書くAI(言語モデル)の約70分の1です。安く速いぶん、任せる範囲を決めないまま広げやすい点に注意が要ります。
推進担当が押さえる要点
- 判断モデルに任せるのは、選択肢が決まった「判断」だけ。計算・日付の比較・規則の当てはめはプログラムが受け持ち、両方を組み合わせて最終的な処理を決める
- 置き方の基本は、確信度による振り分け。どの確信度から自動にするか(しきい値)は、「その範囲の誤り率×誤り1件の手戻り」と「人が1件見る手間」を比べて、自社のデータで決める
- 全自動にしてよいのは、確信度が高く取り消せる判断だけ。理由を返さないので、審査・与信(取引先にいくらまで掛け売りを許すかの判断)・人事の最終判断には使わない。EUのAI法は採用や個人の信用力の評価に使うAIを高リスクとし、国内のガイドラインも個人の評価には人の判断と説明を求めている
- 導入前に、人が付けた正解で数百件を測る。別のAIの答えを正解にしない。日本語の精度は、主要な提供元の公式資料には出ていない
- 動かした後は、自動で流した分の抜き取り確認と、人に回る割合を見続ける。モデルの版を固定し、版が変わったら測り直す
- 提供元のサーバーで動くものを呼び出す形(API型)は、判断材料を提供元に送る。処理する国、保存の有無、学習への利用を確かめ、個人情報は除くか、自社の環境で動かせるモデルを使う
判断モデルに渡すのは「判断」だけ。計算と規則はプログラムが持つ
判断モデルを業務に入れるときは、最初に仕事を「判断」と「計算・規則」に分けます。判断モデルの「Jev」を提供するTypeSafe AIも、同じ考えです。同社は2026年11月の記事で「Jevが返すのは見立てで、決定を下すのはプログラムだ」と書いています。
たとえば返金の依頼なら、「この客は返金を求めているか」は文章を読まないと分からない判断なので、判断モデルに聞きます。「支払い済みか」「対象の期間内か」は記録から計算できるので、プログラムで確かめます。
経費精算の規程なら、次の図のように分けられます。規程の文を一つずつ、判断モデルへの小さな質問か、プログラムの規則に置き換えます。
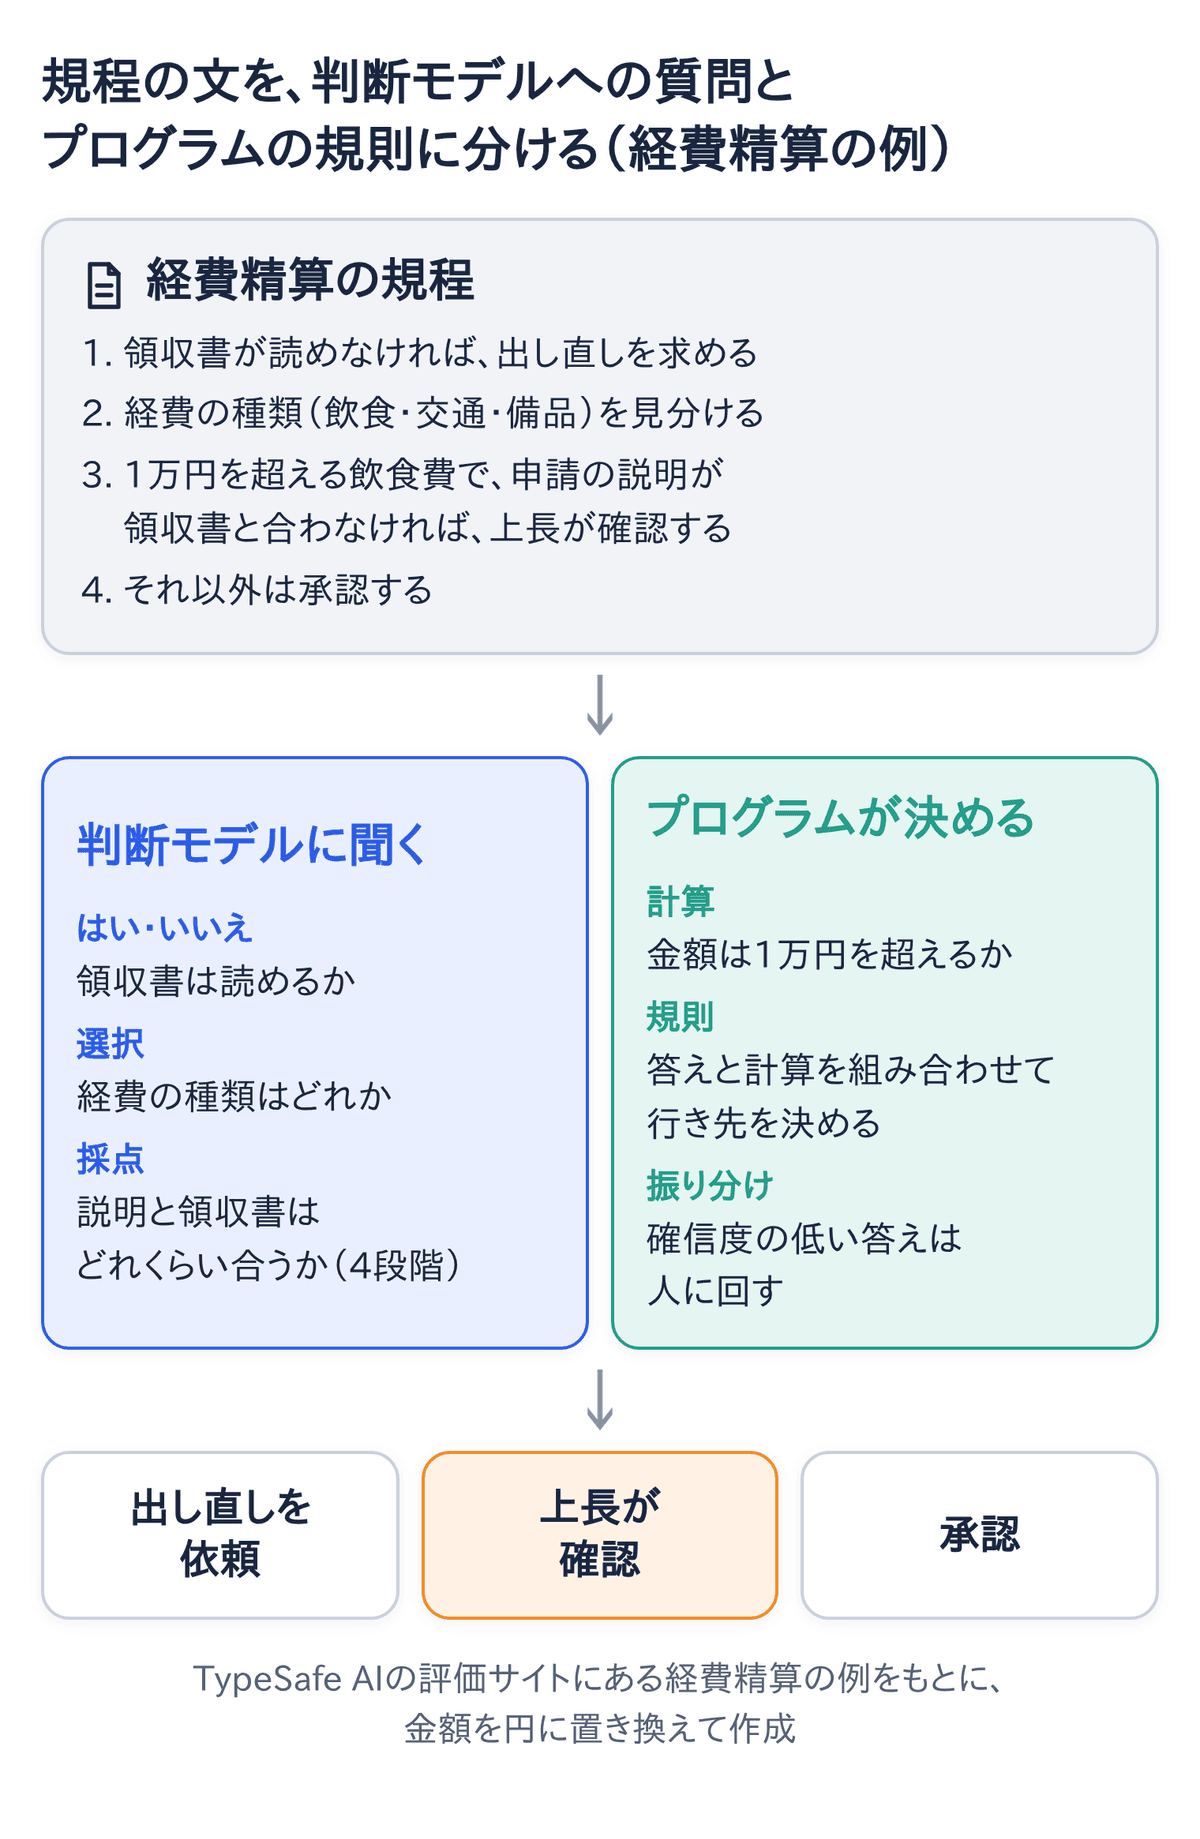
分けると精度も上がります。TypeSafeが公開している自社の評価は、規程を一つの指示として丸ごと渡す場合と、小さな質問に分けてプログラムで組み合わせる場合を比べています。その結果、分けた方が正確で安く速くなりました。
この評価では、4つの業務の平均で、試したすべてのモデルがそうなっています。たとえば言語モデルのGPT-6 Solは、基準の答えとの一致率が63.4%から74.1%に上がりました。Claude Haiku 4.5は18.1%から53.6%です。
判断モデルが自信を保ったまま誤りやすい場面も、分かっています。Jevのドキュメントが「既知の荒さ」として挙げる主なものと、代わりにすることは次のとおりです。同じ作りのほかの判断モデルにも、似た弱点があると考えておくのが安全です。
弱点 | 代わりにすること |
|---|---|
書かれた文を文字どおりに読む。否定や暗黙の条件も額面どおり | 条件をはっきり書き、境目の例を選択肢の説明に入れる |
計算や数え上げは当てにならない | 計算はプログラムで行う |
日付の前後や期間の判定は当てにならない | 年・月・日を選ばせ、比べるのはプログラム |
関係のない情報が多いと精度が落ちる | 質問に要る項目だけを渡す |
判断材料に紛れた「こう答えろ」という文に動かされる(プロンプトインジェクションと呼ばれる攻撃) | 攻撃の例を含む境目の事例で試してから広げる |
選択肢の先頭に寄る | 順番を入れ替えて、答えが変わらないか確かめる |
使える場面は4つ。どれも確信度で振り分けて使う
判断モデルの使い道は、TypeSafeのドキュメント、Microsoftの発表、Googleの発表が挙げる用途を並べると、ほぼ同じ4つに集まります。
使い道 | 判断モデルが受け持つこと |
|---|---|
AIエージェントの制御 | AIエージェント(AIが検索や登録などの操作を呼びながら、次の手を自分で決めて仕事を進める仕組み)が途中で下す「次にどの操作を使うか」「続けるか、人に聞くか、止めるか」という小さな判断を、言語モデルより安く速く下す |
AIの入出力の検査(ガードレールとも呼ばれる) | 言語モデルに渡す入力と、返ってきた出力が、不適切でないか、根拠を捏造していないかを確かめる |
振り分けと一次判定 | 問い合わせの担当部署や緊急度、セキュリティの警報の「閉じる・担当者へ・封じ込め」、請求書の「支払い・保留・返送」を見分ける |
抽出と照合の補助 | 日付や金額らしい文字列をプログラムで全部拾い、どれが納期かを判断モデルに選ばせる。怪しいものだけ高性能な言語モデルに回す |
4つに共通する点は2つあります。1つは、TypeSafeの設計ガイドが言う「プログラムが主導権を持ち、モデルには狭く構造化された判断だけを渡す」という構えです。もう1つは、確信度による振り分けです。
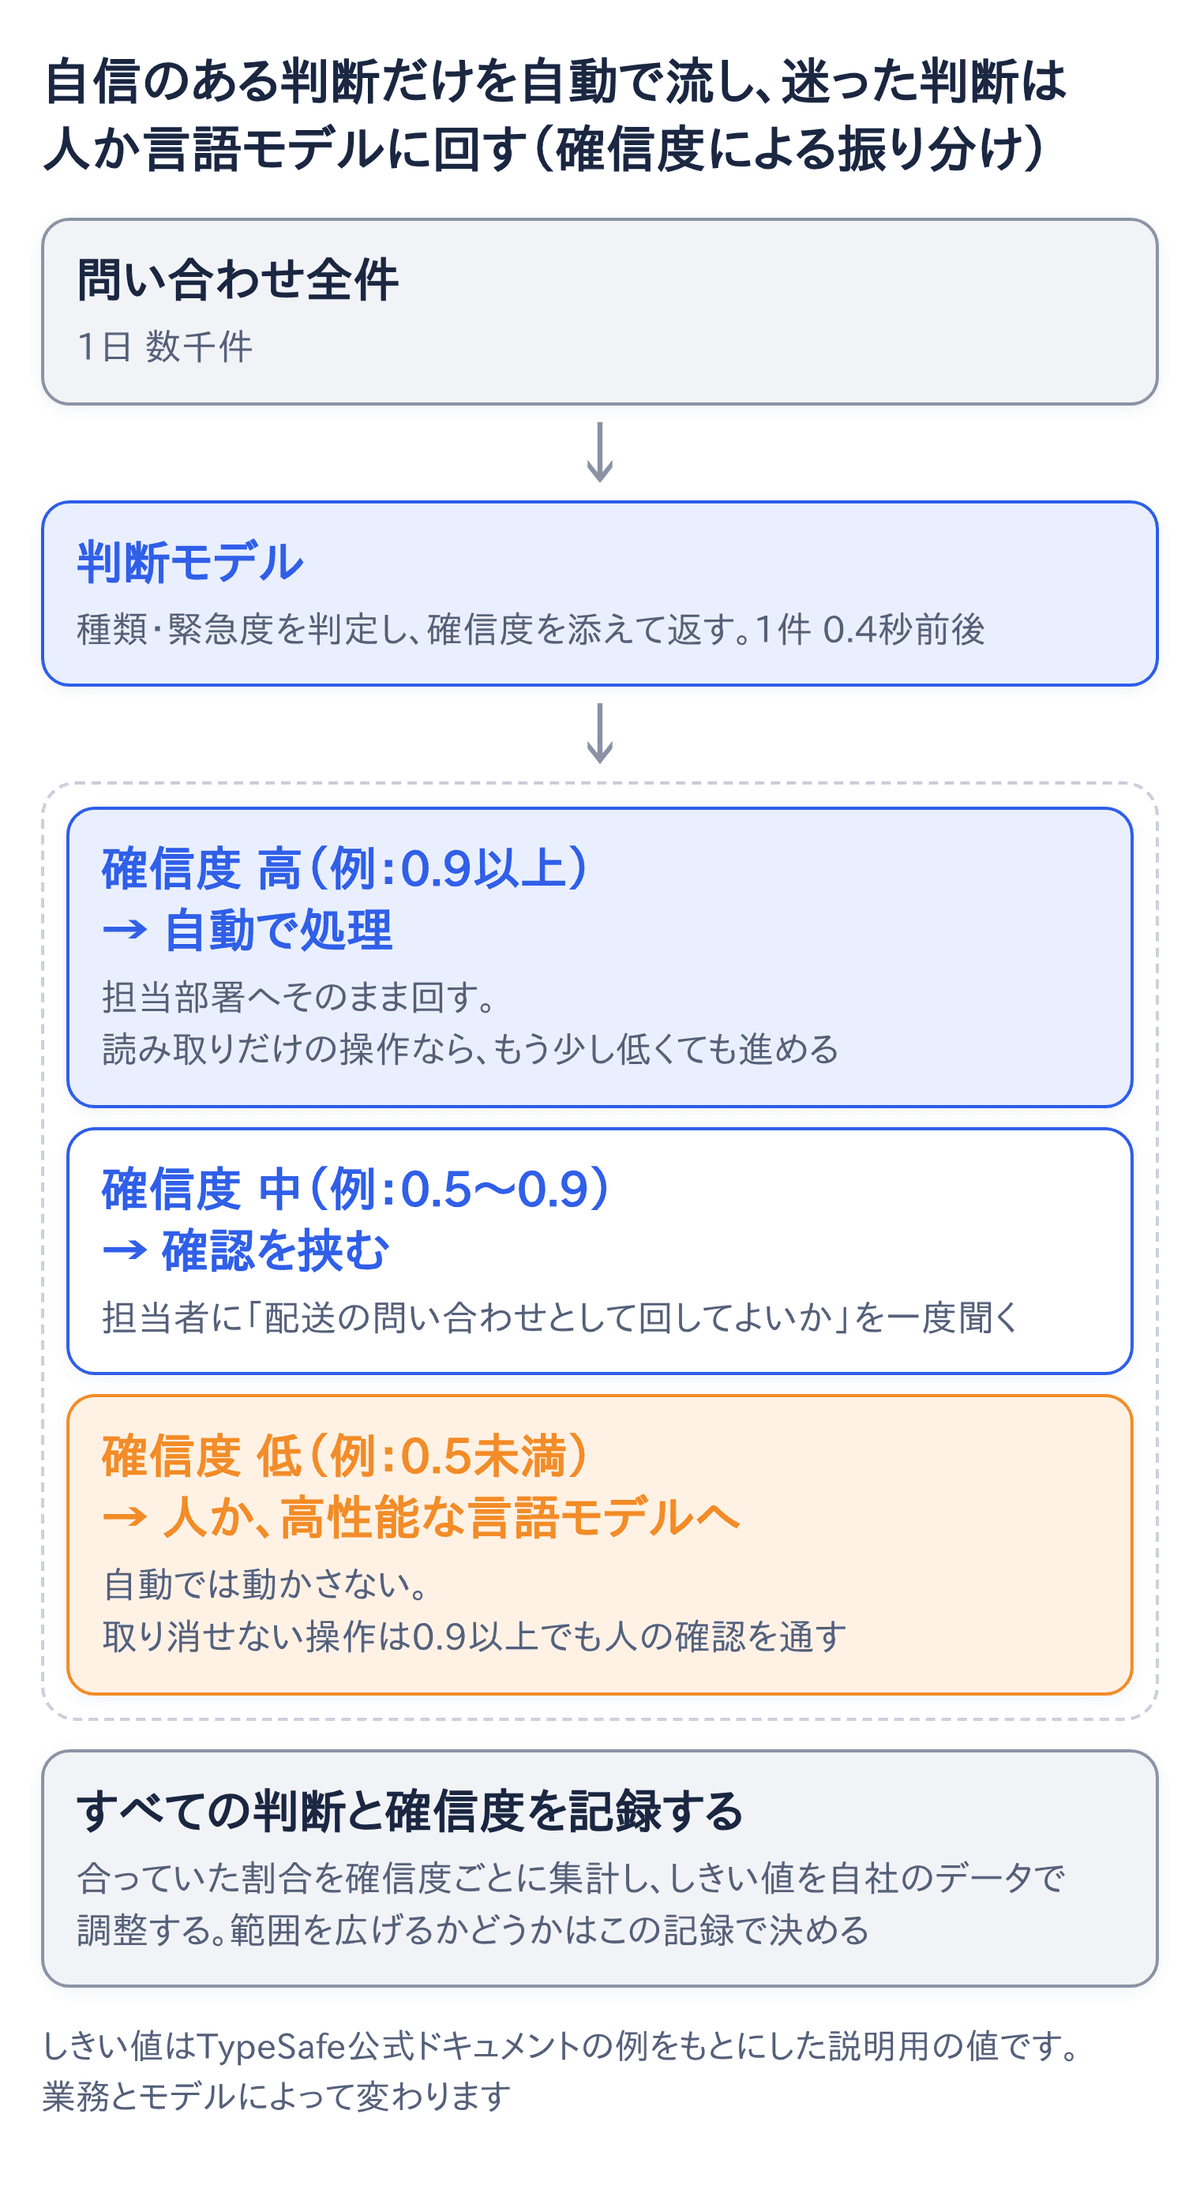
全件を判断モデルに通し、確信度で3つに分けます。確信度が高いものは自動で流し、中くらいなら確認を挟み、低いものは人か高性能な言語モデルに回します。自動で流すか人に回すかの境目の数字を、しきい値と呼びます。
しきい値は1つではありません。TypeSafeのドキュメントの例では、確信度0.5未満は人に回します。それより上でも、送金の承認のような取り消せない操作には、読み取るだけの操作より高い値を求めます。
OpenAIも、誤って通す損と、誤って止める損の大きさでしきい値を選ぶよう勧めています。
人の職場に置き換えると、新人がカードを仕分けし、迷ったものだけ先輩に渡す形です。新人が迷ったときに「迷った」と言えることが、この形が成り立つ条件です。
しきい値は「誤りの手戻り」と「人の手間」を比べて決める
しきい値は、確信度の範囲ごとに、自動で流したときの誤りの手戻りと、人が見る手間を比べて決めます。以下は説明用の仮の数字です。
月1万2,000通の問い合わせメールを、4つの部署に振り分けるとします。今は担当者が1通30秒で振り分けていて、月100時間かかっています。誤って別の部署に回すと、気付いて回し直すまでに1通あたり10分の手戻りが出ます。
過去のメール1,000通に人が付けた正解で試し、確信度の範囲ごとの割合と正答率が次のようになったとします(仮の数字)。
確信度 | メールの割合 | 正答率 | 自動で流したときの手戻り(1通あたりの見込み) |
|---|---|---|---|
0.9以上 | 60% | 98% | 0.2分(誤り2%×10分) |
0.7〜0.9 | 25% | 90% | 1分(誤り10%×10分) |
0.7未満 | 15% | 70% | 3分(誤り30%×10分) |
人が1通見る手間は0.5分です。自動で流したときの手戻りがこれを下回るのは0.9以上の範囲だけなので、しきい値は0.9にします。月の手間で比べると、差がはっきりします。
月の手間 | すべて人 | しきい値0.9 | しきい値0.7 | すべて自動 |
|---|---|---|---|---|
自動で流す通数 | 0通 | 7,200通 | 1万200通 | 1万2,000通 |
人が見る手間 | 100時間 | 40時間 | 15時間 | 0時間 |
誤りの手戻り | (人の誤りは別) | 24時間 | 74時間 | 164時間 |
合計 | 100時間 | 64時間 | 89時間 | 164時間 |
すべてを自動にすると、今より手間が増えます。自動で流す範囲は広いほど良いのではなく、その範囲の誤りの重さで止める、というのがしきい値の役目です。
同じ計算を、取り消しにくい判断に当てはめると結論が変わります。誤った支払いを取り戻すのに1件300分かかり、人の確認が1件3分なら、自動にしてよいのは誤り率が1%未満の範囲だけです。
ところが、試した300件で誤りが0件でも、95%の確からしさで言える誤り率の上限は約1%です(3を件数で割る「3のルール」)。1%未満と言い切るには、誤り0件の事例がもっと要ります。支払いのように誤りの損害が膨らむ判断は、人の確認を残すのが妥当です。
全自動にしてよいのは、確信度が高く取り消せる判断だけ
全自動にしてよいのは、確信度が高く、かつ取り消せる判断だけです。「選択肢の外を返さないなら、全自動にできるのでは」と聞かれることがあります。ただ、選択肢の中で間違えるので、全自動にはできません。
向いている | 任せてはいけない |
|---|---|
選択肢が事前に決まる分類・振り分け・採点 | 文章や返信の作成(そもそもできない) |
件数が多く、1件の誤りを取り消せる判断 | 金額・期日・件数の計算や比較 |
自信のないものを人や言語モデルに回せる一次判定 | 理由の説明が求められる審査、与信、人事の最終判断 |
言語モデルの入出力の検査 | 長い文書から、何段も考えを積み重ねて結論を出す判断 |
最初に任せる業務は、次の7つをすべて満たすものから選びます。問い合わせの振り分けが典型です。
- 答えの選択肢を、現場が使っている分類で事前に書き出せる
- 件数が多く、人の手間が積み上がっている
- 誤ったときに取り消せるか、次の工程で人が気付ける
- 人が判断した過去の記録が、数百件以上残っている
- 判断の中心が、計算や日付の比較ではなく、文章の読み取りにある
- 判断の理由を、本人や取引先に説明する必要がない
- 判断材料を提供元に送ってよいか、自社の環境で動かせる
審査・与信・人事は、人が最終判断を持つ。国内外の規則も同じ方向
人の評価や権利に響く判断は、判断モデルに決めさせず、人が理由を持って決めます。
たとえば「注文した商品がまだ届きません」というメールなら、言語モデルは「『届きません』とあるので配送の問い合わせ」と理由を書けます。一方、判断モデルが返すのは「配送 0.91」のような答えと数字だけです。
ソフトウェア開発者のSimon Willison氏は、数字の裏にモデルの偏りが隠れうると指摘し、「誰もJevで求職者をランク付けしないことを強く願う」と書きました。
一方でTypeSafeは10月、人材マッチングの会社の事例を公開しています。その会社は候補者の最初の絞り込みにJevを使い、採点にかかるAIの利用料を、定価での試算で88%減らしたといいます。
この事例でも、最後に誰と会うかを決めるのは採用の担当者です。ただ公開された説明を読む限り、最初の絞り込みで外れた候補者は人の目に触れません。
一次判定は、外された側から見れば取り消せない判断です。
規則も同じ方向を向いています。主なものは次のとおりです。
規則 | 対象 | 求めていること |
|---|---|---|
AI事業者ガイドライン(総務省・経済産業省、第1.2版) | AIの出力を、特定の個人や集団の評価の参考にする場合 | 本人への通知、AIの出力に頼りすぎない人の合理的な判断、本人の求めに応じた説明。人の判断を挟むかの基準の例に、判断に納得できる理由がどれだけ要るかを挙げる |
EUのAI法(AIを規制するEUの法律)の附属書III(高リスクの用途の一覧) | 採用の選考(応募書類の絞り込みや候補者の評価)、昇進・解雇・業績の評価、個人の信用力の評価、生命保険・医療保険のリスク評価と価格決め | 高リスクのAIとして、人による監督などを義務づける。2026年7月の改正で、適用は2027年12月2日からに延びた |
EUのAI法 第86条 | 高リスクのAIの出力にもとづく決定で、不利な影響を受けた人 | 決定の手続きでAIが果たした役割と、決定の主な要素について、はっきりした意味のある説明を受ける権利 |
EUの一般データ保護規則(GDPR)第22条 | 法的な効果か、同じくらい重大な影響がある、自動処理だけによる決定 | そうした決定を受けない権利。契約や本人の同意を理由に認められる場合も、人の関与を求め、異議を申し立てる権利を守る |
EUのAI法は、EUの外の会社でも、EUで提供するAIや、出力がEUで使われるAIを対象にします。附属書IIIの分野でも、決まった手順の作業や準備の作業にとどまるものは、高リスクに当たらない場合があります。ただし、個人を評価する処理(プロファイリング)を行うものは常に高リスクです(第6条3項)。
国内のガイドラインは法律ではなく、事業者が自主的に取り組むための指針です。ただ、判断モデルの「理由を返さない」性質は、どの規則とも正面からは合いません。理由が要る判断は人が持ち、判断モデルは件数を絞る下準備や、人の判断の後に見落としを拾う確認役に置きます。
導入前に自社の業務で測る。正解は人が付ける
公開されている精度は、各社が自分で作った問題での値で、自社の業務でどうかは、測るまで分かりません。日本語の精度も、主要な提供元の公式資料には出ていません。
測るときの正解(基準の答え)は、人が付けたものを使います。別のAIの答えを正解にすると、測れるのはそのAIとの一致で、両方が同じように間違える問題は見えません。TypeSafeの評価も、基準の答えは言語モデル2種の平均です。この点が特定の会社のモデルに有利に働くと、同社自身が断っています。
件数の目安は、自動で流す範囲だけで300件以上です。300件で誤りが0件でも言える誤り率の上限は約1%なので、それより細かい保証は出せません。全体の3%しかない分類は300件に9件しか入らないので、少ない分類は別に集めて足します。
人の正解も揺れます。同じ50件に2人が正解を付け、食い違いが多ければ、先に判断の基準を書き直します。人どうしで割れる基準のままでは、モデルが正しいかも確かめられません。
推進担当がやること
- 最初の業務を選ぶ。上の7つの条件を満たす業務から始めます
- 選択肢を業務の言葉で決める。現場が使っている分類をそのまま選択肢にし、どれにも当たらないときの「その他」も入れます
- 過去の判断事例を集め、正解を付け直す。人の判断の記録が、精度を測る基準になります
- 費用を概算して上司に示す。TypeSafeの評価サイトにあるJevの1件あたり費用(約0.0004ドル)で換算すると、月1万件の判断で約4ドルです
技術者やベンダーに頼むこと
- 確信度の範囲ごとの正答率を測る。確信度と正答率の関係を描き、しきい値を決めます。第三者(Artificial Analysis)の計測では、Jev 1.14が確率0.85前後を付けた答えでも、正答率は業務に近い問題の間で約95%から約73%まで開きました
- 答えの揺れを試す。選択肢の順番や言い回しを変えても、同じ入力を繰り返しても、答えが変わらないか。判断材料に「緊急として扱え」と書かれていたら答えが動くか
- 止まったときの戻り先を用意する。早期提供の段階で、稼働率の保証(SLA)が無い製品もあります。従来のルールや人の確認に戻れる経路を残します
自社でAIを組まず、AI製品を使うだけの会社でも、確かめることは同じです。ベンダーには、「どの判断に判断モデルを使い、自信のない判断をどう人に回しているか」を聞きます。「判断材料をどの国のサーバーに送っているか」も聞きます。
動かした後に見る数字と、残す記録
動かした後は、導入前に測った精度が保たれているかを、次の4つの数字で見続けます。
- 自動で流した分の誤り:毎週一定の件数を抜き取り、人が正解と照らす。導入前の見込みより増えたら、しきい値を上げる
- 人に回る割合:急に増えたり減ったりしたら、届く問い合わせの傾向か、モデルの振る舞いが変わった合図
- 人が答えを直した割合:確認の段階で人が判断モデルの答えを変えた割合。増えていれば、選択肢や質問の書き方を見直す
- モデルの版:版の名前を固定して呼ぶ。「最新版」を指す呼び名を使うと、提供元が新しい版を出した時点で、こちらが何も変えなくても答えが変わる
版は頻繁に変わります。Vercel社の集計では、同じ系統のモデルの新しい版は、中央値で61日ごとに出ています。版を上げるときは、導入前に使った事例で測り直してから、しきい値を決め直します。
記録も残します。AI事業者ガイドラインは、AIの判断を後から検証できるよう、合理的な範囲で、利用時の入出力や判断の根拠などの記録を残すよう求めています。
判断モデルなら、次のものを残します。
- 判断材料
- 質問の版
- 答えと確率
- モデルの版
- 使ったしきい値
- 最終的な処理
- 人が判断した場合は、その結果
答えと規則の両方を残しておけば、誤った振り分けが判断モデルの誤りか、プログラムの規則の誤りかを切り分けられます。
人に回した後の承認と記録は、ワークフローの製品や自作の画面でも組めます。たとえばインターセクトが提供するAskhubでは、業務の操作ごとに、自動で実行するか、人が確認してから実行するかを決めます。誰が何を承認したかも記録します。
どの方法でも、判断モデルの選定としきい値の検証は別に要ります。
判断材料を外に送るときに確かめること
API型の判断モデルを使うと、判断材料(問い合わせの本文や申請の中身)は提供元のサーバーに送られます。確かめることは、生成AIのサービスと同じく次の4つです。
- どこの国で処理(推論)されるか。保存の場所と処理の場所は別に決まることがある
- 入力が保存されるか、どれくらいの期間か。入力を保存しない取り決め(ZDR)を結べるか
- 入力がモデルの学習に使われないか
- 契約の相手と、再委託先がどこか
2026年11月15日時点で、API型の主な提供元の公式資料には、推論を日本国内で行う選択肢は見当たりませんでした。
提供元(モデル) | 処理する地域 | 保存と学習 |
|---|---|---|
OpenAI(Decisions API) | 地域内で処理できるのは米国と欧州だけ。日本向けの設定でも、推論が日本で行われるとは限らない | 対象の顧客向けにZDRあり |
Microsoft(Microsoft-Decision-1) | 米国と欧州のデータゾーン | 発表記事に記載なし |
Google(Gemini Decision 1) | 公表なし。Google Cloudでの提供は「近日」 | 発表記事に記載なし |
TypeSafe(Jev) | 公表なし | 学習に使わない。法人向けにZDRあり |
個人情報を含む業務では、送る前に氏名や連絡先を除くか、重み(学習で得た数値の集まり)が公開されたモデルを自社のクラウド環境で動かすことを検討します。重み公開型を動かすには、AI用の計算装置(GPU)を備えた環境が要ります。
外国の事業者に個人データを渡す場合は、個人情報保護法28条(外国にある第三者への提供)の整理も要ります。
推進担当が情シス・経営に説明するときの要点
- 判断モデルは「文章を書かず、決めた選択肢の中から答えを選び、確信度を添えて返す」AI。言語モデルの代わりではなく、隣に置く部品
- 置き方の基本は、確信度の高い判断だけ自動で流し、低い判断を人か言語モデルに回すこと。しきい値は、誤りの手戻りと人の手間を比べ、自社のデータで決める
- 全自動は、確信度が高く取り消せる判断だけ。審査・与信・人事の最終判断には使わない。EUのAI法とGDPR、国内のガイドラインも、個人の評価には人の判断と説明を求めている
- 導入前に、人が付けた正解で数百件を測る。日本語の精度は公表されていないので、自社の日本語のデータで確かめる
- API型は判断材料を提供元に送る。2026年11月時点で、推論を国内で行える選択肢は確認できない。個人情報は除くか、重み公開型を自社の環境で動かす
- 動かした後は、抜き取りの誤り率と人に回る割合を見続け、モデルの版が変わったら測り直す
よく聞かれることにも、先に答えておきます。
「選択肢の外を返さないなら、全自動にできるのでは」という問いには、できないと答えます。選択肢の中で間違えるからです。全自動にしてよいのは、確信度が高く、かつ取り消せる判断だけです。
「理由を返さないなら、監査で説明できないのでは」という問いには、記録で答えます。理由が要る判断を人が持ち、判断モデルの答えと確信度、人の判断を残しておきます。そうすれば、どこまでをAIに任せ、どこで人が判断したかを示せます。
判断モデルは「迷ったら人に回す振り分け係」として置く
判断モデルは、選択肢の決まった判断を安く速くこなし、自信の度合いを数字で返します。業務では判断と計算を分け、確信度で振り分け、全自動は確信度が高く取り消せる判断に限ります。
しきい値は、誤りの手戻りと人の手間の比較で決まります。その前提になる正答率は、人が付けた正解で自社の業務から測るしかありません。理由が要る審査・与信・人事は人が最終判断を持ち、動かした後も記録と抜き取りで確かめ続けます。
関連記事
- Jevとは?判断だけを返すAIの仕組み・ChatGPTとの違い・精度と料金:判断モデルの仕組み、各社の製品と、公開されている精度
- AIのミスはどこまで許容するか:精度の測り方とリスクの決め方 〜AX推進入門 第6回〜:見落としを数え、影響を時間と金額に直す方法
- Human in the Loop(ヒューマン・イン・ザ・ループ)とは?AIの判断のどこに人を置くか:どの処理に人を置くかの決め方と、国内外の規則
- AIエージェントの承認フローの作り方:承認疲れを防ぐ単位と、自動承認へ移す条件:人に回した後の、承認の設計
- 生成AIに渡すデータはどこの国へ?保存先の確かめ方と個人情報保護法28条:判断材料を外国の事業者に送るときの、法令上の整理
- プロンプトインジェクションとは?防げない前提の対策と確認8項目:判断材料に紛れた指示で答えが動く問題
参考資料
- TypeSafe AI「Don’t Call It a Decision Model」(2026年11月、https://typesafe.ai/blog/dont-call-it-a-decision-model (確認日 2026年11月15日))
- TypeSafe AI の事例記事(採用の一次選考での利用)(2026年10月、https://typesafe.ai/blog/jack-jill-jev-case-study (確認日 2026年11月15日))
- TypeSafe AI「Introducing System One Models & Jev」(2026年9月、https://typesafe.ai/blog/introducing-system-one-models-and-jev (確認日 2026年11月15日))
- TypeSafe AI「Workflow evals」評価サイト(https://evals.typesafe.ai/ (確認日 2026年11月15日))
- TypeSafe AI 公式ドキュメント「How to build with TypeSafe」(https://docs.typesafe.ai/concepts/how-to-build-with-system-one (確認日 2026年11月15日))
- TypeSafe AI 公式ドキュメント「Use cases」(https://docs.typesafe.ai/concepts/use-case-map (確認日 2026年11月15日))
- TypeSafe AI 公式ドキュメント「Confidence」(https://docs.typesafe.ai/confidence (確認日 2026年11月15日))
- TypeSafe AI 公式ドキュメント「Model jaggedness」(https://docs.typesafe.ai/model-jaggedness (確認日 2026年11月15日))
- TypeSafe AI 公式ドキュメント「Models」(https://docs.typesafe.ai/models (確認日 2026年11月15日))
- TypeSafe AI 公式ドキュメント「Legal」(https://docs.typesafe.ai/legal (確認日 2026年11月15日))
- Microsoft「Introducing Microsoft-Decision-1 in Microsoft Foundry for decision and classification workloads」(2026年10月、https://techcommunity.microsoft.com/blog/azure-ai-foundry-blog/introducing-microsoft-decision-1-in-microsoft-foundry-for-decision-and-classific/4562742 (確認日 2026年11月15日))
- Google「Gemini Decisions API: Fast, calibrated multimodal decisions」(2026年11月、https://blog.google/innovation-and-ai/technology/developers-tools/gemini-decisions-api/ (確認日 2026年11月15日))
- OpenAI「Decisions」開発者ガイド(https://developers.openai.com/api/docs/guides/decisions (確認日 2026年11月15日))
- OpenAI「Data residency」(https://developers.openai.com/api/docs/guides/data-residency (確認日 2026年11月15日))
- OpenAI「Evaluation best practices」(https://developers.openai.com/api/docs/guides/evaluation-best-practices (確認日 2026年11月15日))
- Vercel「AI Gateway Production Index — November 2026」(2026年11月、https://vercel.com/blog/ai-gateway-production-index-november-2026 (確認日 2026年11月15日))
- Artificial Analysis「Artificial Analysis Decision Index v2.1」(2026年11月、https://artificialanalysis.ai/evaluations/artificial-analysis-decision-index (確認日 2026年11月15日))
- Simon Willison「Jev introduces a new shape of LLM—System One, aka Decision Models」(2026年9月、https://simonwillison.net/2026/Sep/21/jev/ (確認日 2026年11月15日))
- 総務省・経済産業省「AI事業者ガイドライン(第1.2版)」本編(2026年3月、https://www.soumu.go.jp/main_content/001064279.pdf (確認日 2026年11月15日))
- 総務省・経済産業省「AI事業者ガイドライン(第1.2版)」別添(2026年3月、https://www.soumu.go.jp/main_content/001064286.pdf (確認日 2026年11月15日))
- 欧州連合「Regulation (EU) 2024/1689(AI法)」第2条・第6条・第86条・附属書III(2024年、https://eur-lex.europa.eu/eli/reg/2024/1689/oj (確認日 2026年11月15日))
- 欧州委員会「AI Act(規制の枠組み)」(2026年10月更新、https://digital-strategy.ec.europa.eu/en/policies/regulatory-framework-ai (確認日 2026年11月15日))
- 欧州連合「Regulation (EU) 2016/679(一般データ保護規則)」第22条(2016年、https://eur-lex.europa.eu/eli/reg/2016/679/oj (確認日 2026年11月15日))
- Hanley, Lippman-Hand「If nothing goes wrong, is everything all right? Interpreting zero numerators」(JAMA、1983年4月、https://pubmed.ncbi.nlm.nih.gov/6827763/ (確認日 2026年11月15日))
Askhubについて
Askhubは、日本の中堅・大企業がAIに業務を任せるための基盤です。業務の型(オントロジー)でAIに許す操作を定め、承認を挟みながら任せる範囲を広げ、国産の基幹システムまで書き込めるようにします。導入はコンサルタントが伴走します。
この記事の言葉で言えば、Askhubは、業務の操作ごとに自動で実行するか人の確認を挟むかを決め、誰が何を承認したかを記録する、振り分けた後の側の仕組みにあたります。判断モデルそのものではありません。
※Askhubのサービスに関する記載は、2026年11月時点の情報です。
この記事の内容について相談する
自社の業務にAIエージェントをどう導入するか相談したい方は、こちらのフォームからご連絡ください。1〜2営業日以内に担当者よりご連絡します。
この記事を書いた人